


Judul asli: (DeepSeek menjalin kerja sama dengan Unitree: ketika kecerdasan menjadi murah sampai-sampai bisa terbuang)
Penulis asli: Observasi Beating
Perubahan teknis yang benar-benar mulai mengubah dunia, biasanya terjadi ketika teknologinya menjadi cukup murah sehingga bisa terbuang.
Belakangan ini, bahkan media luar negeri mulai mempelajari satu istilah yang sangat khas internet Tiongkok: garis pembunuh, zhan shaxian.
31 Juli, pembaruan DeepSeek V4 Flash. Pada grafik bidang koordinat di Artificial Analysis yang membandingkan level kecerdasan model dan biaya penggunaannya secara bersamaan, semakin ke atas pada sumbu-Y berarti model semakin cerdas; semakin ke kanan pada sumbu-X berarti biaya pemanggilan semakin tinggi. Indeks kecerdasan V4 Flash mencapai 50 poin, sudah menempel di kelompok papan atas global; namun biaya rata-rata untuk satu putaran pengujian hanya 3 sen dolar. Titik itu hampir didorong sampai ke pojok kiri-atas pada sistem koordinat. Model yang lebih murah darinya, kemampuannya sebagian besar tidak sebanding; model yang lebih cerdas darinya, umumnya jauh lebih mahal.
Sekarang, jika sebuah model tidak jauh lebih kuat daripada DeepSeek, semakin sulit menjelaskan mengapa ia harus dibanderol puluhan kali lebih mahal. Internet Tiongkok menyebut batas ini “death line” (garis pemenggal). Beberapa hari kemudian, Bloomberg membahas tekanan harga model Tiongkok terhadap perusahaan AI di Amerika, dan judulnya bahkan langsung memakai “Death Zone”.
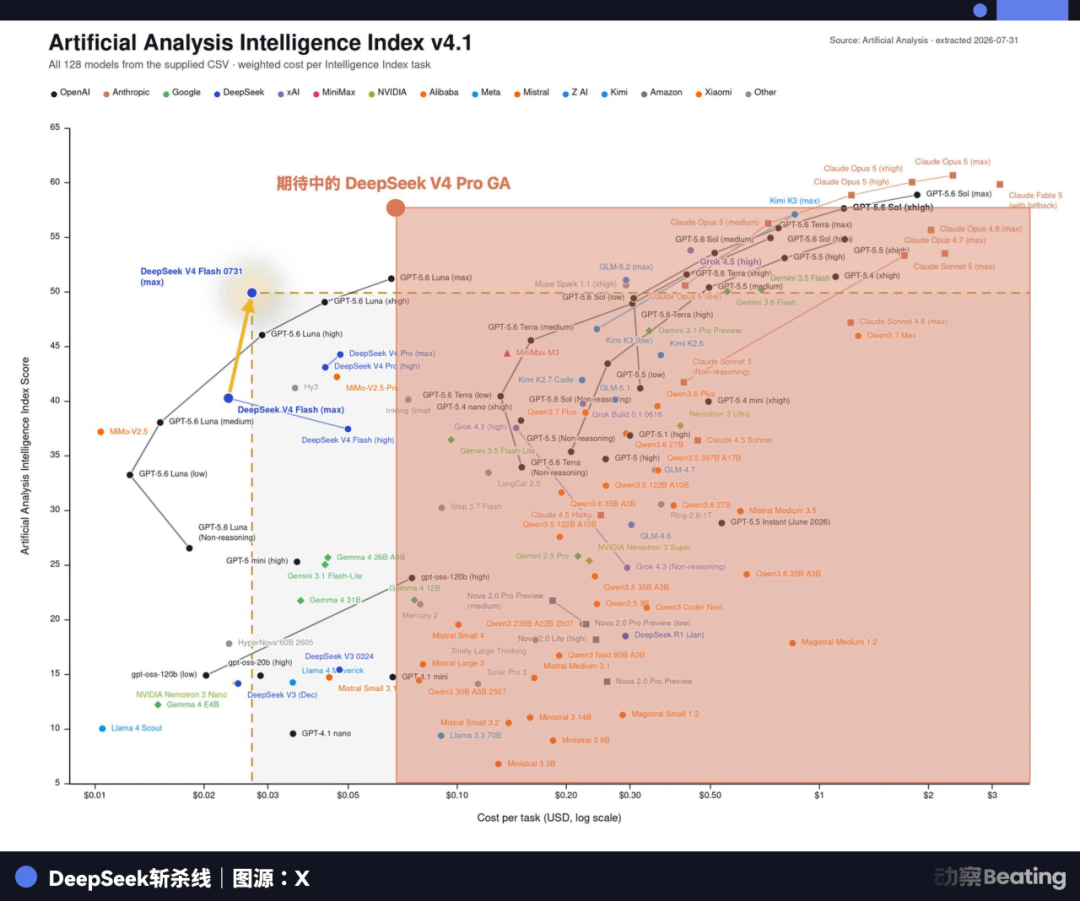
Sejak V2 pada 2024, DeepSeek terus menekan biaya yang diperlukan untuk “memikirkan satu kali”. Tugas yang bisa diselesaikan model makin kompleks, tetapi harga tidak pernah ikut melonjak seiring kemampuan. Dalam dua tahun terakhir, industri model besar terbiasa membicarakan kemajuan dengan parameter lebih besar, konteks lebih panjang, dan Benchmark yang lebih tinggi. DeepSeek terus mengejar standar lain: kecerdasan yang sama, bisakah biaya ditekan lebih sedikit?
Di sisi lain Hangzhou, Wang Xingxing melakukan hal lain yang serupa selama lebih dari sepuluh tahun.
Saat ia masih membaca untuk gelar pascasarjana, mengerjakan XDog, dari awal memang tidak ada uang yang bisa dibakar. Sistem hidrolik yang mahal tidak terjangkau, jadi ia meneliti motor listrik berbiaya rendah. Rencana matang tidak bisa dibeli, jadi ia menggambar papan penggerak sendiri, menulis program, dan merangkai sistem kontrol. Banyak pilihan teknis yang hari ini sudah menjadi standar produk Unitree, dari awal pun dibawa oleh kebiasaan rekayasa yang sangat polos: jangan dulu tanya bagaimana biasanya dilakukan di industri; lihat dulu apakah ada cara yang lebih murah.
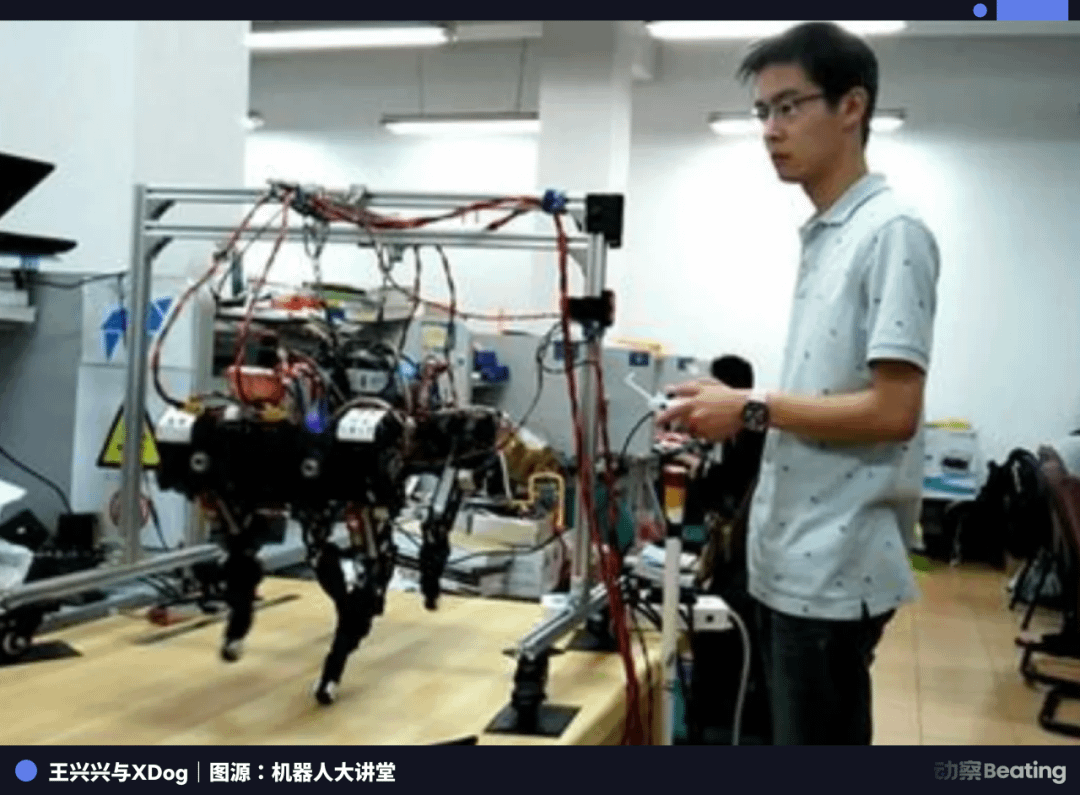
Belakangan, Wang Xingxing mengingat: pada 2010 saat membuat robot biped, bagian mekanisnya total hanya menghabiskan 200 yuan. Bertahun-tahun kemudian ada orang bertanya apakah Unitree masih bisa terus menurunkan biaya. Ia menjawab: “Jangan bandingkan kami soal menurunkan biaya. Kami bisa terus menurunkan banyak sekali.”
Satu perusahaan sedang menurunkan harga berpikir; satu perusahaan sedang menurunkan harga bertindak. Dalam waktu yang lama, meski mereka sama-sama ada di Hangzhou, mereka tetap berjalan di jalur masing-masing.
Sampai tanggal 6 Agustus.
Unitree mengumumkan hasil alokasi penjatahan strategi IPO di papan Kechuang. DeepSeek menyiapkan 140,8 juta yuan untuk membeli saham baru Unitree. Rencana kerja sama yang diungkapkan kedua belah pihak juga cukup langsung: ketika Unitree membutuhkan layanan pelatihan model dan solusi teknis, DeepSeek diprioritaskan; ketika DeepSeek membutuhkan robot dan eksplorasi aplikasi kecerdasan yang terwujud (embodied intelligence), Unitree diprioritaskan.
Uang ini jika ditempatkan di industri AI saat ini pun tidak terlalu mengejutkan. Yang benar-benar menarik adalah, dua pihak yang selama belasan tahun terus berusaha membuat teknologi mahal menjadi semurah sayur, untuk pertama kalinya menyatukan kurva biaya mereka. Maka muncul pertanyaan yang lebih patut ditelusuri daripada “model besar akhirnya tersambung ke tubuh robot”:
Kalau biaya agar mesin berpikir dan biaya agar mesin bertindak terus turun bersamaan, AI akhirnya akan menjadi seperti apa?
Jawabannya mungkin tidak hanya “lebih banyak orang mampu membelinya”.
Perubahannya yang lebih besar adalah kita mulai tidak lagi terlalu menyayanginya.
Dua algojo harga.
Bagian yang paling mirip pada Liang Wenfeng dan Wang Xingxing adalah mereka berdua tidak terlalu percaya pada harga murah yang ditukar dengan subsidi. Daftar harga tentu bisa diubah dalam semalam, tetapi bulu berasal dari domba; harga rendah seperti itu biasanya tidak sanggup bertahan lama. Kalau barang itu benar-benar mau dijual murah dalam jangka panjang, pada akhirnya tetap harus kembali ke bidang rekayasa: memecah biaya-biaya yang awalnya dianggap wajar, selapis demi selapis.
DeepSeek-V2 adalah contoh paling tipikal. Setelah model diumumkan pada 2024, industri model besar di dalam negeri segera diseret ke perang harga. Yang paling mudah terlihat oleh pihak luar adalah tarif API, tetapi yang benar-benar menopang penurunan harga disembunyikan di dalam struktur model. V2 memiliki total parameter 236 miliar; untuk setiap token, yang benar-benar diaktifkan hanya 21 miliar. Dibanding generasi sebelumnya, biaya pelatihan turun 42,5%, KV Cache berkurang 93,3%, dan throughput generasi maksimum meningkat menjadi 5,76 kali.
Sampai ke V3, pemikiran ini didorong lebih jauh lagi. Model menjadi lebih besar: pelatihan resmi menghabiskan 2,788 juta jam GPU H800. DeepSeek kemudian mengoptimalkan efisiensi lagi melalui mixture of experts, pelatihan presisi rendah, dan optimasi komunikasi.
Cara pandang biaya seperti ini bahkan kemudian mulai membentuk definisi produk secara terbalik.
Pada bulan Mei tahun ini, DeepSeek mengubah diskon promosi 75% untuk V4-Pro menjadi harga permanen secara langsung, sementara segmen andalannya terus ditekan ke bawah. Liang Wenfeng sebelumnya pernah menjelaskan prinsip penetapan harga mereka: berdasarkan biaya riil, tidak menempel uang dalam jangka panjang, dan tidak mengejar laba super besar.
Pemahaman Wang Xingxing tentang robot hampir sama.
Dalam wawancara (Waktunya sudah terlambat) tahun 2025, ditanyakan: Dulu H1 dijual 90 ribu dolar, lalu versi G1 dengan spesifikasi lebih rendah yang lebih fleksibel, harga awalnya tinggal 99 ribu yuan. Dengan harga seperti itu, masih apakah menghasilkan untung?
Wang Xingxing menjawab: “Dalam tindakan bisnis pasti harus ada laba bisnis yang wajar. Biaya adalah KPI dari semua hal yang kami kerjakan. Intinya adalah harus menghasilkan uang.”
Hal yang kemudian ia bahas pun sebenarnya tidak banyak pada kalimat yang paling sering terdengar “ketika skalanya naik, pemasok secara otomatis akan menurunkan harga”. Yang benar-benar menentukan batas bawah harga robot adalah bagaimana memilih motor, bagaimana membuat gearbox, berapa banyak komponen yang dipakai untuk satu sendi, apakah sistem lengkap masih bisa dibuat lebih ringan lagi, dan komponen mana yang harus dipegang sendiri.
Cara menurunkan biaya seperti ini punya rasa yang sangat kental dari era industri: satu sen dipecah menjadi dua.
Satu papan sirkuit hilang beberapa sentimeter, satu sendi berkurang dua komponen, satu bundel kabel diganti dengan rute lain—kalau dipisah-pisah, semuanya tidak termasuk terobosan besar. Tapi puluhan perubahan seperti itu ditumpuk bersama, pada akhirnya langsung memengaruhi harga jual.
Perubahan harga di Unitree (宇树) selama beberapa tahun terakhir memang persis seperti itu. Pada 2023, robot humanoid berukuran penuh generasi pertama H1 diluncurkan; tahun itu hanya terjual 5 unit, dengan harga rata-rata 593,4 ribu yuan; pada 2024, G1 yang lebih kecil masuk pasar, penjualan meningkat menjadi 410 unit, harga rata-rata turun menjadi 260,7 ribu yuan; hingga pada sembilan bulan pertama tahun 2025, penjualan robot humanoid mencapai 3.551 unit, dan harga rata-rata kembali turun menjadi 167,6 ribu yuan.
Setiap kali harga turun satu level, para pembeli robot juga akan menyambut gelombang baru. Peralatan 500 hingga 600 ribu yuan memerlukan pengajuan proyek lab, membuat anggaran, dan menjelaskan rencana riset saat membelinya; sementara belasan hingga puluhan ribu yuan sudah bisa masuk ke lebih banyak universitas, tim pengembangan, dan perusahaan.
Banyak teknologi yang benar-benar melewati titik kritis menuju popularitas, selesai di perubahan seperti ini. Dari anggaran khusus menjadi anggaran departemen, lalu dari anggaran departemen menjadi pengadaan biasa. Pada akhirnya, pada suatu hari nanti, orang-orang malas menghitung biaya setiap kali pemakaian.
Teknologi mahal secara alami hanya pantas menyelesaikan masalah mahal. Saat harga jatuh, hal-hal kecil yang dulu sama sekali tidak layak munculnya teknologi, barulah mulai masuk ke dunianya.
Dua kurva biaya akhirnya berpotongan.
Unitree sendiri sedang mengerjakan world model dan VLA, jadi nilai DeepSeek bukan sekadar “menyambungkan otak” ke robot. Yang benar-benar bisa mengaitkan dua perusahaan adalah siklus pelatihan paling mahal yang ada pada embodied intelligence saat ini.
Siklus ini sebagian terjadi di dunia nyata. Robot benar-benar mengulurkan tangan, berjalan, mengambil benda. Manusia atau sistem lain terus memberi contoh, menghasilkan jejak keberhasilan dan kegagalan.
Separuh lainnya terjadi dalam komputasi: data dibersihkan dan diberi label, lalu dimasukkan ke pelatihan model untuk strategi baru. Setelah itu, melalui inferensi dan verifikasi, ia dideploy ulang kembali ke robot. Robot keluar untuk terus mencoba, membawa pulang data baru, dan model belajar lagi. Semakin cepat siklus ini berputar, semakin banyak dunia yang ditemui robot.
Masalahnya, keduanya sama-sama mahal. Robot asli mahal, sehingga tim sulit membiarkan ratusan robot jatuh-bangun terus-menerus di laboratorium; pelatihan dan inferensi mahal, sehingga data yang diambil lalu tidak terlihat nilainya pun sulit untuk dilatih dan diverifikasi berulang-ulang.
Jadi, eksperimen robot di masa lalu selalu terasa sangat berharga. Hanya ada beberapa mesin; data apa yang mau diambil hari ini harus dipikirkan dulu. Hanya ada segitu banyak komputasi; lintasan batch itu bernilai untuk dijalankan lagi atau tidak juga harus dihitung jari. Karena sumber daya semakin mahal, para peneliti cenderung memilih masalah yang terlihat paling bernilai dan peluang keberhasilannya paling tinggi.
Namun kenyataannya dunia tidak seperti itu.
Apa bedanya gelas yang diletakkan 3 sentimeter dari tepi meja dengan 5 sentimeter; setelah handuk setengah basah, harus mengambil dari mana; saat laci macet, apakah harus mendorong lagi atau mundur sedikit dulu; bagaimana menyesuaikan lengan saat memasukkan satu apel dan tiga apel ke dalam kantong plastik. Hal-hal ini jika dipisahkan satu per satu tidak ada yang layak mengadakan konferensi peluncuran, bahkan sulit juga dianggap layak untuk sebuah proyek pengajuan khusus di laboratorium. Tapi ketika robot masuk ke rumah tangga, restoran, gudang, dan kantor, dunia yang dihadapinya setiap hari justru dibentuk oleh problem-problem sepele yang dari dulu sampai sekarang bikin muak.
Saat melihat kerja sama DeepSeek dan Unitree sekarang, alurnya jadi jauh lebih jelas.
Unitree menekan biaya bagian depan ke bawah, sehingga lebih banyak robot fisik bisa masuk ke laboratorium, tim pengembangan, dan skenario nyata. DeepSeek, untuk jangka panjang, menyelesaikan masalah bagian belakang: membuat pelatihan model, inferensi, dan verifikasi makin murah.
Kebanyakan lintasan terakhir tidak masuk ke produk; kebanyakan eksperimen juga tidak menghasilkan berita. Ada beberapa robot yang melakukan kesalahan menangkap gelas seratus kali berturut-turut; satu tumpukan data mahal selesai dijalankan, dan mungkin hanya membuktikan bahwa gagasan awalnya ternyata benar-benar tidak berdiri.
Saat sumber daya mahal, hal-hal itu disebut “membuang uang”. Ketika biaya cukup rendah, barulah mereka punya hak untuk disebut sebagai pengalaman.
Ponsel dibuat sedikit lebih murah artinya lebih banyak orang bisa membelinya; robot dibuat sedikit lebih murah artinya ia sendiri bisa memiliki lebih banyak waktu yang tidak menghasilkan pekerjaan—di laboratorium berlatih satu sore, melakukan beberapa gerakan yang pada akhirnya bahkan tidak akan dipakai, masuk ke lebih banyak lingkungan aneh, bertemu lebih banyak kondisi yang sebelumnya tidak sempat terpikir oleh para insinyur.
Ketika tubuh dan kecerdasan sama-sama menjadi lebih murah, yang pertama mendapat “izin untuk melakukan lebih banyak kesalahan” dalam kecerdasan yang terwujud (embodied intelligence).
Bagaimana manusia belajar memboroskan teknologi
Hal seperti ini sudah terjadi berkali-kali dalam sejarah teknologi umat manusia.
Pada tahun 1865, ekonom Inggris William Stanley Jevons meneliti mesin uap dan batu bara dan menemukan sesuatu yang tidak intuitif: efisiensi mesin uap terus meningkat, sehingga untuk menyelesaikan satu pekerjaan jumlah batu bara yang harus dibakar makin sedikit, tetapi konsumsi batu bara Inggris justru tidak turun—malah bertambah. Karena ketika tenaga uap menjadi murah, hal-hal yang dulu enggan digunakan pun mulai dipakai. Batu bara yang dihemat oleh peningkatan efisiensi segera “dimakan” oleh lebih banyak kebutuhan baru.
Belakangan orang menyebut fenomena ini “paradoks Jevons”.
Dalam dua tahun terakhir, orang yang memakai AI sebenarnya sudah—sebagian besar—merasakan tahap kebalikannya. Saat model masih mahal, kita dulu belajar bagaimana menghemat kecerdasan. Tim startup membahas pengalaman pengguna di mulut, tetapi product manager tetap harus ingat tabel harga token di kepala: sebuah fitur secara teknis bisa dilakukan, namun pada akhirnya bisa saja dipotong karena “terlalu mahal kalau setiap pengguna harus menjalankan model lima kali lagi”.
Namun ketika teknologi benar-benar masuk ke kehidupan, biasanya perlu melewati satu rintangan lagi: saat ia menjadi semurah itu, kita mulai menggunakannya untuk hal-hal yang tidak terlalu penting.
Tidak ada orang yang sebelum menyalakan lampu ruang tamu menghitung berapa nilai ekonomi yang diciptakan dalam satu jam pencahayaan. Tidak ada pula orang yang karena ponsel mengirim beberapa permintaan jaringan lagi di latar belakang lalu merasa telah menghambur-hamburkan infrastruktur internet raksasa yang luar biasa itu.
Listrik dan jaringan punya biaya. Hanya saja biaya ini sudah turun begitu rendah sehingga tidak lagi layak memutuskan setiap kali pemakaian. Manusia sudah lama jadi sangat boros soal hal-hal ini—dan sama sekali tanpa rasa bersalah.
Kalau suatu hari kecerdasan benar-benar sampai ke sini, hubungan kita dengan AI juga akan ikut berubah. Rapat selesai, sekalian minta model merapikan; setelah artikel selesai ditulis, beberapa model masing-masing mencari kesalahan; bila satu Agent gagal, ganti beberapa jalur dan lanjutkan mencoba; dengan atau tanpa buah kurma, tetap uji tiga kali dulu. Robot merapikan meja: pertama, gelas tertabrak jatuh; kedua, tangan melenceng; ketiga, gerak terlalu lambat—maka datanglah percobaan keempat.
Setelah sebuah teknologi benar-benar populer, orang tidak akan semakin serius menghitung efisiensi pemakaiannya. Bahkan manusia bisa lupa bahwa mereka sedang menggunakannya.
Sampai saat kita tidak lagi menghitung biaya ini
Pada tahun 1911, matematikawan dan filsuf Inggris Alfred North Whitehead menulis satu kalimat dalam (Pengantar Matematika):
“Kemajuan peradaban terletak pada terus memperluas tindakan-tindakan penting yang tidak perlu kita pikirkan untuk dilakukan.”
AI saat ini jelas belum sampai ke situ. Kita masih membahas tugas mana yang layak menggunakan model paling mahal, dan para pengembang masih akan mengganti pemasok karena selisih beberapa yuan per jutaan token. Perusahaan robot juga masih harus, di antara pameran, laboratorium, dan pabrik, mencari skenario yang paling mudah dihitung neracanya. Industri ini masih terasa sangat kental dengan suasana “cobaan sehari-hari” seperti padi, minyak, dan garam.
Dan yang benar-benar mengaitkan investasi sebesar 140,8 juta yuan itu menjadi satu adalah sebuah tagihan yang selama ini jarang muncul dalam pembahasan industri: berapa biaya ketika sebuah mesin melakukan satu kali kesalahan?
Jawaban hari ini masih belum cukup murah. Jadi setiap data dunia nyata harus dikumpulkan dengan serius; setiap putaran pelatihan harus diseleksi; dan setiap robot sebaiknya sesegera mungkin menemukan pekerjaan yang bisa menghasilkan keluaran.
Sampai pada hari ketika kecerdasan benar-benar populer, mungkin tidak akan ada konferensi peluncuran yang mengumumkan datangnya era baru. Kita hanya pelan-pelan menyadari bahwa satu robot yang dilatih menangkap kotak di sudut gudang selama satu sore, gagal sampai 300 kali, sudah tidak lagi dipertanyakan secara khusus; seorang Agent mencoba puluhan jalur untuk menemukan jawaban, dan tak ada yang menatap kalkulasi token seolah menyakitkan; di laboratorium, menambah beberapa robot tidak lagi perlu menulis alasan pembelian untuk setiap unit.
Jadi harga yang benar-benar penting untuk masa depan AI mungkin bukan lagi berapa tepatnya harga satu juta token, dan bukan juga berapa tepatnya harga sebuah robot humanoid. Melainkan kapan akhirnya kita malas menghitung angka-angka itu lagi.
Ketika mesin sudah berpikir lebih banyak, berjalan lebih jauh, dan salah berkali-kali—hingga tidak lagi membuat orang merasa iba, barulah kecerdasan benar-benar berubah dari kemampuan yang mahal menjadi infrastruktur.
Ketika teknologi benar-benar mulai mengubah dunia, biasanya itu terjadi saat biayanya murah sampai bisa dibuang-buang.
DeepSeek sedang membuat biaya berpikir mendekati harga itu, sementara Unitree sedang membuat biaya tubuh mendekati harga itu. Sisanya adalah memastikan mesin memiliki seumur hidup yang cukup murah.
Terjadi karena murah hingga bisa dicoba berulang-ulang; murah hingga bisa terus salah. Kegagalan-kegagalan yang hari ini tampak sama sekali tidak berarti, akhirnya menjadi cukup banyak untuk membentuk kecerdasan.
Tautan asli