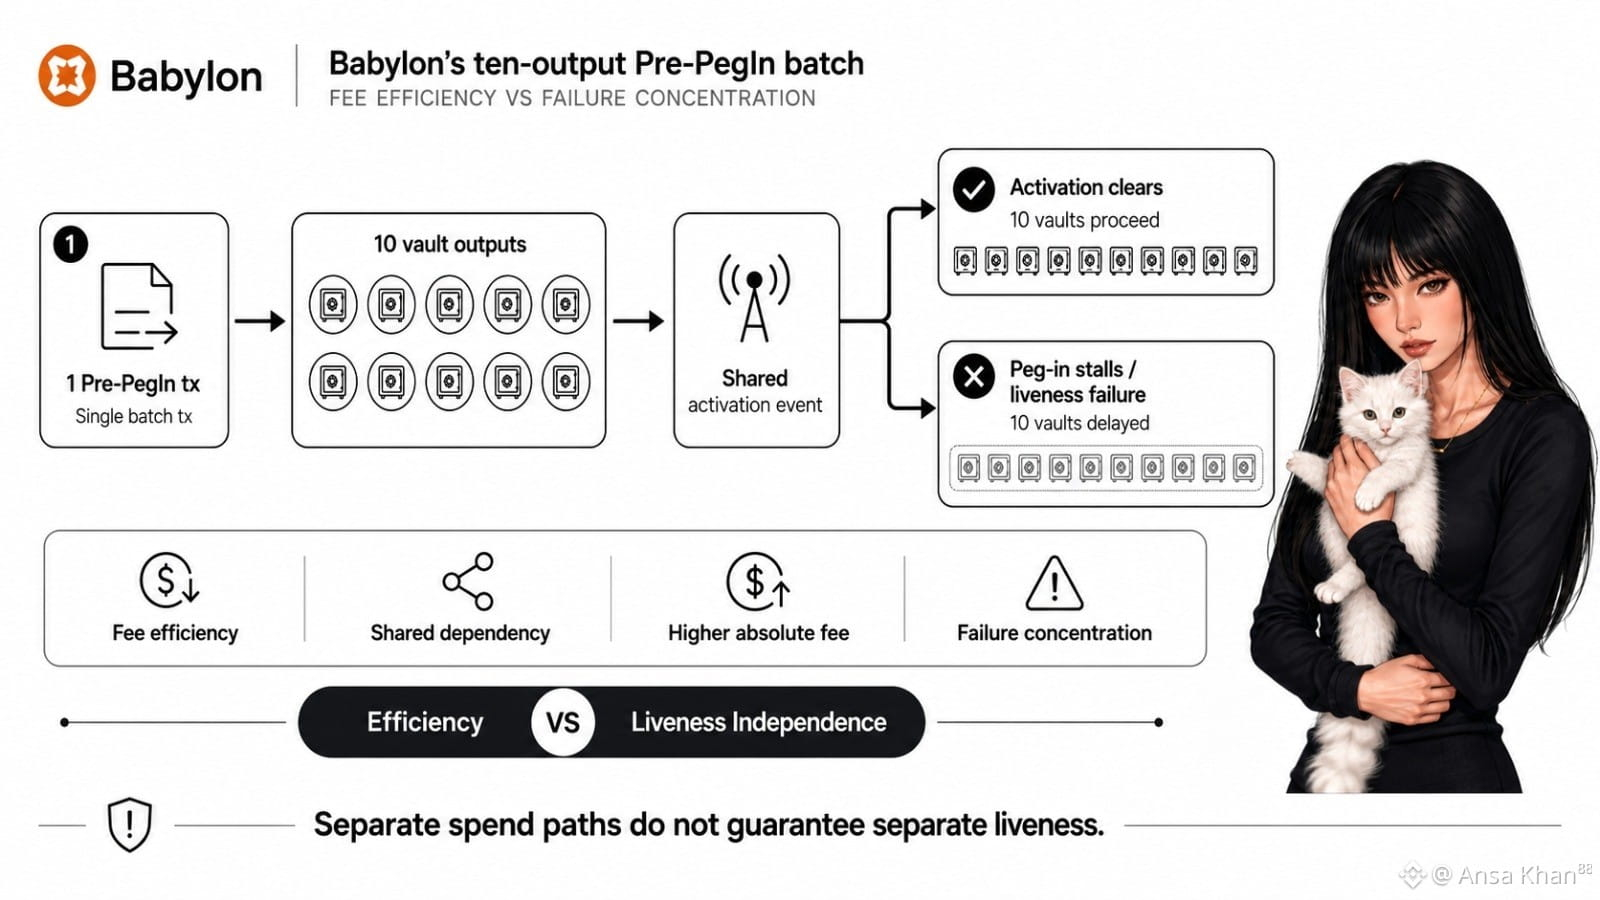
Aku melihat batch Pre-PegIn keluaran sepuluh dari Babylon dari efisiensi biaya terlebih dahulu. Satu transaksi yang membawa sepuluh output vault terlihat lebih rapi, lebih murah, dan lebih mudah untuk diskalakan.
Itu pembacaan yang jelas, mungkin yang lebih lemah.
Masalah sebenarnya muncul setelah disiarkan (broadcast). Setiap output bisa saja mempertahankan jalur pengeluaran Bitcoin masing-masing, tetapi kesepuluhnya tetap bergantung pada satu peristiwa aktivasi yang harus selesai tepat waktu. Jika peg-in itu macet, BABY tidak hanya menghadapi satu vault yang tertunda. BABY bisa menghadapi sepuluh pengguna yang menunggu di belakang kegagalan kelangsungan (liveness) yang sama.
Sebagian ketergantungan bersama itu normal. Batching ada karena mengulang overhead entri sepuluh kali membuang ruang blok dan menaikkan biaya per-vault. Efisiensinya nyata.
Namun ujinya adalah perilaku saat terjadi penundaan. Bisakah Babylon mengisolasi pemulihan per output, atau apakah satu masalah di level transaksi menahan seluruh batch bersama-sama? Siapa yang bereaksi ketika tenggat mulai menyusut? Apakah biaya absolut yang lebih besar yang terkait dengan satu transaksi membuat rebroadcast terasa lebih menyakitkan?
Ini adalah efisiensi biaya versus konsentrasi kegagalan.
BABY sukses jika batching menurunkan biaya entri tanpa mengubah satu kesalahan operasional menjadi antrean sepuluh vault. Aku masih mengawasi satu titik yang tidak nyaman: jalur pengeluaran yang terpisah tidak menjamin liveness yang terpisah.
Babylon mungkin menghemat ruang di sini. Pertanyaan yang lebih sulit adalah apakah hal itu tetap menjaga independensi.
@BabylonLabs_io #baby $BABY
Itu pembacaan yang jelas, mungkin yang lebih lemah.
Masalah sebenarnya muncul setelah disiarkan (broadcast). Setiap output bisa saja mempertahankan jalur pengeluaran Bitcoin masing-masing, tetapi kesepuluhnya tetap bergantung pada satu peristiwa aktivasi yang harus selesai tepat waktu. Jika peg-in itu macet, BABY tidak hanya menghadapi satu vault yang tertunda. BABY bisa menghadapi sepuluh pengguna yang menunggu di belakang kegagalan kelangsungan (liveness) yang sama.
Sebagian ketergantungan bersama itu normal. Batching ada karena mengulang overhead entri sepuluh kali membuang ruang blok dan menaikkan biaya per-vault. Efisiensinya nyata.
Namun ujinya adalah perilaku saat terjadi penundaan. Bisakah Babylon mengisolasi pemulihan per output, atau apakah satu masalah di level transaksi menahan seluruh batch bersama-sama? Siapa yang bereaksi ketika tenggat mulai menyusut? Apakah biaya absolut yang lebih besar yang terkait dengan satu transaksi membuat rebroadcast terasa lebih menyakitkan?
Ini adalah efisiensi biaya versus konsentrasi kegagalan.
BABY sukses jika batching menurunkan biaya entri tanpa mengubah satu kesalahan operasional menjadi antrean sepuluh vault. Aku masih mengawasi satu titik yang tidak nyaman: jalur pengeluaran yang terpisah tidak menjamin liveness yang terpisah.
Babylon mungkin menghemat ruang di sini. Pertanyaan yang lebih sulit adalah apakah hal itu tetap menjaga independensi.
@BabylonLabs_io #baby $BABY