
过去大家看 Marvell,第一反应是 AI ASIC、光互联、SerDes、DSP、硅光、DCI。
但这次 Structera X 和 Structera A 的重点,是把 MRVL 拉进了 AI 内存瓶颈这条主线。
现在 AI 数据中心最贵的东西不只是 GPU。
内存也越来越贵。
长上下文、多智能体、推理服务、向量数据库、in-memory database、推荐模型,这些场景都在疯狂吃 DRAM。
GPU 负责计算。
Memory 负责记忆。
光互联负责数据搬运。
如果内存不够,GPU 再强也会被卡住
这就是 MRVL 这次 CXL 方案的意义
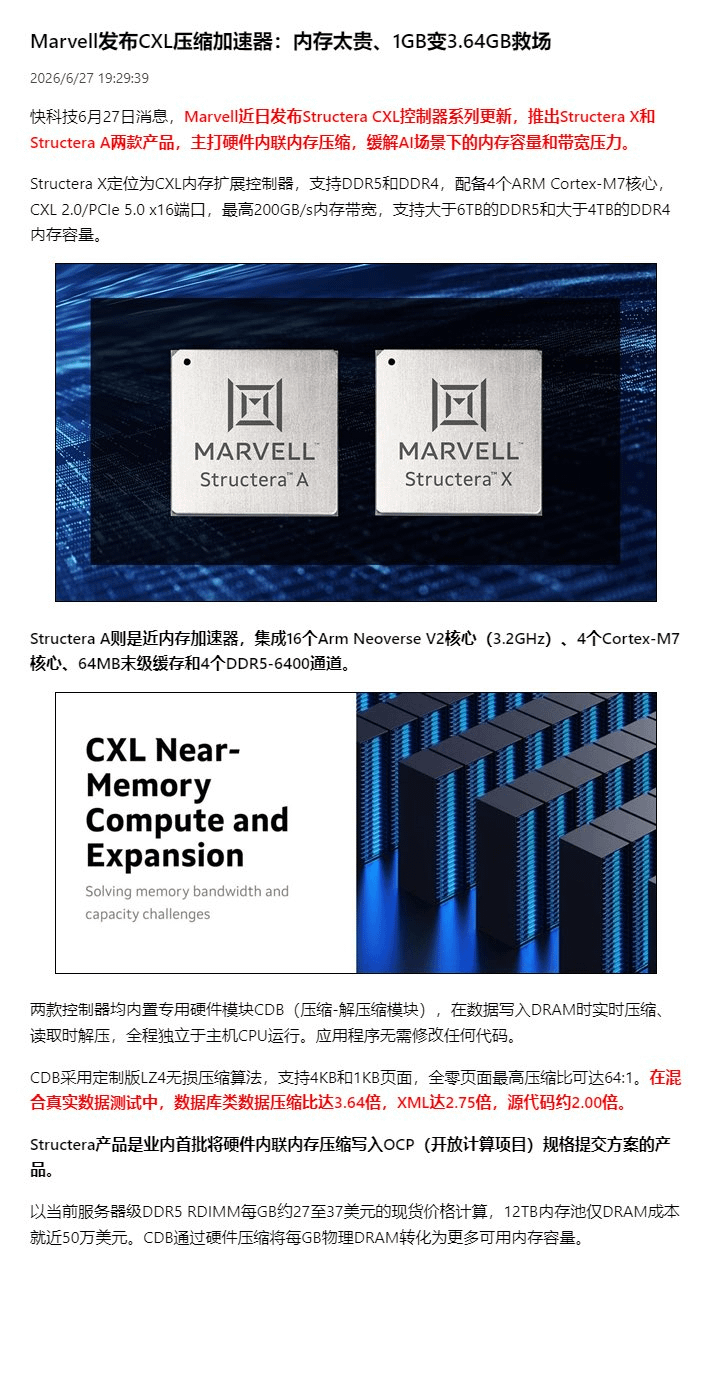
Structera X 和 Structera A 的核心,不是简单加一块内存控制器,而是通过 CXL 把服务器外部 DRAM 接入进来,再用硬件内联压缩,把每 1GB 物理内存变成更多可用容量。
官方数据里,数据库类数据压缩率最高可以达到 3.64x。
XML 大约 2.75x。
源代码大约 2.0x。
当然,这不是说所有数据都能 1GB 变 3.64GB。
压缩率取决于数据类型。
但重点是:
如果 hyperscaler 能把一部分可压缩数据通过硬件压缩提高有效内存容量,那就相当于在不增加太多 DRAM 采购的情况下,缓解内存短缺和成本压力。
这件事对云厂商非常有吸引力。
因为现在服务器级 DDR5 RDIMM 已经很贵。
一个 12TB 内存池,单 DRAM 成本就可能接近 50 万美元。
当 AI 基建扩张速度快过晶圆厂供给速度,内存就不再是普通配件,而是战略资源。
这和美光最近财报透露出来的逻辑是同一条线。
AI 正在把存储和内存从周期品,重新定价成基础设施瓶颈。
$MU 解决的是 HBM、DRAM、NAND 的供给问题。
$MRVL 这次解决的是:
当内存越来越贵,如何让每一 GB 更值钱。
这就是 Structera 的真正看点。
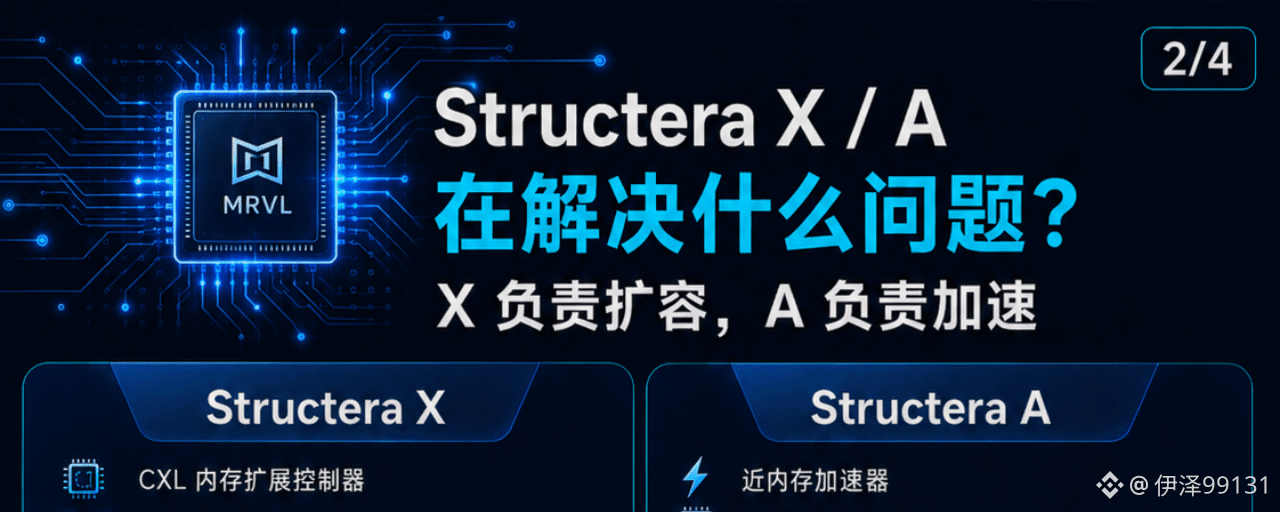
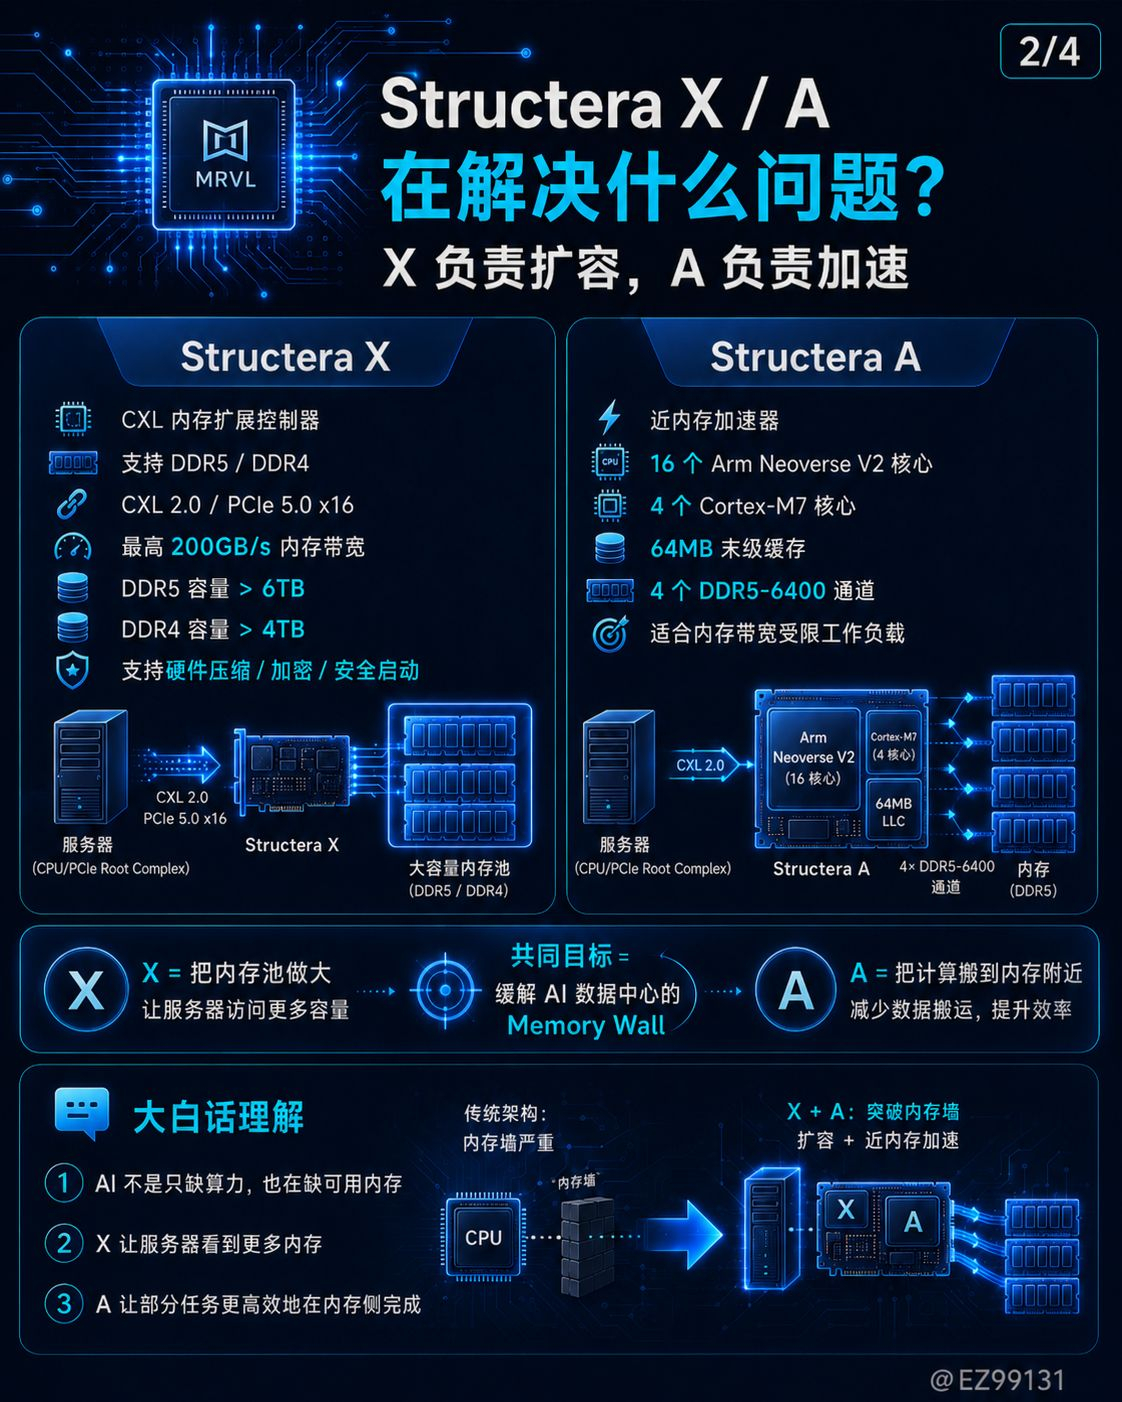
Structera X 更像内存扩展控制器。
它解决的是服务器内存池怎么变大。
Structera A 更像近内存计算加速器。
它解决的是一些内存带宽受限任务,能不能把计算搬到内存附近。
大白话说:
X 负责扩容。
A 负责加速。
两者共同解决 AI 时代的数据中心内存墙。
因为 Structera 产品线不是今天第一次出现,最早 2024 年就已经发布。
这次更像是 Marvell 把“CXL + 硬件压缩”的经济价值重新推到台前。
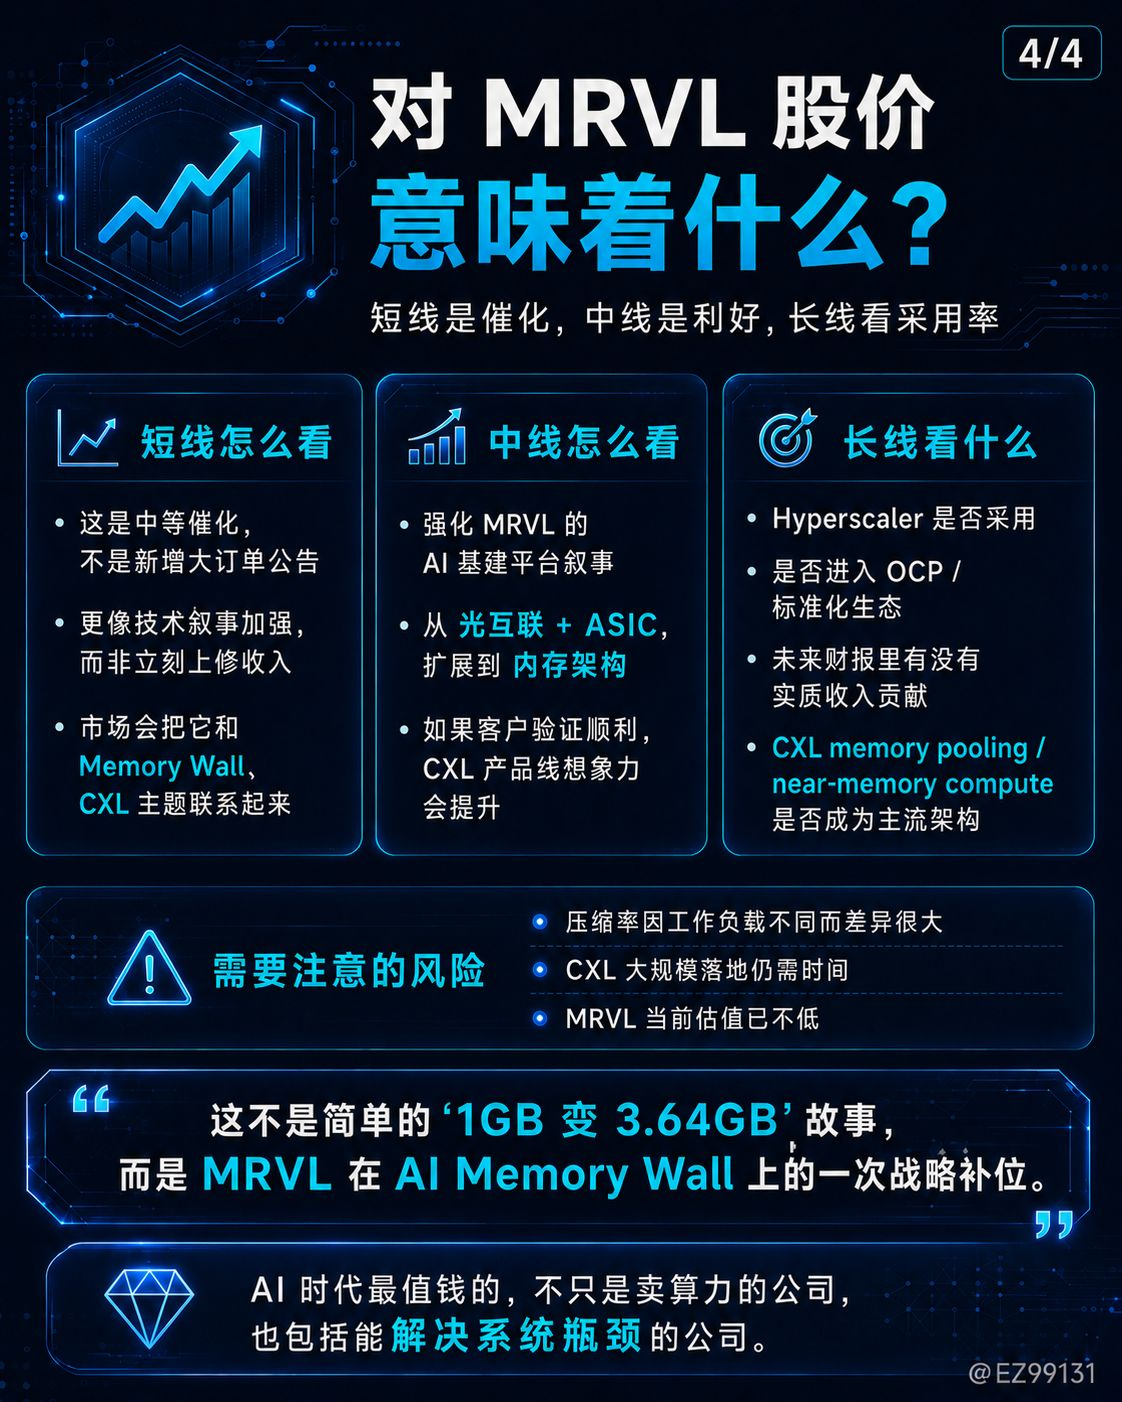
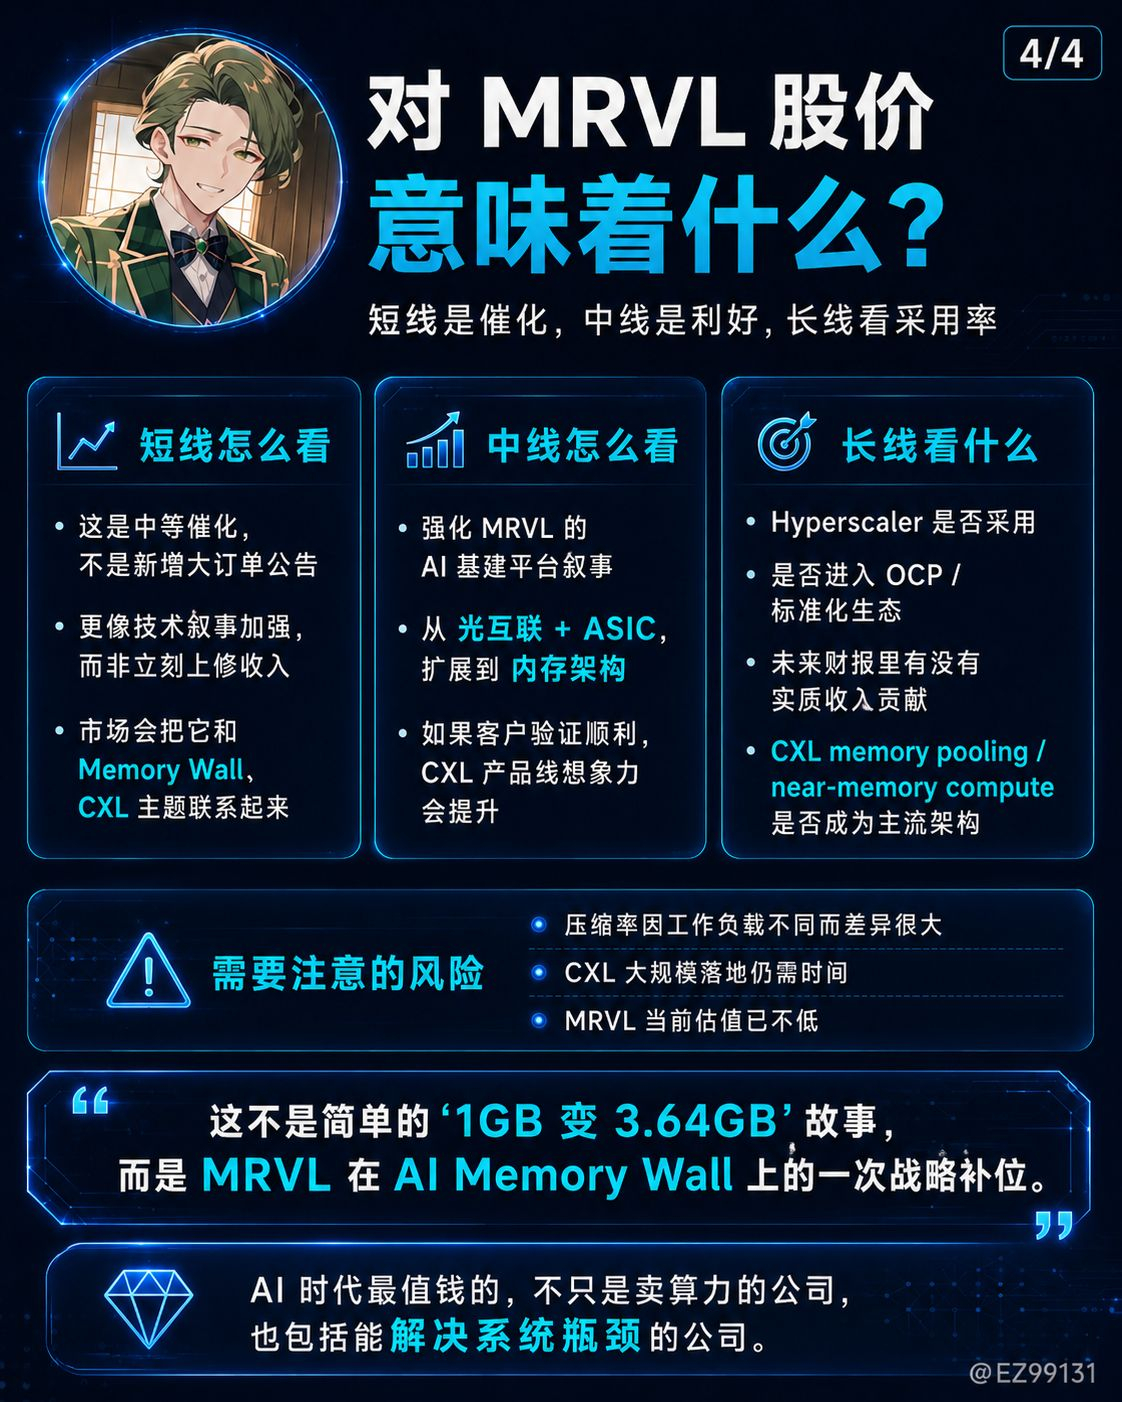
所以短线它不是传统意义上的订单利好。
但中长期,它对 MRVL 的叙事非常重要。
因为 MRVL 的 AI 基建拼图越来越完整了
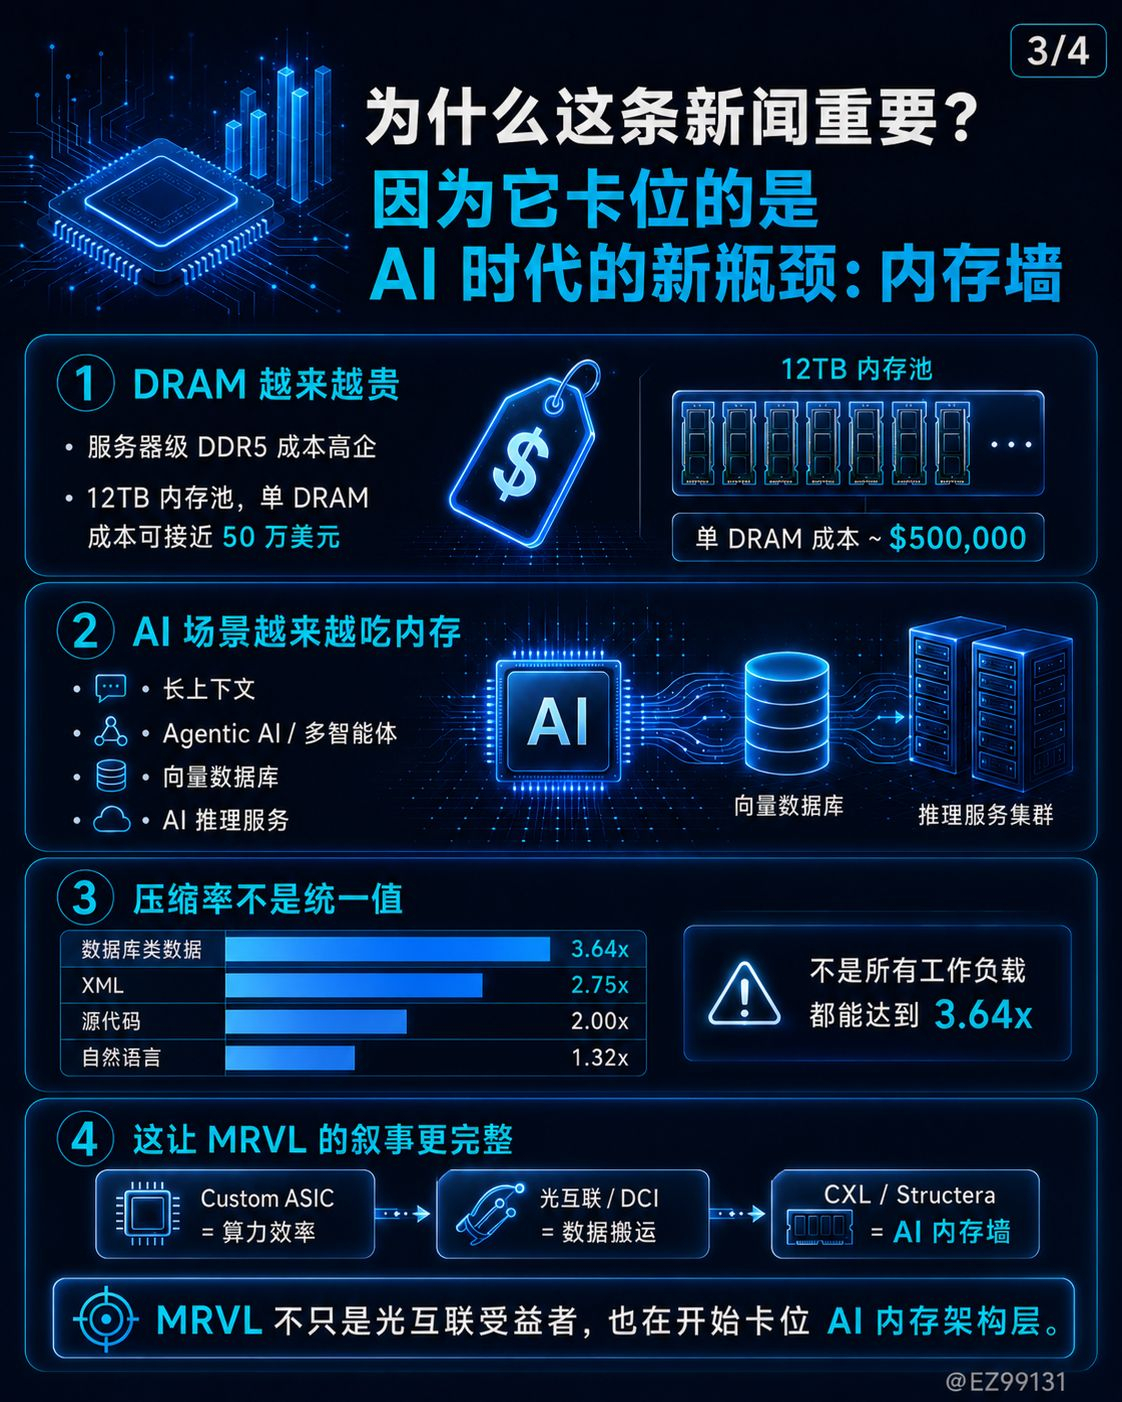
第一块是 custom ASIC。
解决 AI 计算效率
第二块是光互联和 coherent DCI。
解决 AI 数据搬运。
第三块是 CXL 和 memory expansion。
解决 AI 内存墙。
如果再加上 Celestial AI 的 photonic fabric,Marvell 其实正在往一个方向走:
它不只是卖单点芯片。
它想成为 AI 数据基础设施的核心半导体平台。
这点非常关键。
AI 基建的下一阶段,不会只看谁能提供 GPU。
而是看谁能解决系统级瓶颈。
计算瓶颈
内存瓶颈
网络瓶颈
功耗瓶颈
数据中心越大,瓶颈越多。
而 MRVL 正好卡在很多瓶颈之间。
它说明 Marvell 不只是光互联受益者,也不是纯 ASIC 受益者。
它还在内存架构层面抢位置。
如果未来 CXL memory pooling、CXL expansion、near-memory compute 成为 hyperscaler 的标准架构,Structera 会是一条非常有想象力的产品线。
风险在于:
第一,这条消息目前更多是技术和产品叙事,不是新增大订单公告。
第二,CXL 的大规模部署还需要客户验证、生态成熟和软件适配。
第三,压缩率不是所有场景都能达到 3.64x,实际效果要看 workload。
第四,MRVL 现在估值已经不低,市场需要看到这些产品最终进入财报,而不是只停留在技术故事。
如果被 hyperscaler 大规模采用,意义会很大。
它真正强化的是一个判断:
AI 时代,内存墙正在变成和光互联一样重要的基础设施瓶颈。
而 Marvell 正在同时布局这两堵墙。
这不是“1GB 变 3.64GB”的噱头。
这是 MRVL 在 AI memory wall 方向的一次战略补位。
如果 AI 计算继续扩张,未来最值钱的公司,不只是卖算力的公司。
也包括那些能让算力不被内存、网络和数据搬运拖死的公司。
$MRVL 正在往这个位置靠。