

Di tengah ledakan besar kecerdasan buatan (AI) saat ini, apakah Anda pernah memikirkan sebuah pertanyaan: yang sedang kita suapi sebenarnya adalah masa depan teknologi yang bermanfaat bagi seluruh umat manusia, atau super-monopoli teknologi dari segelintir raksasa?
Saat ini, perkembangan AI sangat bergantung pada tiga elemen inti: komputasi, algoritme, dan data. Namun, data berkualitas tinggi kian lama dibangun tembok oleh raksasa sentralisasi, lalu dikuasai sepihak. Bagi para pengembang, mendapatkan data pelatihan AI yang bersih, berkualitas, dan patuh semakin sulit.
Tepat untuk memecahkan situasi “keterasingan data” dan kebuntuan monopoli seperti ini, OpenLedger (buku besar terbuka) hadir. Ia bukan sekadar arsitektur teknologi, melainkan sebuah revolusi yang mengguncang—tentang kedaulatan data di era AI dan kerja sama yang terdesentralisasi.$OPEN
Apa itu OpenLedger?
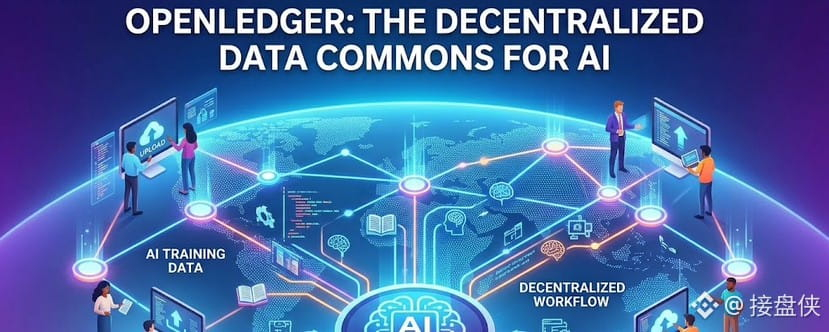
Sederhananya, OpenLedger adalah jaringan terdesentralisasi “data commons (Data Commons)” yang dibuat khusus untuk kecerdasan buatan.#openledger
Ia memanfaatkan sifat tidak dapat diubah dari blockchain, mekanisme insentif berbasis token, serta komputasi perlindungan privasi untuk membangun infrastruktur data terdesentralisasi yang aman, transparan, dan dapat diskalakan (DePIN). Dalam ekosistem OpenLedger, data tidak lagi menjadi aset pribadi yang dikunci di server para raksasa, melainkan berubah menjadi aset digital yang dibangun bersama oleh kontributor global serta berbagi manfaat.#OpenLedger
Misi intinya sangat jelas: membuat aliran data AI berkualitas tinggi dapat bergerak, sekaligus memastikan hak-hak penyedia data dihormati sepenuhnya.
Keunggulan inti: OpenLedger mengubah ekosistem AI dengan apa?
OpenLedger menjadi begitu menarik perhatian kalangan teknologi dan bidang Web3 karena ia mengatasi titik sakit utama dalam rantai pasokan data AI tradisional:
Pipeline data terdesentralisasi berkualitas tinggi (Data Pipeline): Pengumpulan data tradisional penuh kebisingan dan tidak efisien. OpenLedger, melalui workflow terdesentralisasi, menyerahkan pengumpulan, pembersihan, pelabelan, dan distribusi verifikasi data kepada pengguna global serta node otomatis. Pola “crowdsourcing + AI” ini mampu menghasilkan kumpulan data berkualitas tinggi untuk pelatihan model bahasa besar (LLM) dengan biaya yang sangat rendah dan kecepatan yang sangat tinggi.
Kepastian kepemilikan data yang absolut dan penelusuran asal-usul: Di OpenLedger, setiap kontribusi, modifikasi, dan penggunaan data akan dicatat permanen di buku besar blockchain. Artinya, setiap butir data yang Anda kontribusikan memiliki “identitas digital”. Saat model AI berlatih menggunakan data siapa, semuanya terlihat dengan jelas, sehingga masalah hak kekayaan intelektual dan kepatuhan dapat diselesaikan secara mendasar.
Kedaulatan kembali bagi kontributor data & insentif: Di masa lalu, data perilaku yang kita hasilkan di media sosial dan internet—diambil gratis oleh para raksasa untuk melatih AI, sementara kita tidak mendapat apa pun. Namun di OpenLedger, “data adalah aset”. Kontributor data, berpartisipasi dalam pelabelan data, atau menjalankan node verifikasi, semuanya dapat memperoleh insentif berupa token ekosistem. Anda menjadi pemilik sesungguhnya atas data Anda sendiri.
Keseimbangan sempurna antara privasi dan keamanan: Dengan memperkenalkan teknologi kriptografi mutakhir seperti proof of zero-knowledge (ZKP), OpenLedger memungkinkan model AI berlatih tanpa bersentuhan langsung dengan data privasi asli pengguna. Ini membuka jalan implementasi AI untuk industri yang sangat sensitif terhadap privasi seperti kesehatan dan keuangan.
Bagaimana cara kerjanya?
Logika operasional ekosistem OpenLedger dapat disederhanakan menjadi tiga langkah berikut:
Kontribusi & Pembersihan (Supply): Penyedia data (individu atau institusi) mengunggah data mentah, sementara node terdesentralisasi melakukan pembersihan dan menghilangkan noise pada data tersebut.
Verifikasi & Penyimpanan (Validate & Store): Node verifikator meninjau kualitas data, memastikan data tersebut benar dan sesuai ketentuan, lalu mendistribusikan dan menyimpannya dengan aman di jaringan penyimpanan terdesentralisasi.
Konsumsi & Pelatihan (Consume): Pengembang AI dan lembaga riset mengakses kumpulan data berkualitas tinggi ini untuk pelatihan dan fine-tuning dengan membayar menggunakan token.
Ini adalah ekosistem loop tertutup yang sempurna. Semakin kaya datanya, semakin banyak pengembang AI yang tertarik; semakin banyak pengembang, semakin besar nilai yang dihasilkan ekosistem, sehingga semakin banyak orang terdorong untuk berkontribusi dengan data berkualitas tinggi.
Mengapa sekarang saat terbaik untuk memperhatikan OpenLedger?
Pada tahun 2026, AI akan masuk ke fase “aplikasi di domain vertikal” dari fase “model umum”. Data internet yang bersifat umum sudah “dimakan” oleh model-model besar hampir sepenuhnya. Persaingan AI di masa depan bergantung pada data yang unik, berkualitas tinggi, dan patuh aturan—yaitu data profesional yang sesuai.
OpenLedger justru berada di persimpangan momentum besar pada era ini. Selain menghadirkan skenario aplikasi yang benar-benar bisa diterapkan untuk Web3, ia juga menyediakan jalur pengembangan yang sepenuhnya open-source dan terdesentralisasi—yang tidak bergantung pada raksasa terpusat—bagi seluruh industri AI.@OpenLedger
AI masa depan tidak seharusnya didefinisikan oleh segelintir orang, melainkan dibentuk bersama oleh kontributor data dari seluruh dunia. OpenLedger sedang membangun era kedaulatan AI yang baru—transparan, adil, dan terbuka.