



Diselenggarakan & disusun oleh: Sunny, Shenchao TechFlow
Protokol komputasi AI Blockchain Gensyn mengumumkan pada 12 Juni bahwa mereka telah menyelesaikan pembiayaan Seri A senilai $43 juta yang dipimpin oleh a16z.
Misi Gensyn adalah memberi pengguna akses terhadap skala komputasi yang setara dengan memiliki klaster komputasi pribadi dan, yang terpenting, mencapai akses adil yang menghindari kontrol atau penutupan oleh entitas pusat mana pun. Sementara itu, Gensyn adalah protokol komputasi terdesentralisasi yang berfokus pada pelatihan model pembelajaran mesin.
Melihat kembali podcast pendiri Gensyn, Harry dan Ben, dengan Epicenter pada akhir tahun lalu, Anda dapat menemukan bahwa mereka membahas secara mendalam penyelidikan sumber daya komputasi, termasuk AWS, infrastruktur lokal, dan infrastruktur cloud, untuk memahami cara mengoptimalkan dan memanfaatkan sumber daya ini untuk mendukung pengembangan aplikasi AI.
Pada saat yang sama, mereka juga membahas secara rinci filosofi desain Gensyn, tujuan dan positioning pasar, serta berbagai kendala, asumsi dan strategi pelaksanaan yang dihadapi selama proses desain.
Podcast ini memperkenalkan empat peran utama dalam jaringan off-chain Gensyn, mengeksplorasi karakteristik jaringan on-chain Gensyn, dan pentingnya token dan tata kelola Gensyn.
Selain itu, Ben dan Harry juga berbagi beberapa ilmu AI yang menarik untuk memberikan pemahaman yang lebih mendalam kepada semua orang tentang prinsip dasar dan penerapan kecerdasan buatan.
Pembawa acara: Dr. Friederike Ernst, Podcast Episentrum
Pembicara: Ben Fielding & Harry Grieve, Salah Satu Pendiri Gensyn
Judul asli: "Ben Fielding & Harry Grieve: Gensyn – Protokol Komputasi Pembelajaran Mendalam"
Tanggal tayang: 24 November 2022
Blockchain sebagai lapisan kepercayaan untuk infrastruktur AI yang terdesentralisasi
Pembawa acara bertanya kepada Ben dan Harry mengapa mereka menggabungkan pengalaman mereka yang kaya dalam AI dan pembelajaran mendalam dengan blockchain?
Ben mengatakan, keputusan mereka tidak diambil dalam semalam, melainkan melalui jangka waktu yang relatif lama. Tujuan Gensyn adalah membangun infrastruktur AI berskala besar, dan saat meneliti cara mencapai skalabilitas maksimum, mereka menyadari bahwa diperlukan lapisan yang tidak dapat dipercaya.
Mereka harus mampu mengkonsolidasikan kemampuan komputasi tanpa bergantung pada penerimaan penyedia baru yang terpusat atau menghadapi kendala perluasan administratif. Untuk mengatasi masalah ini, mereka mulai mengeksplorasi penelitian komputasi yang dapat diverifikasi, namun mereka menemukan bahwa hal ini selalu memerlukan pihak ketiga atau hakim yang tepercaya untuk memeriksa penghitungan tersebut.
Keterbatasan ini membawa mereka ke blockchain. Blockchain menyediakan cara untuk menghilangkan kebutuhan akan satu pengambil keputusan atau arbiter karena memungkinkan konsensus di antara kelompok besar.
Harry juga menyampaikan filosofinya bahwa dia dan Ben sangat mendukung kebebasan berpendapat dan prihatin dengan sensor.
Sebelum mereka pindah ke blockchain, mereka melihat pembelajaran gabungan, bidang pembelajaran mendalam di mana Anda melatih beberapa model pada sumber data terdistribusi dan kemudian menggabungkannya untuk membuat model meta yang dapat belajar dari semua sumber data. Mereka bekerja sama dengan bank dalam pendekatan ini. Namun, mereka segera menyadari bahwa masalah yang lebih besar adalah perolehan sumber daya komputasi atau prosesor yang dapat melatih model ini.
Untuk memaksimalkan integrasi sumber daya komputasi, mereka memerlukan metode koordinasi yang terdesentralisasi, di sinilah blockchain berperan.
Survei Sumber Daya Komputasi Pasar: AWS, Infrastruktur Lokal, dan Infrastruktur Cloud
Harry menjelaskan berbagai opsi sumber daya komputasi untuk menjalankan model AI, bergantung pada ukuran model.
Siswa dapat menggunakan AWS atau mesin lokal, startup dapat memilih AWS sesuai permintaan atau opsi terjadwal yang lebih murah.
Namun untuk kebutuhan GPU berskala besar, AWS mungkin dibatasi oleh biaya dan skalabilitas, dan sering kali memilih untuk membangun infrastruktur internal.
Penelitian menunjukkan bahwa banyak organisasi kesulitan untuk meningkatkan skalanya, bahkan ada yang memilih untuk membeli dan mengelola GPU sendiri. Secara keseluruhan, membeli GPU lebih hemat biaya dalam jangka panjang dibandingkan menjalankannya di AWS.
Opsi untuk sumber daya komputasi pembelajaran mesin mencakup komputasi awan, menjalankan model AI secara lokal, atau membangun cluster komputasi Anda sendiri. Sasaran Gensyn adalah menyediakan akses ke skala komputasi yang sama dengan memiliki klasternya sendiri, dan kuncinya adalah mencapai akses yang adil, yang tidak dapat dikontrol atau dimatikan oleh entitas pusat mana pun.
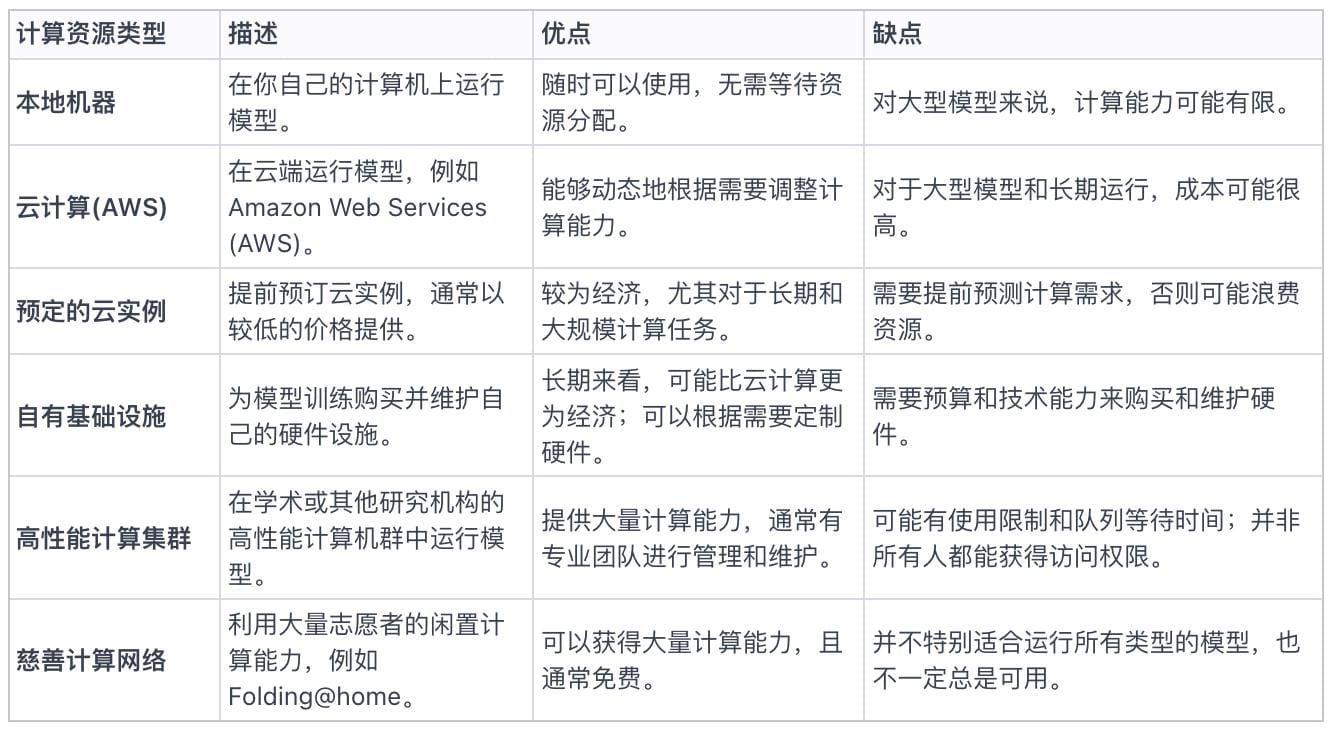
Tabel 1: Semua pilihan sumber daya komputasi yang saat ini ada di pasaran
Diskusi tentang filosofi desain, tujuan, dan posisi pasar Gensyn
Pembawa acara menanyakan perbedaan Gensyn dari proyek komputasi blockchain sebelumnya, seperti Jaringan Golem.
Harry menjelaskan bahwa filosofi desain Gensyn terutama dipertimbangkan dalam dua sumbu:
Perincian protokol: Tidak seperti protokol komputasi tujuan umum seperti Golem, Gensyn adalah protokol terperinci yang berfokus pada pelatihan model pembelajaran mesin.
Skalabilitas terverifikasi: Proyek awal sering kali mengandalkan reputasi atau metode replikasi yang kurang toleran terhadap kesalahan Bizantium, sehingga tidak cukup percaya pada hasil pembelajaran mesin. Gensyn bertujuan untuk memanfaatkan pembelajaran dari protokol komputasi di dunia kripto dan menerapkannya secara khusus pada pembelajaran mesin untuk mengoptimalkan kecepatan dan biaya sambil memastikan tingkat verifikasi yang memuaskan.
Harry menambahkan bahwa ketika mempertimbangkan sifat dari apa yang harus dilakukan jaringan, jaringan tersebut perlu ditargetkan pada para insinyur dan peneliti pembelajaran mesin. Hal ini perlu memiliki komponen verifikasi, namun kuncinya adalah bahwa hal tersebut harus tahan terhadap sensor dan netral terhadap perangkat keras dalam hal memungkinkan siapa pun untuk berpartisipasi.
Batasan, asumsi dan eksekusi selama proses desain
Selama proses desain platform Gensyn, Ben menekankan pentingnya batasan dan asumsi sistem. Tujuan mereka adalah menciptakan jaringan yang dapat mengubah seluruh dunia menjadi superkomputer AI, dan untuk melakukannya, mereka perlu menemukan keseimbangan antara asumsi produk, asumsi penelitian, dan asumsi teknologi.
Alasan mereka membangun Gensyn sebagai blockchain lapis pertama mereka adalah untuk menjaga fleksibilitas yang lebih besar dan kebebasan pengambilan keputusan di bidang teknis utama seperti mekanisme konsensus. Mereka ingin protokol mereka dapat bertahan di masa depan dan tidak ingin menerapkan pembatasan yang tidak perlu pada tahap awal proyek. Selain itu, mereka percaya bahwa di masa depan rantai akan dapat berinteraksi melalui protokol pengiriman pesan yang diterima secara luas, sehingga keputusan mereka sejalan dengan visi ini.
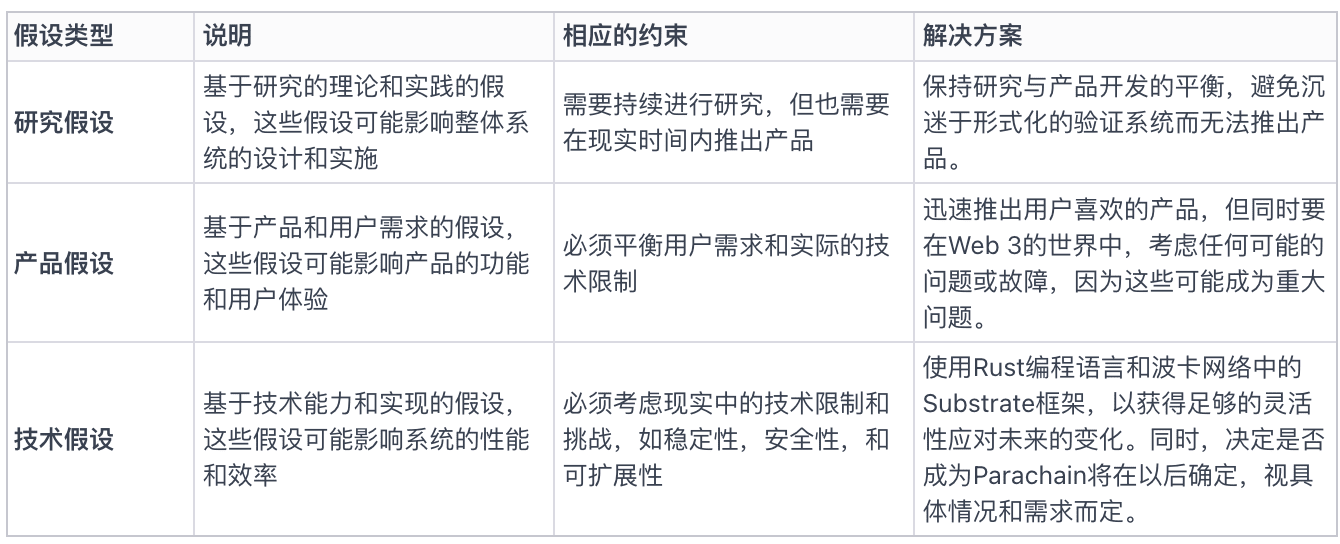
Gambar 2: Asumsi produk, asumsi penelitian dan asumsi teknologi, batasan dan pelaksanaan
Empat aktor utama dalam jaringan off-chain Gensyn
Dalam diskusi ekonomi Gensyn kali ini, diperkenalkan empat peran utama: pembuat komitmen, pekerja, validator, dan pelapor. Pengirim dapat mengajukan berbagai masalah ke jaringan Gensyn, termasuk menghasilkan gambar tertentu atau mengembangkan model AI yang dapat menggerakkan mobil.
Pengirim menyerahkan tugas
Harry menjelaskan cara menggunakan Gensyn untuk melatih model. Pengguna pertama-tama menentukan hasil yang diinginkan, seperti membuat gambar berdasarkan perintah teks, lalu membuat model yang menggunakan perintah teks sebagai masukan dan menghasilkan gambar yang sesuai. Data pelatihan sangat penting untuk pembelajaran dan peningkatan model. Setelah menyiapkan arsitektur model dan data pelatihan, pengguna mengirimkannya ke jaringan Gensyn bersama dengan hyperparameter seperti jadwal kecepatan pembelajaran dan durasi pelatihan. Hasil dari proses pelatihan ini adalah model terlatih yang dapat dihosting dan digunakan oleh pengguna.
Ketika ditanya bagaimana memilih model yang tidak terlatih, Harry menyarankan dua metode.
Yang pertama didasarkan pada konsep model dasar yang populer saat ini, di mana perusahaan besar seperti OpenAI atau Midjourney akan membangun model dasar, dan kemudian pengguna dapat melatih model dasar tersebut pada data tertentu.
Opsi kedua adalah membangun model dari awal, bukan pendekatan model dasar.
Di Gensyn, pengembang dapat mengirimkan berbagai arsitektur untuk pelatihan dan pengujian menggunakan metode yang mirip dengan pengoptimalan evolusioner, dan terus mengoptimalkan untuk membangun model yang diinginkan.
Ben memberikan pandangan mendalam tentang model yang mendasarinya dari sudut pandang mereka, yang mereka yakini sebagai masa depan bidang ini.
Gensyn sebagai sebuah protokol, kami berharap dapat digunakan oleh DApps yang menerapkan teknik optimasi evolusioner atau metode serupa. DApps ini dapat mengirimkan arsitektur individual ke protokol Gensyn untuk pelatihan dan pengujian, dan membangun model ideal melalui penyempurnaan berulang.
Tujuan Gensyn adalah memberikan landasan komputasi pembelajaran mesin murni dan mendorong pengembangan ekosistem di sekitarnya.
Meskipun model yang telah dilatih sebelumnya dapat menimbulkan bias karena organisasi mungkin menggunakan kumpulan data eksklusif atau menyembunyikan informasi tentang proses pelatihan, solusi Gensyn adalah membuka proses pelatihan daripada menghilangkan kotak hitam atau mengandalkan determinisme penuh. Dengan merancang dan melatih model dasar secara kolektif, kita dapat menciptakan model global yang tidak bias oleh kumpulan data perusahaan tertentu.
Pemecah
Untuk distribusi tugas, satu tugas berhubungan dengan satu server. Namun sebuah model dapat dipecah menjadi beberapa tugas.
Model bahasa besar dirancang untuk memanfaatkan kapasitas perangkat keras maksimum yang tersedia pada saat itu. Konsep ini dapat diperluas ke jaringan untuk mempertimbangkan heterogenitas perangkat.
Untuk tugas tertentu, seperti validator atau pekerja, terdapat opsi untuk mengambil alih dari Mempool. Seorang pekerja dipilih secara acak dari mereka yang menyatakan kesediaannya untuk mengambil tugas tersebut. Jika model dan data tidak dapat disesuaikan dengan perangkat tertentu, namun pemilik perangkat mengklaim dapat menyesuaikannya, denda dapat terjadi karena kemacetan sistem.
Apakah suatu tugas dapat dijalankan pada mesin ditentukan oleh fungsi acak yang dapat diverifikasi yang memilih pekerja dari subkumpulan pekerja yang tersedia.
Mengenai masalah verifikasi kemampuan pekerja, jika pekerja tidak memiliki kemampuan komputasi yang diklaim, maka mereka tidak akan dapat menyelesaikan tugas komputasi, yang akan terdeteksi saat menyerahkan pembuktian.
Namun, besarnya tugas merupakan suatu masalah. Jika tugas ditetapkan terlalu besar, hal ini dapat menyebabkan masalah sistem, seperti serangan penolakan layanan (DoS), di mana pekerja mengklaim telah menyelesaikan tugas tetapi tidak pernah menyelesaikannya, sehingga membuang-buang waktu dan sumber daya.
Oleh karena itu, keputusan ukuran tugas sangat penting dan perlu mempertimbangkan faktor-faktor seperti paralelisasi dan struktur tugas yang dioptimalkan. Para peneliti secara aktif mempelajari dan mengeksplorasi metode terbaik berdasarkan berbagai kendala.
Setelah testnet diluncurkan, kondisi praktis juga akan dipertimbangkan untuk mengamati bagaimana sistem beroperasi di dunia nyata.
Menentukan ukuran tugas yang sempurna dapat menjadi tantangan, dan Gensyn siap untuk menyesuaikan dan meningkatkan berdasarkan masukan dan pengalaman dunia nyata.
Mekanisme verifikasi dan pos pemeriksaan untuk perhitungan skala besar pada rantai
Harry dan Ben menunjukkan bahwa memverifikasi kebenaran suatu perhitungan merupakan tantangan penting karena tidak bersifat deterministik seperti fungsi hash, sehingga tidak mungkin untuk memverifikasi dengan hashing apakah suatu perhitungan telah dilakukan. Untuk mengatasi masalah ini, solusi ideal adalah dengan menggunakan penerapan bukti tanpa pengetahuan di seluruh proses penghitungan. Saat ini Gensyn masih berupaya mengimplementasikan kemampuan tersebut.
Saat ini, Gensyn memperkenalkan pendekatan hybrid menggunakan checkpointing untuk memverifikasi penghitungan pembelajaran mesin melalui mekanisme probabilistik dan checkpointing. Dengan menggabungkan skema audit stokastik dengan jalur ruang gradien, pemeriksaan yang relatif kuat dapat dilakukan. Selain itu, bukti tanpa pengetahuan diperkenalkan untuk meningkatkan proses verifikasi dan diterapkan pada model yang hilang secara global.
Verifikator dan Pelapor
Moderator dan Harry membahas dua peran tambahan yang terlibat dalam proses verifikasi: verifikator dan pelapor. Mereka merinci tanggung jawab dan peran spesifik dari kedua peran ini.
Tugas validator adalah memastikan kebenaran pos pemeriksaan, sedangkan tugas pelapor adalah memastikan keakuratan validator dalam menjalankan tugasnya. Pelapor memecahkan masalah dilema validator, memastikan bahwa pekerjaan validator benar dan dapat dipercaya. Verifikator dengan sengaja memasukkan kesalahan ke dalam pekerjaan mereka, dan peran pelapor adalah untuk mengidentifikasi dan mengungkap kesalahan ini, sehingga menjamin integritas proses verifikasi.
Verifikator sengaja membuat kesalahan untuk menguji kewaspadaan pelapor dan memastikan efektivitas sistem. Jika ada kesalahan dalam pekerjaan, validator mendeteksi kesalahan tersebut dan memberitahukan kepada pelapor. Kesalahan tersebut kemudian dicatat di blockchain dan diverifikasi secara on-chain. Secara berkala, dan pada tingkat yang relevan dengan keamanan sistem, validator dengan sengaja memperkenalkan bug agar pelapor tetap terlibat. Jika pelapor menemukan masalah, mereka berpartisipasi dalam permainan yang disebut "protokol pinpoint", yang melaluinya mereka dapat mempersempit penghitungan ke titik tertentu di pohon Merkle di wilayah tertentu di jaringan saraf. Informasi ini kemudian diserahkan ke arbitrase on-chain. Ini adalah versi sederhana dari proses bagi validator dan pelapor yang akan melakukan pengembangan dan penelitian lebih lanjut setelah putaran awal.
Jaringan on-chain Gensyn
Ben dan Harry membahas secara rinci cara kerja protokol koordinasi Gensyn secara on-chain dan detail implementasinya. Mereka pertama kali menyebutkan proses membangun blok jaringan, yang melibatkan token staking sebagai bagian dari jaringan staking tersebut. Mereka kemudian menjelaskan bagaimana komponen-komponen ini berhubungan dengan protokol Gensyn.
Ben menjelaskan bahwa protokol Gensyn sebagian besar merupakan protokol jaringan Polkadot substrat vanilla. Mereka mengadopsi mekanisme konsensus Kakek Babe berdasarkan bukti kepemilikan, dan validator beroperasi dengan cara biasa. Namun, semua komponen pembelajaran mesin yang diperkenalkan sebelumnya terjadi secara off-chain, yang melibatkan berbagai aktor off-chain yang menjalankan tugasnya masing-masing.
Para peserta ini diberi insentif dengan melakukan staking, baik melalui bagian staking di Substrat atau dengan mengirimkan sejumlah token tertentu dalam kontrak pintar. Ketika pekerjaan mereka akhirnya diverifikasi, mereka akan diberi penghargaan.
Tantangan yang disebutkan oleh Ben dan Harry adalah memastikan keseimbangan antara jumlah taruhan, kemungkinan jumlah pengurangan taruhan, dan jumlah hadiah untuk mencegah terciptanya insentif bagi perilaku malas atau jahat.
Selain itu, mereka membahas kompleksitas yang timbul dari penambahan pelapor pelanggaran (whistleblower), namun kehadiran mereka sangat penting untuk memastikan kejujuran verifikator karena tuntutan penskalaan komputasi. Sementara mereka terus mencari cara untuk menghilangkan pelapor melalui teknologi tanpa bukti pengetahuan. Mereka menyatakan bahwa sistem yang ada saat ini sesuai dengan apa yang dijelaskan dalam makalah ringan, namun mereka secara aktif berupaya menyederhanakan setiap aspek.
Moderator bertanya apakah mereka memiliki solusi ketersediaan data, dan Henry menjelaskan bahwa mereka memperkenalkan lapisan di atas substrat yang disebut bukti ketersediaan (POA). Lapisan ini menggunakan teknologi seperti pengkodean penghapusan untuk mengatasi keterbatasan yang mereka temui di pasar tingkat penyimpanan yang luas. Mereka mengatakan mereka akan sangat tertarik pada pengembang yang telah menerapkan solusi seperti itu.
Ben menambahkan, kebutuhan mereka tidak hanya mencakup penyimpanan data pelatihan, tetapi juga data pembuktian perantara yang tidak memerlukan penyimpanan jangka panjang. Misalnya, mereka mungkin hanya perlu menunggu sekitar 20 detik ketika mereka selesai menerbitkan sejumlah blok tertentu. Namun, biaya penyimpanan yang saat ini mereka bayarkan di Arweave mencakup ratusan tahun dan tidak diperlukan untuk kebutuhan jangka pendek ini. Mereka mencari solusi yang memiliki jaminan dan fitur Arweave sekaligus memenuhi kebutuhan penyimpanan jangka pendek dengan biaya lebih rendah.
Token dan Tata Kelola Gensyn
Ben menjelaskan pentingnya token gensyn dalam ekosistem, memainkan peran kunci dalam staking, punishment, memberikan reward, dan menjaga konsensus. Tujuan utamanya adalah untuk memastikan kesehatan keuangan dan integritas sistem. Ben juga menyebutkan penggunaan tingkat inflasi secara hati-hati untuk membayar validator, dan memanfaatkan mekanisme teori permainan.
Dia menekankan penggunaan token Gensyn yang murni teknis dan mengatakan bahwa mereka secara teknis akan memastikan waktu dan perlunya memperkenalkan token Gensyn.
Harry mengatakan mereka adalah minoritas dalam komunitas pembelajaran mendalam, terutama di tengah meluasnya skeptisisme di kalangan pakar AI terhadap mata uang kripto. Meskipun demikian, mereka menyadari nilai aspek teknis dan ideologis dari mata uang kripto.
Namun, ketika jaringan diluncurkan, mereka mengantisipasi bahwa sebagian besar pengguna deep learning akan bertransaksi menggunakan mata uang fiat, dan konversi ke token akan terjadi secara mulus di balik layar.
Di sisi pasokan, pekerja dan pelaku akan terlibat aktif dalam perdagangan token, dan mereka sudah menerima minat dari penambang Ethereum yang memiliki sumber daya GPU yang signifikan dan mencari peluang baru.
Di sini, penting untuk memastikan bahwa ketakutan praktisi pembelajaran mendalam dan pembelajaran mesin terhadap terminologi mata uang kripto (seperti token) dihilangkan, sehingga memisahkannya dari antarmuka pengalaman pengguna. Gensyn mengatakan ini adalah kasus penggunaan menarik yang menjembatani dunia Web 2 dan Web 3 karena masuk akal secara ekonomi dan teknologi diperlukan untuk mendukung keberadaannya.
Kecerdasan Buatan Sains Populer
AI, pembelajaran mendalam, dan pembelajaran mesin
Ben berbagi pandangannya mengenai perkembangan bidang AI beberapa tahun terakhir. Ia percaya bahwa meskipun bidang AI dan pembelajaran mesin telah mengalami serangkaian ledakan kecil selama tujuh tahun terakhir, kemajuan saat ini tampaknya menciptakan dampak nyata dan aplikasi berharga yang dapat diterima oleh khalayak yang lebih luas. Pembelajaran mendalam adalah pendorong mendasar dari perubahan ini. Jaringan saraf dalam telah menunjukkan kemampuannya untuk melampaui tolok ukur yang ditetapkan oleh metode visi komputer tradisional. Selain itu, model seperti GPT-3 telah mempercepat kemajuan ini.
Lebih lanjut Harry menjelaskan perbedaan antara AI, machine learning, dan deep learning. Ia berpendapat bahwa ketiga istilah ini sering digunakan secara bergantian, namun memiliki perbedaan yang signifikan. Dia secara metaforis mengatakan bahwa AI, pembelajaran mesin, dan pembelajaran mendalam seperti boneka matryoshka Rusia, dengan AI sebagai lapisan terluarnya.
Secara garis besar, AI mengacu pada mesin pemrograman untuk melakukan tugas.
Pembelajaran mesin, yang menjadi populer pada tahun 1990an dan awal 2000an, menggunakan data untuk menentukan kemungkinan keputusan daripada mengandalkan sistem pakar dengan aturan jika-maka.
Pembelajaran mendalam dibangun berdasarkan pembelajaran mesin tetapi memungkinkan model yang lebih kompleks.
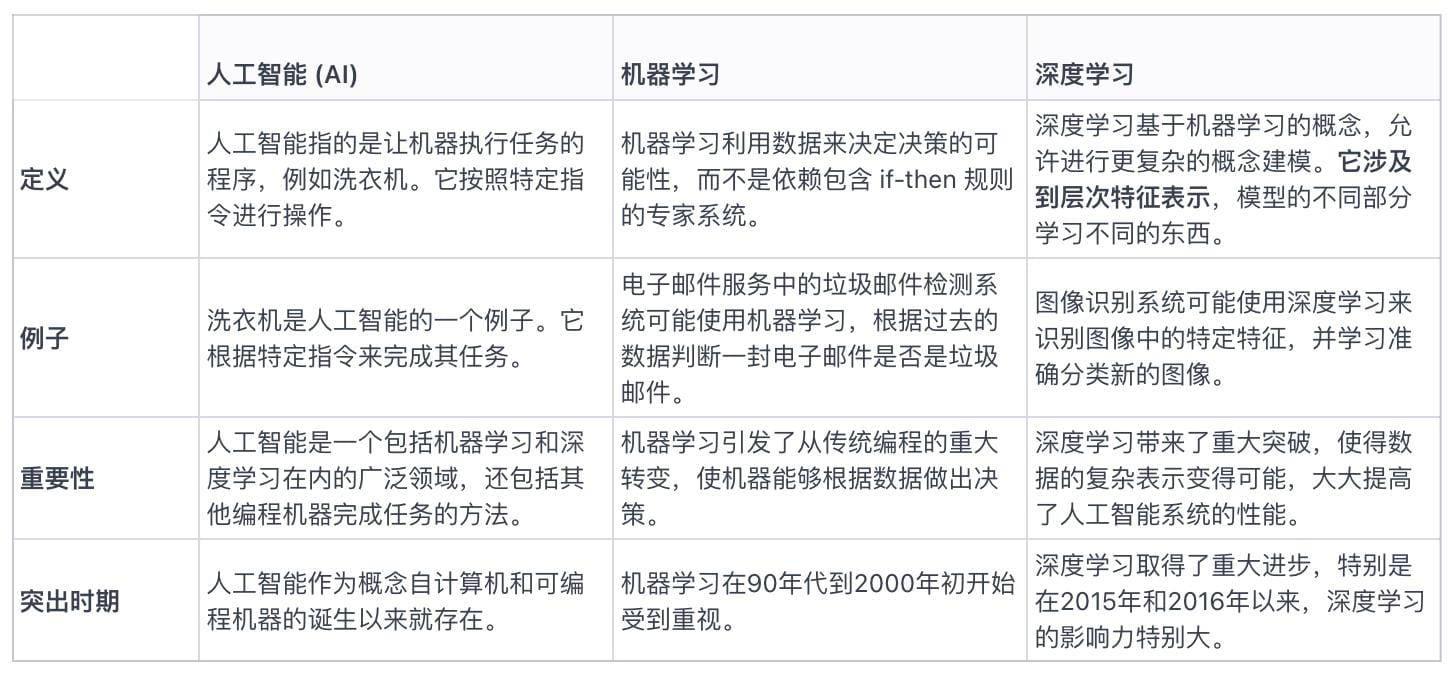
Gambar 3: Perbedaan antara kecerdasan buatan, pembelajaran mesin, dan pembelajaran mendalam
Kecerdasan sempit buatan, kecerdasan umum buatan, kecerdasan super buatan
Di segmen ini, tuan rumah dan tamu memberikan pandangan mendalam tentang tiga bidang utama kecerdasan buatan: kecerdasan sempit buatan (ANI), kecerdasan umum buatan (AGI), dan kecerdasan super buatan (ASI).
Kecerdasan Sempit Buatan (ANI): AI saat ini sebagian besar berada pada tahap ini, di mana mesin sangat baik dalam melakukan tugas-tugas tertentu, seperti mendeteksi jenis kanker tertentu dari pemindaian medis melalui pengenalan pola.
Kecerdasan Umum Buatan (AGI): AGI mengacu pada kemampuan mesin untuk melakukan tugas-tugas yang relatif sederhana bagi manusia namun sangat menantang jika tercermin dalam sistem komputasi. Memungkinkan mesin untuk bernavigasi dengan lancar di lingkungan yang ramai sambil membuat asumsi yang berbeda tentang semua masukan di sekitarnya adalah contoh AGI. AGI mengacu pada kemampuan model atau sistem untuk melakukan tugas sehari-hari seperti manusia.
Kecerdasan Super Buatan (ASI): Setelah mencapai kecerdasan umum buatan, mesin selanjutnya dapat berkembang menjadi kecerdasan super buatan. Hal ini mengacu pada kemampuan mesin untuk melampaui kemampuan manusia karena kompleksitas modelnya, peningkatan daya komputasi, masa pakai yang tidak terbatas, dan memori yang sempurna. Konsep ini sering dieksplorasi dalam film fiksi ilmiah dan horor.
Selain itu, para tamu juga menyebutkan bahwa integrasi otak manusia dan mesin, seperti melalui antarmuka otak-komputer, mungkin merupakan cara untuk mencapai AGI, namun hal ini juga menimbulkan serangkaian masalah moral dan etika.
Membuka kotak hitam pembelajaran mendalam: deterministik versus probabilistik
Ben menjelaskan bahwa sifat kotak hitam model pembelajaran mendalam disebabkan oleh ukurannya yang besar. Anda masih menelusuri jalur melalui serangkaian titik keputusan di jaringan. Namun jalur ini sangat besar dan sulit untuk menghubungkan bobot atau parameter dalam model dengan nilai spesifiknya karena nilai ini diperoleh setelah jutaan sampel dimasukkan. Anda pasti dapat melakukan ini, dan Anda dapat melacak setiap pembaruan, tetapi jumlah data yang Anda hasilkan akan sangat besar.
Dia melihat dua hal terjadi:
Saat kami semakin memahami model yang kami buat, sifat kotak hitam secara bertahap menghilang. Pembelajaran mendalam merupakan bidang penelitian yang telah melalui masa yang menarik dan pesat dengan banyak eksperimen yang tidak didorong oleh dasar-dasar penelitian. Ini lebih tentang melihat apa yang bisa kita peroleh darinya. Jadi kami membuang lebih banyak data, mencoba arsitektur baru, dan melihat apa yang terjadi, daripada memulai dari prinsip pertama, merancang hal ini, dan mengetahui secara pasti cara kerjanya. Jadi ada periode menarik di mana segala sesuatunya seperti kotak hitam. Namun menurutnya pertumbuhan pesat ini mulai melambat, dan kita melihat orang-orang meninjau kembali arsitektur ini dan memeriksanya serta berkata, "Mengapa ini berhasil dengan baik? Mari kita gali dan buktikan." sedang diangkat.
Hal lain yang terjadi, mungkin lebih kontroversial, adalah pergeseran pandangan mengenai apakah sistem komputasi harus bersifat deterministik sepenuhnya, atau apakah kita bisa hidup di dunia yang bersifat probabilistik. Kita sebagai manusia hidup di dunia yang probabilistik. Contoh mobil self-driving mungkin paling jelas. Saat kita mengemudi, kita menerima bahwa kejadian acak akan terjadi, mungkin ada kecelakaan kecil, dan mungkin ada masalah dengan sistem mobil self-driving. Namun kami tidak bisa menerima hal ini sama sekali dan kami mengatakan ini harus menjadi proses yang sepenuhnya deterministik. Salah satu tantangan dalam industri mobil self-driving adalah adanya asumsi bahwa masyarakat akan menerima mekanisme probabilistik yang diterapkan pada mobil self-driving, namun kenyataannya masyarakat tidak. Menurutnya hal ini akan berubah, dan mungkin menjadi kontroversial apakah kita, sebagai masyarakat, akan membiarkan sistem komputasi probabilistik hidup berdampingan dengan kita? Dia tidak yakin apakah jalannya akan mulus, tapi menurutnya itu akan terjadi.
Metode pengoptimalan gradien: metode pengoptimalan inti pembelajaran mendalam
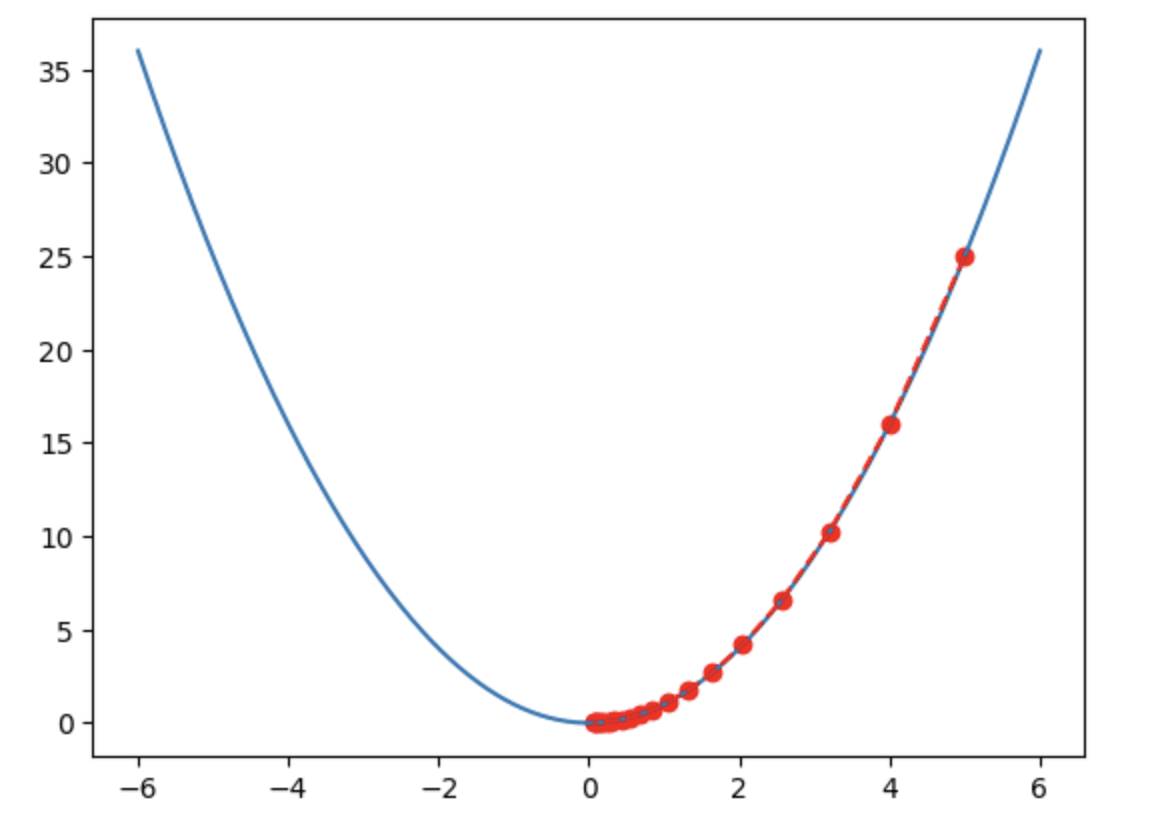
Pengoptimalan gradien adalah salah satu metode inti pembelajaran mendalam, yang memainkan peran penting dalam pelatihan jaringan saraf. Dalam jaringan saraf, serangkaian parameter lapisan pada dasarnya adalah bilangan real. Pelatihan jaringan melibatkan pengaturan parameter ini ke nilai realistis yang memungkinkan data dikirimkan dengan benar dan memicu keluaran yang diinginkan pada tahap akhir jaringan.
Metode pengoptimalan berbasis gradien telah membawa perubahan luar biasa di bidang jaringan saraf dan pembelajaran mendalam. Metode ini menggunakan gradien, yaitu pembedaan parameter setiap lapisan dalam jaringan terhadap kesalahannya. Dengan menerapkan aturan rantai, gradien dapat dipropagasi mundur ke seluruh jaringan hierarki. Dalam proses ini, Anda dapat menentukan di mana Anda berada pada permukaan kesalahan. Kesalahan dapat dimodelkan sebagai permukaan dalam ruang Euclidean, yang tampak sebagai wilayah yang penuh dengan tinggi dan rendah. Tujuan dari optimasi adalah untuk menemukan area yang meminimalkan kesalahan.
Gradien menunjukkan untuk setiap lapisan di mana Anda berada di permukaan dan arah di mana Anda harus memperbarui parameternya. Anda dapat menggunakan gradien untuk menavigasi permukaan bergelombang ini dan menemukan arah yang mengurangi kesalahan. Besar kecilnya anak tangga tergantung pada kemiringan permukaan. Jika curam, Anda akan melompat lebih jauh; jika tidak curam, Anda akan melompat lebih kecil. Intinya, Anda hanya menavigasi permukaan, mencari alur, dan gradien membantu Anda menentukan posisi dan arah.
Metode ini merupakan terobosan besar karena gradien memberikan sinyal yang jelas dan arah yang berguna yang dapat memandu Anda secara lebih efektif ke tempat Anda berada di permukaan dan di mana Anda berada daripada membuat lompatan acak dalam ruang parameter di puncak gunung di jurang atau di daerah datar.
Meskipun terdapat banyak teknik dalam pembelajaran mendalam untuk memecahkan masalah dalam menemukan solusi optimal, situasi di dunia nyata seringkali lebih kompleks. Ada banyak teknik regularisasi yang digunakan dalam pelatihan pembelajaran mendalam sehingga lebih merupakan seni daripada sains. Dan inilah mengapa pengoptimalan berbasis gradien dalam kehidupan nyata lebih merupakan seni daripada ilmu pasti.
Meringkaskan
Tujuan Gensyn adalah membangun sistem sumber daya komputasi pembelajaran mesin terbesar di dunia, yang dapat memanfaatkan sepenuhnya sumber daya komputasi yang menganggur atau kurang dimanfaatkan, seperti ponsel cerdas pribadi, komputer, dan perangkat lainnya.
Dalam konteks pembelajaran mesin dan blockchain, catatan yang disimpan dalam buku besar biasanya merupakan hasil perhitungan, yaitu keadaan data yang telah kita proses melalui pembelajaran mesin. Status ini dapat berupa: "Saya telah mempelajari gelombang data ini dengan mesin, valid, dan terjadi dalam X tahun dan X bulan." Tujuan utama pencatatan ini adalah untuk menyatakan status yang dihasilkan, bukan merinci proses penghitungan.
Dalam kerangka ini, blockchain memainkan peran penting:
Blockchain menyediakan cara untuk mencatat hasil status data. Hal ini dirancang untuk memastikan keaslian data dan mencegah gangguan dan penolakan.
Terdapat mekanisme insentif ekonomi di dalam blockchain, yang melaluinya perilaku berbagai peran dalam jaringan komputasi dapat dikoordinasikan, seperti empat peran yang disebutkan: pengirim, pekerja, verifikator, dan pelapor.
Melalui survei pasar komputasi awan saat ini, kami menemukan bahwa komputasi awan tidak sepenuhnya tidak diinginkan, namun berbagai metode komputasi memiliki masalah spesifiknya masing-masing. Metode komputasi terdesentralisasi dari blockchain dapat berperan dalam beberapa skenario, namun tidak dapat sepenuhnya menggantikan komputasi awan tradisional. Dengan kata lain, blockchain bukanlah solusi obat mujarab.
Terakhir, AI dapat dianggap sebagai salah satu jenis produktivitas. Namun, cara mengatur dan melatih AI secara efektif termasuk dalam kategori hubungan produksi. Hal ini mencakup faktor-faktor seperti kolaborasi, crowdsourcing, dan insentif. Dalam hal ini, Web 3.0 menawarkan sejumlah besar kemungkinan solusi dan skenario.
Oleh karena itu, kita dapat memahami bahwa kombinasi blockchain dan AI, khususnya dalam hal berbagi data dan model, koordinasi sumber daya komputasi, dan verifikasi hasil, memberikan solusi baru untuk beberapa masalah dalam pelatihan dan kemungkinan penggunaan AI.
Mengutip
1. https://docs.gensyn.ai/litepaper/
2. https://a16zcrypto.com/posts/announcement/investing-in-gensyn/