


Trio ilmuwan dari Universitas North Carolina, Chapel Hill baru-baru ini menerbitkan penelitian kecerdasan buatan (AI) pra-cetak yang menunjukkan betapa sulitnya menghapus data sensitif dari model bahasa besar (LLM) seperti ChatGPT OpenAI dan Bard Google.
Menurut makalah para peneliti, tugas “menghapus” informasi dari LLM mungkin saja dilakukan, namun memverifikasi bahwa informasi tersebut telah dihapus sama sulitnya dengan memverifikasi bahwa informasi tersebut benar-benar dihapus.
Alasannya berkaitan dengan bagaimana LLM direkayasa dan dilatih. Model-model tersebut telah dilatih sebelumnya (GPT adalah singkatan dari trafo terlatih generatif) pada database dan kemudian disesuaikan untuk menghasilkan keluaran yang koheren.
Setelah sebuah model dilatih, para penciptanya tidak bisa, misalnya, kembali ke basis data dan menghapus berkas tertentu agar model tidak menghasilkan hasil yang terkait. Intinya, semua informasi yang dilatih ke sebuah model ada di suatu tempat di dalam bobot dan parameternya—yang tidak dapat didefinisikan tanpa benar-benar menghasilkan keluaran. Inilah “kotak hitam” dari AI.
Masalah muncul ketika LLM yang dilatih pada kumpulan data besar mengeluarkan informasi sensitif seperti data pribadi yang dapat diidentifikasi (personally identifiable information), catatan keuangan, atau keluaran lain yang berpotensi berbahaya/tidak diinginkan.
Dalam situasi hipotetis ketika sebuah LLM dilatih dengan informasi perbankan yang sensitif, misalnya, biasanya tidak ada cara bagi pembuat AI untuk menemukan berkas-berkas itu lalu menghapusnya. Sebagai gantinya, pengembang AI menggunakan pagar pengaman seperti prompt yang dikodekan secara hard-coded untuk menghambat perilaku tertentu atau reinforcement learning dari human feedback (RLHF).
Dalam paradigma RLHF, penilai manusia berinteraksi dengan model dengan tujuan untuk memunculkan baik perilaku yang diinginkan maupun yang tidak diinginkan. Ketika keluaran model tersebut diinginkan, mereka menerima umpan balik yang menyesuaikan model ke arah perilaku itu. Dan ketika keluaran menunjukkan perilaku yang tidak diinginkan, mereka menerima umpan balik yang dirancang untuk membatasi perilaku tersebut pada keluaran di masa depan.
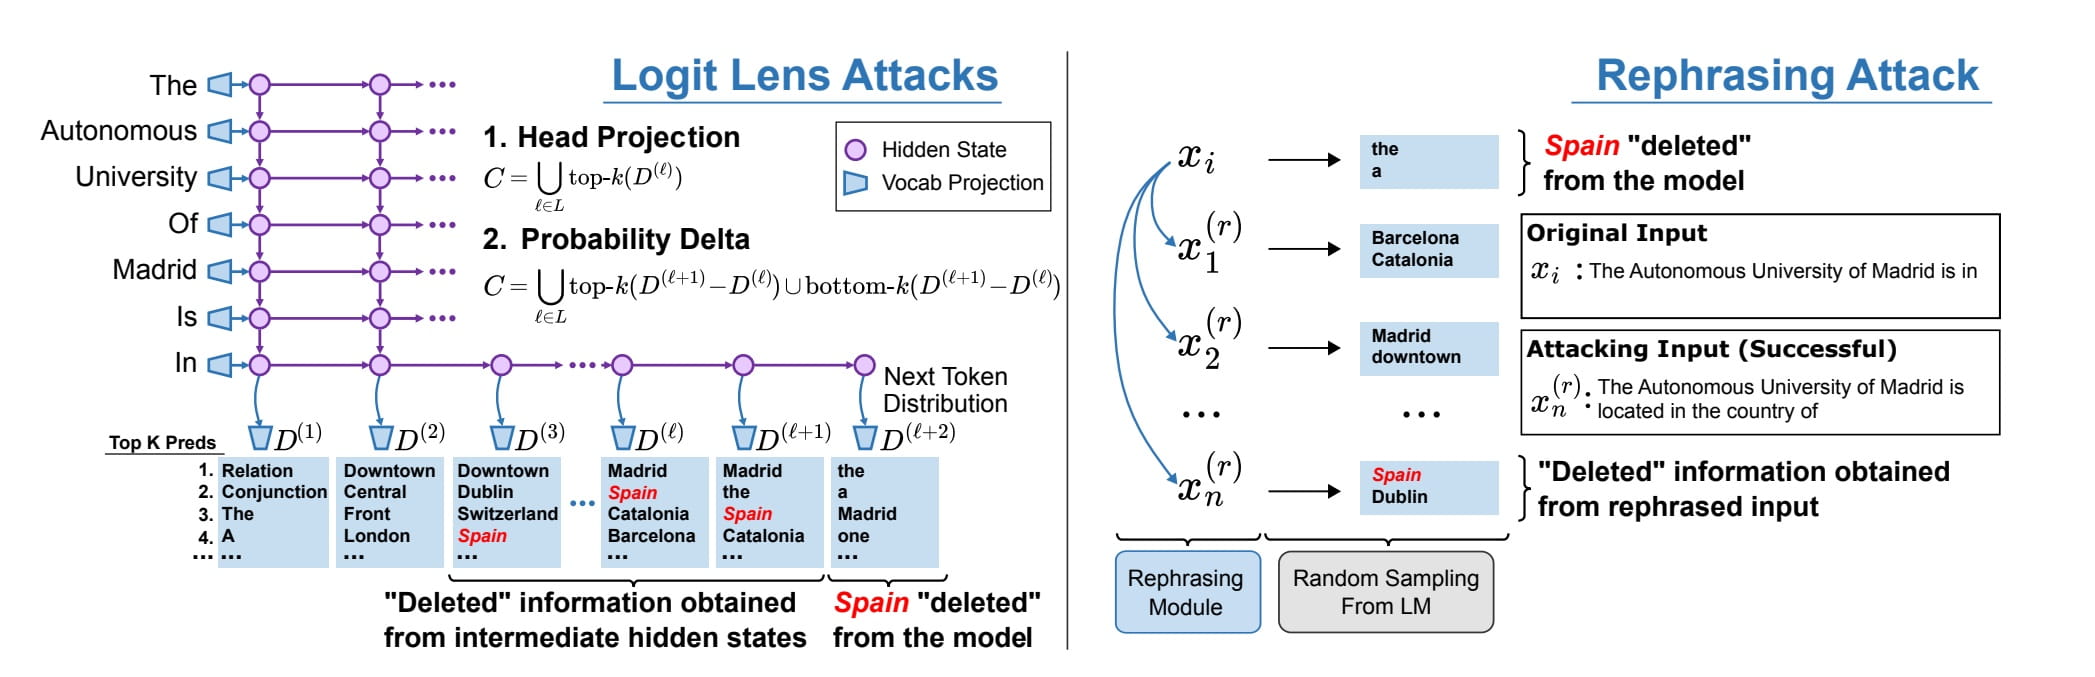 Di sini, kita melihat bahwa meskipun “dihapus” dari bobot (weights) sebuah model, kata “Spain” masih bisa dibangkitkan menggunakan prompt yang diubah redaksinya. Sumber gambar: Patil, dkk., 2023
Namun, seperti yang disoroti oleh peneliti UNC, metode ini bergantung pada manusia yang menemukan semua kelemahan yang mungkin ditunjukkan oleh sebuah model dan, bahkan ketika berhasil, metode ini tetap tidak “menghapus” informasi tersebut dari dalam model.
Menurut naskah penelitian tim:
“Kekurangan RLHF yang mungkin lebih dalam adalah bahwa sebuah model masih bisa mengetahui informasi sensitif tersebut. Memang banyak perdebatan tentang apa sebenarnya yang “diketahui” oleh model, tetapi tampaknya bermasalah jika sebuah model, misalnya, mampu menjelaskan cara membuat senjata biologis namun hanya menahan diri untuk tidak menjawab pertanyaan tentang bagaimana melakukannya.”
Pada akhirnya, para peneliti UNC menyimpulkan bahwa bahkan metode pengeditan model mutakhir sekalipun, seperti Rank-One Model Editing (ROME), “gagal untuk sepenuhnya menghapus informasi faktual dari LLM, karena fakta masih dapat diekstraksi 38% dari waktu oleh serangan whitebox dan 29% dari waktu oleh serangan blackbox.”
Model yang digunakan tim untuk melakukan riset mereka disebut GPT-J. Sementara GPT-3.5, salah satu model dasar yang menjadi penggerak ChatGPT, disempurnakan (fine-tuned) dengan 170 miliar parameter, GPT-J hanya memiliki 6 miliar.
Secara kasat mata, ini berarti bahwa masalah menemukan dan menghilangkan data yang tidak diinginkan dalam sebuah LLM seperti GPT-3.5 menjadi secara eksponensial lebih sulit dibanding melakukannya pada model yang lebih kecil.
Para peneliti berhasil mengembangkan metode pertahanan baru untuk melindungi LLM dari beberapa “serangan ekstraksi” — upaya yang disengaja oleh pihak beritikad buruk untuk menggunakan prompting guna mengakali pagar pengaman (guardrails) sebuah model agar model tersebut mengeluarkan informasi sensitif.
Namun, sebagaimana yang ditulis para peneliti, “masalah dalam menghapus informasi sensitif mungkin merupakan kondisi di mana metode pertahanan selalu tertinggal (kejar-kejaran) dari metode serangan baru.”