

花儿不在
17 Publications
花儿不在
Signaler
Bloquer l’utilisateur
2 Suivis
5 Abonnés
3 J’aime
Publications
·
--
Voir la traduction
#opg $OPG
今天必须得唠唠OpenGradient——不是因为它画饼画得圆,是因为币安HODLer空投今天刚上线。我翻了一下午白皮书,发现这项目确实有点东西
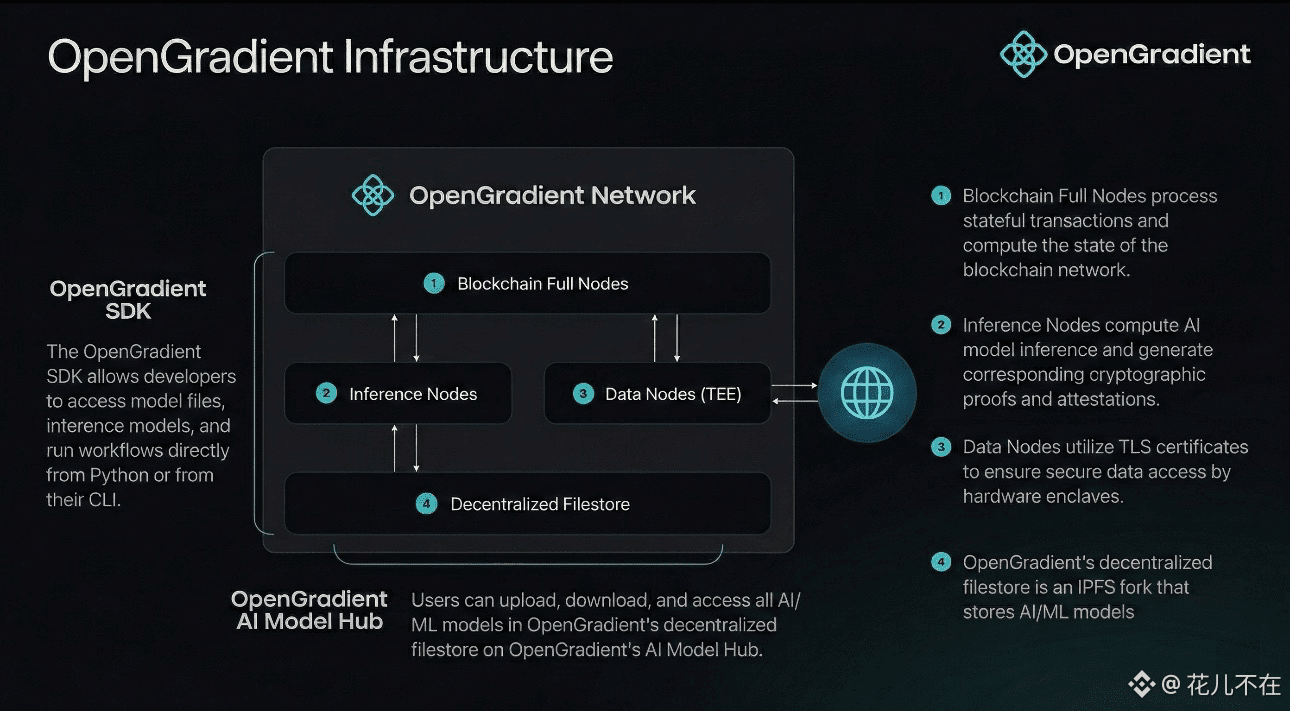
先说技术。如果让链上每个节点都去跑一遍大模型,网络直接瘫痪。OpenGradient白皮书里有句原话特别实在——“让每个验证节点独立重跑模型推理是不切实际的”。所以他们搞了套混合AI计算架构(HACA) ,把“执行”和“验证”彻底分开。推理节点用GPU和TEE跑模型、干重活;全节点只管验证TEE认证和ZKML证明、记个账。你不需要重跑一遍模型,只需要验证它跑对了。验证节点可以很轻量——就这么一个简单的认知转换,把性能和信任全解决了
再说产品。他们家那个Opg Chat,能直接用ChatGPT、Claude、Gemini、Grok这些模型,还能生成图片、传文件。关键是设备端加密——信息在离开浏览器之前就本地加密了,密钥只在你设备上。经过Oblivious HTTP中继时,中继能看到你的IP但只有密文;下游网关能看到明文但永远看不到你的IP。到了TEE隔离网关里才解密处理。而且TEE带远程认证,你可以自己验证这些隐私承诺。这相当于给你配了辆全封闭的超级运钞车——除了你自己,没人知道里面装了啥。Opg Chat上线两周已经服务超200万用户,处理了200多万次可验证推理。Model Hub上还集成了2000多个模型
在算经济账。OPG总量10亿枚,流通约1.98亿枚。a16z crypto领投、Coinbase Ventures、SV Angel、Foresight Ventures等24家机构累计投了950万美元。币安第66期HODLer空投今天刚上线。但我也得说句实在话——空投是机会,可别光盯着糖果忘了脚下的荆棘。当前价格$0.15左右,全流通市值(FDV)超1.5亿美元,80%的代币还没解锁呢。项目还在测试网阶段,技术没大规模验证
我的结论很简单——技术叙事能打,空投机会真实,但80%未解锁的代币是悬在头顶的剑 @OpenGradient
1
127
·
--
Voir la traduction
昨晚翻OpenGradient的文档翻到凌晨一点。看到"异步验证"四个字的时候,条件反射般地按了Ctrl+F,输入"验证失败"。
0 results。
又试了"failure"、"settlement"、"rollback"。全都没有。
HACA的设计其实很聪明。传统区块链让每个验证者重跑每笔交易,AI推理又贵又非确定,根本跑不动。OpenGradient的解法是把执行和验证拆开:推理节点跑模型,毫秒级返回结果;全节点异步验证TEE证明。验证节点不需要知道prompt是什么、模型是什么,只需要确认代码在飞地中未被篡改。
问题恰恰出在这儿。官方文档写得清楚:TEE证明验证的是"enclave was not tampered with",不是结果本身对不对。推理节点完全可以在TEE里"正确"跑完模型,返回一个错误结果——证明照样过。文档承认有"临时的信任缺口",但这个缺口怎么补,只字未提。$OPG
Gate学院有篇文章提到"验证失败,结果将被拒绝或重新计算"。可重新计算的钱谁出?已经执行的交易怎么回滚?官方文档里连个TODO都没留
你看看DeFi,验证失败有清算和罚没兜底;再看看乐观Rollup,有挑战期和欺诈证明。OpenGradient把"先出结果、后验证"当卖点,烂摊子谁来收拾——目前看是用户自己扛。#OPG
架构方向没问题。但在主网经济模型完整公布、验证失败处理机制写进文档之前,这笔账我得先算清楚。@OpenGradient
1
78
·
--
Ne devine pas si le grand modèle t’a été remplacé en arrière-plan par une version distillée : je me suis déjà fait avoir sur ce coup-là. J’ai passé deux semaines à régler les prompts, puis une fois en production, les résultats montaient et descendaient sans cesse. La plateforme a juré que la version était identique, et toi, tu n’as même aucun moyen de te prouver que c’est toi qui as raison.
La méthode de rupture d’OpenGradient ne joue pas au bluff : elle enferme l’inférence dans une zone de sécurité TEE sur le CPU. En quoi cette “cage de fer” est-elle si redoutable ? Dès que la puissance de calcul démarre, même le root des fournisseurs de cloud ne peut pas ouvrir le rideau de données : l’entrée et la sortie sont isolées au niveau physique. Mais cela ne résout qu’une partie du problème — comment garantir qu’on exécute bien du GPT-4 et pas du GPT-3.5 ? Le hachage des poids du modèle est verrouillé à l’avance, inscrit en dur sur la chaîne dans le Registry. À la fin de l’inférence, le matériel émet une signature/ticket de preuve. Si les deux côtés ne correspondent pas, le tout est annulé. L’exécution est l’exécution, l’audit est l’audit : double validation, contrôle croisé à deux, et si l’un manque, c’est la chute. $OPG
Dans cette boucle fermée, l’OPG fait office de “compteur”. À chaque appel, il prélève automatiquement des frais via le protocole x402. Les développeurs n’ont plus qu’à brancher un SDK Python : ils n’ont pas à s’occuper de tout ce bazar de validation de signature en arrière-plan, ils ne font que coder la logique métier. L’OPG n’a rien d’inoffensif — et ce n’est pas pour rien. Plus le réseau traite d’inférences aujourd’hui (100 000 fois, donc 100 000 fois des frais qui circulent), plus l’actif “sonne juste” ; et si on passe à 1 million, ça double quasiment comme une monnaie forte — la logique d’évaluation est bien plus solide que ces MEME coins qui font des slides. #OPG
Compare avec le marché : une API centralisée repose uniquement sur la confiance ; la vérification avec zkML prend certes quelques secondes, mais en usage commercial ça fait fuir. OpenGradient a choisi une voie de compromis : sacrifier l’extrême centralisation pour obtenir une décentralisation poussée et permettre une vérifiabilité à l’échelle de la milliseconde. Ne me sors pas des histoires d’un “IA décentralisée” idéale : quand cette techno commence vraiment à approuver des prêts pour les gens ou à gérer des placements privés, “vérifiable” n’est pas un bonus, c’est un passeport pour entrer. Celui qui tient en main des preuves de pureté au niveau matériel qui tiennent la route, verrouille le cou de la prochaine génération d’IA financière. Les gens qui vendent juste du concept, ils peuvent rester sur le bas-côté. @OpenGradient
82
·
--
Voir la traduction
99%的人把质押当存钱罐,但@OpenGradient 白皮书第4.3节有一行被划过去的“魔鬼细节”——错误证明罚没(Slash)。读到这里我后背发凉:质押根本不是生息工具,而是AI推理的“信用保险金”。
验证者质押OPG,不是在挖矿,是在给网络写“欠条”:我对这次验证负责,错了,真金白银赔。OpenGradient每一次AI推理返回结果,背后都有人在用资产担保它的准确性。
对比传统AI就扎心了。 OpenAI、Claude、Gemini,全建立在“无成本证词”之上——模型没篡改?硬件没问题?全靠口头承诺。OpenGradient把道德约束换成了经济约束,把“我相信你”变成了“你不敢骗我,因为骗我有成本”。
这引出一个多数人没算过的供应侧推论:
质押中的OPG退出需要解绑期,Slash风险悬顶时,轻率退出的机会成本比留着更高。所以链上那批OPG,不是因为持有人看好,是因为被机制焊死在那里——被动锁仓和主动持有,是两码事。
如果Slash真实运行,OPG的供需模型将彻底重构:网络越繁荣→验证者需求越多→被责任锁死的筹码比例越高→自由流通盘越稀缺。这是一个非线性的通缩斜率。
当然,风险也摆在那: 验证者节点是否真实增长?Slash是否真实发生?这两组数据目前还是黑盒。但市场往往在“看不清”的时候定价最狠。
当别人还在卷TEE和ZKML技术名词时,聪明钱已经开始计算罚没机制带来的天然买盘压力。质押量决定网络的安全上限,而安全上限决定估值天花板——这个叙事,比单纯的AI Meme硬核十倍。
方向对了,数据会说话。静待验证者地址公开的那天。$OPG #opg @OpenGradient
1
94
·
--
Voir la traduction
#opg $OPG 周末在咖啡店被店员安利“隐藏菜单”,满怀期待点了一杯——不过是普通拿铁加了焦糖糖浆。这让我想起币圈那些号称“AI革新”的项目,大多只是给大模型套了个发币的壳。但深度体验@OpenGradient后,确实让我改观不少。
它的HACA混合AI计算架构打破了我对“区块链+AI=慢”的刻板印象。 传统区块链靠每个验证节点重复执行每笔交易达成共识,跑大模型在计算上完全不可行。HACA将网络拆分为三个专业角色:推理节点跑模型并生成可验证证明,全节点只验证证明的密码学有效性,数据节点获取可信外部输入。用户先拿结果,验证和结算异步完成——既保住Web2级速度,又锁死链上信任。
更让我觉得“真不一样”的是它的隐私设计。 OpenGradient Chat处理敏感信息时,消息在浏览器端就完成加密,密钥只存在你的设备上;通过Oblivious HTTP匿名中继后,在TEE可信环境中解密处理——运营方既看不到你是谁,也读不懂内容。对比ChatGPT们拿对话喂模型的套路,这才是真正的“架构级隐私”。
数据印证落地速度:4月上线Base以来,已托管超2000个模型、验证超50万份证明、处理超200万次推理。但我心里始终有个结:AI的“黑盒幻觉”与区块链的“透明契约”天生冲突。若模型推理出错,链上自动决策的风险谁来担?目前我只拿小仓位参与观望,既不盲目押注,也不愿错过。
当AI既能极速服务又能锁死隐私,它会是巨头的劲敌,还是一场技术豪赌?且看它下一步怎么解题@OpenGradient
88
·
--
Voir la traduction
#opg $OPG 异步结算的代价@OpenGradient OpenGradient x402机制下被转嫁的节点资金效率风险
Opg的x402支付协议常被包装为“Web2级低延迟”体验,但其核心机制暗含结构性缺陷:异步结算模式将资金效率与价格波动风险完全转嫁给算力节点,在商用批量推理场景下存在先天不适配
机制拆解:预授权≠即时结算 用户发起推理前通过Permit2完成链上预授权,批准OPG额度给结算合约;节点消耗GPU算力返回结果后,OPG代币的正式扣款与划转才在Base链上异步完成。执行与结算在时空上被彻底剥离——节点“先干活”资金“后到账”
对比基准:前置扣款vs后置结算的范式冲突。AWS、GCP等主流云平台均执行“资金到位,算力启动”,或预冻结余额,或实时扣费;去中心化竞品也多采用“预付充值、按秒扣费、余额耗尽即停机”的硬约束。x402的Permit2预授权仅解决“防用户跑单”,却回避了“钱在路上”的账期与汇损问题,本质是将流动性杠杆强行加给硬件提供者
量化视角:三重压力下的收益侵蚀。 面向B端批量推理时:Base链结算拥堵致资金到账窗口延长至12-15个区块(约3-5分钟)此窗口内OPG价格波动带来0.5%-2%的隐性滑点;月均10万次推理的中型节点,未到账资金日均沉淀约5000枚OPG,折算链上借贷成本,每月侵蚀4%以上净利润。GPU电费与折旧是刚性支出,收入却存在不确定延迟,节点现金流安全边际被持续压缩
破局推演:协议层必须补齐的“解药”。 若要保持算力供给稳定,x402须引入动态汇率锚定机制(如按5分钟TWAP均价结算),或设立节点流动性预支池对冲账期风险。否则,Web2级的响应速度与Web3级的结算摩擦之间,终将形成算力供给失血的“成本无底洞”。先服务、后结算,看似保障用户体验,实则将财务风险全额转嫁——这套经济设计的长期可持续性,值得每个算力提供者审慎重估
1
1
80
·
--
#opg $OPG
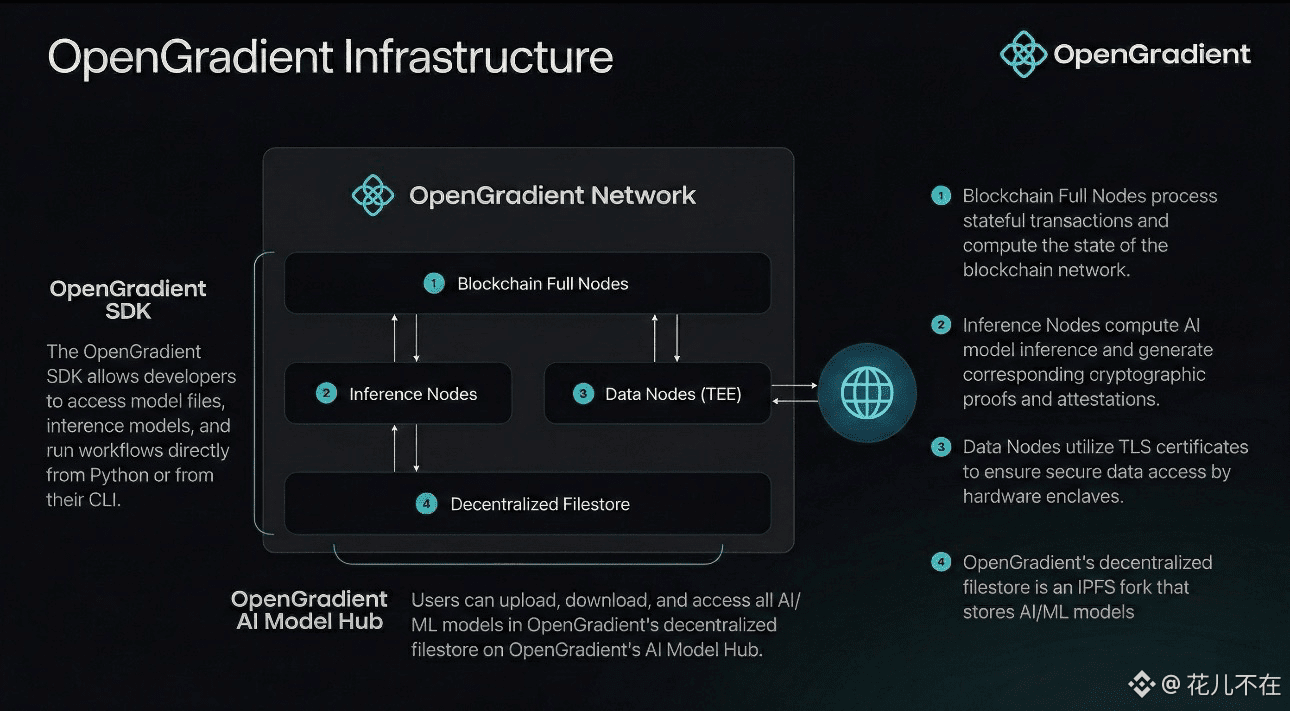
Aujourd'hui, on ne va pas tourner autour du pot. OpenGradient, j'ai enfin pigé ce truc récemment. Avant, dès que je voyais des termes comme nœud complet ou preuve à divulgation nulle de connaissance, ma tête tournait, je pensais que c'était trop éloigné de moi. Mais en prenant le temps de creuser un peu, en gros, c'est un groupe de comptables sérieux qui te fait office de gardien. N'importe quelle machine sur le réseau qui fait tourner un modèle d'IA, que ce soit pour de l'inférence ou de l'entraînement, dès qu'elle sort un résultat, tu dois remettre le livre de comptes à ces nœuds complets. Ces gars-là ont des formules cryptographiques et des rapports sur le matériel TEE dans les mains, et s'ils trouvent une incohérence, ils balancent ça sur toute la toile. Et entre eux, ils s'assurent de tout vérifier, pas question de laisser passer le moindre détail. Dans les grandes entreprises traditionnelles, si les données sont erronées, ils se contentent d'envoyer un mail d'excuses en espérant que tu leur fasses confiance. Ici ? La confiance ne vaut rien, si les maths disent que tu n'es pas conforme, peu importe à qui tu te confies, les nœuds complets ne te donneront pas le feu vert, c'est mort.
Tu dois te demander, et si les nœuds complets décident de faire les malins ? Ils ne sont pas idiots, ils doivent staker, verrouiller une grosse somme de jetons OPG pour pouvoir jouer. Le système surveille ça tous les jours, si quelqu'un essaie de tricher ou de prendre des libertés, il se fait directement confisquer ses jetons. Pas cool, non ? En revanche, ceux qui font le job sérieusement, en débusquant les tricheurs, sont récompensés en OPG, et ça a un prix, qui pourrait être contre l'argent ? Ce système est brillant car il met de côté les relations personnelles et se base uniquement sur les intérêts et les maths qui s'entremêlent. Les utilisateurs ordinaires n'ont même pas besoin de dépenser des milliers d'euros pour avoir une machine haut de gamme comme nœud, tu fais juste un appel en front-end, et ces bourriques en bas gèrent le reste, c'est super fiable. J'ai essayé plusieurs fois, pas besoin de supplier qui que ce soit, tu fais l'appel, et les résultats sont toujours au rendez-vous.
À l'avenir, pour le traitement des données sensibles par l'IA, m'appuyer sur ces nœuds qui ne laissent rien passer sera bien plus solide que n'importe quel CEO qui se vante. Remplacer les promesses par des validations mathématiques, ça me parle. Et ces nœuds, pour gagner de l'OPG, vérifient tout mieux que quiconque, tu veux berner ? Pas moyen. J'adore cette rigueur, pas besoin de plaire à qui que ce soit, tout repose sur l'algorithme et le hardware. Tu trouves pas que c'est bien mieux que ces projets qui crient “transparence” mais ne montrent rien ? De toute façon, à l'avenir, pour l'IA, je ne jure que par cette couche sous-jacente, ça me rassure. @OpenGradient
67
·
--
Voir la traduction
#opg $OPG 你有没有想过,每次调用一个AI风控模型,真正危险的其实不是它“读”你的输入,而是它去后台取数据的那一瞬间?
我做过系统运维,见过太多日志里明晃晃地躺着用户ID、账户余额、最近几笔交易的触发原因。排查问题嘛,免不了翻请求参数和返回结果,可翻着翻着,一些不该看的东西就进了眼。这不是谁坏,是架构本身就没把“取数”当回事——应用服务器一手握着接口权限,一手把数据喂给模型,中间所有痕迹全留在普通日志里。外部数据源越多,这摊水就越浑,运维人员不知不觉就成了隐私的隐形观察者。
OpenGradient 的 Data Nodes 切的就是这个入口。它不是简单加个代理,而是把“拉数据”这个动作单独拎出来,塞进一个隔离的执行环境里。任务只告诉它“去查什么”和“按什么规则查”,真正的读取在 TEE 里头完成——那个环境连主机操作系统都插不进手,节点运营者想翻日志?翻到的全是乱码
但这还不够。我最在意的是它怎么证明自己没换料。Data Node 返回数据时,会附带一份远程认证凭据,相当于一个加密的“收货单”,写着:这份数据是某时某刻在指定环境里按指定条件取的。后面的推理节点拿着数据干活,验证节点只检查这张单子真不真。想偷换数据?单子对不上,全链驳回。验证的人自始至终不用看明文,这才是闭环
这套东西解决了一个很实在的困局:实时数据用越多,造假空间就越大;权限越集中,信任就越脆弱。以前我们靠“相信运维不会偷看”,现在把信任替换成可验证的流程——取数有隔离,结果有证明,追责有依据。隐私不再是一句承诺,而是被拆进架构里的硬条件。就这么简单@OpenGradient
81
·
--
Voir la traduction
#opg $OPG 上次让AI帮我算笔定投收益,结果它把年化瞎翻了一倍,我差点头脑一热全仓冲进去。后来才反应过来,这玩意儿背后咋算的,我压根没地儿查,跟个黑箱似的。所以看到OpenGradient要砸箱子搞透明,我这种被坑过的新韭菜第一个想鼓掌。
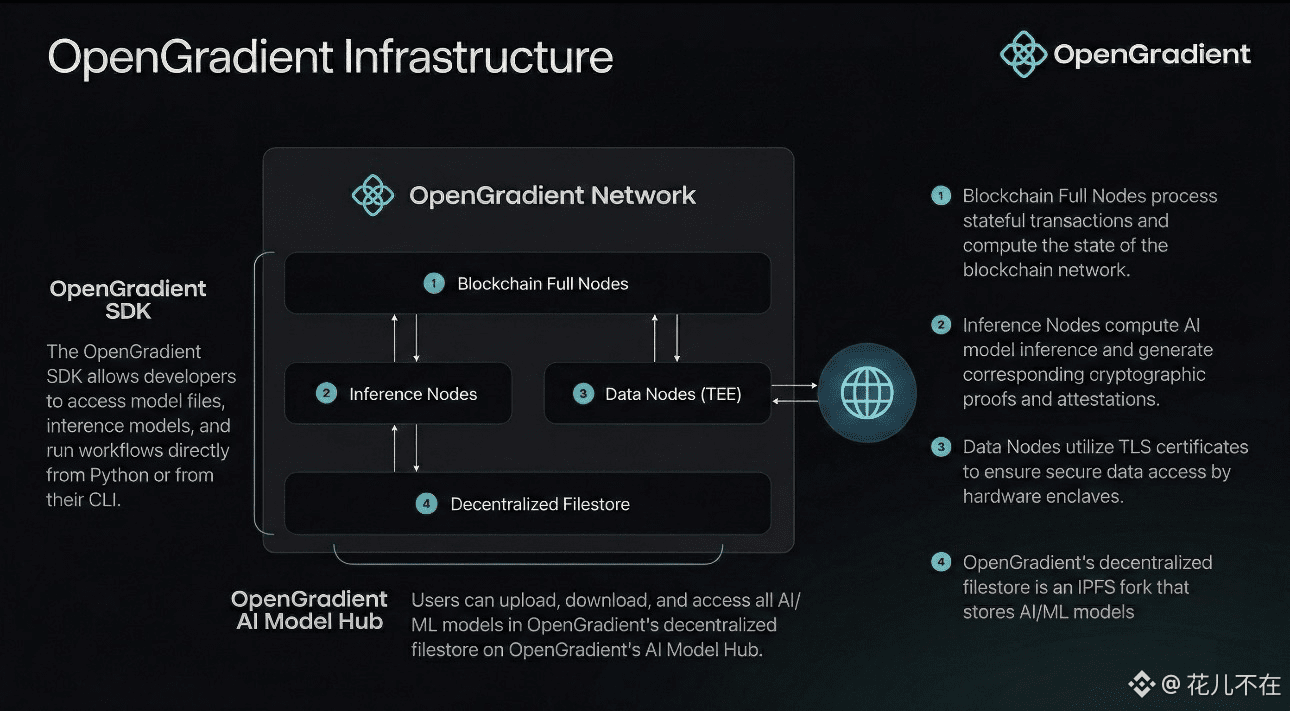
它跟那些只会卷参数、卷视频多逼真的大厂不一样,核心就干一件事:把AI推理的过程,变成人人都能查的“公开账本”。怎么做到的?得拆开它的混合AI计算架构(HACA)。简单说就四个字:执行和验证分开干。
以前想把AI上链有个死结——让100个节点都去重跑一遍大模型,成本贵上天不说,大模型带“温度系数”每次回答还不一样,根本达不成共识。HACA直接换了思路:推理节点先跑模型快速出结果(这是快路径),同时异步生成密码学证明(慢路径),用的是TEE可信环境或者ZKML零知识证明。全链节点不重跑模型,只花几毫秒验证这个证明有没有效,底层用CometBFT共识拍板上链,谁也别想篡改。这套组合拳打下来,链上已经托管了4400多个模型,干了200多万次可验证推理,产出了50多万份证明,全是实打实的链上数据。
那让这套“透明监控”转起来的油钱,就是OPG代币。我们散户花OPG调用推理,节点赚服务费;想当节点得先质押OPG入场,要是敢在数据上搞鬼,质押物直接罚没。这套“付费干活、干坏赔钱”的玩法,等于把“不作恶”变成了经济账,比指望大厂良心靠谱一万倍。
以后我再用AI,就认准这种能查监控的。聪明但心眼多的机器,我这种新韭菜真伺候不起。@OpenGradient
99
·
--
Voir la traduction
#opg $OPG OpenGradient的白皮书翻来覆去,x402结算层才是真正要命的关卡。这玩意儿干的是AI推理上链的活儿,$OPG拿来付Gas和质押。但重点不在技术,在它丢给开发者三个选项——PRIVATE、BATCH_HASHED、INDIVIDUAL_FULL——看着像体贴,实则是把合规炸弹塞你手里,引爆时间由你定。
PRIVATE:链上不留痕。隐私保住了,但“可验证AI”的招牌直接碎一地。监管来查账,你拿什么证明Agent没作弊?空气吗?
INDIVIDUAL_FULL:完整日志永久上链。白皮书说适合“公开可审计的DeFi Agent”,翻译成白话:用户借钱额度、清算阈值、策略推理全裸奔。对手只要扫链,就能精准狙击你的头寸,比内幕交易还爽。
BATCH_HASHED:默克尔聚合,默认选项。成本低、验证可行、隐私凑合——但这是“三不沾”的妥协品。监管说“提交原始日志”,你给个哈希,法官能认?
说个真事儿:假设你跑个借贷Agent,选了FULL模式,某用户查询“最高可借多少”的推理过程全上链,对手据此算出他的风险敞口,直接抢跑清算。你赔的是真金白银,用户告的是你泄露隐私。而OpenGradient早把锅甩干净了——SDK里一个settlement_mode参数,开发者自己勾,出事别找项目方。
我的实盘策略,不玩虚的:主网上线前三个月,只跑非核心业务,强制BATCH_HASHED。同时盯住两个指标——链上审计请求频率,以及各模式下的纠纷投诉量。第三个月底,哪个模式出事率最低、监管摩擦最小,再决定把多少业务逻辑迁过去。在此之前,核心推理全部本地完成,只把验证哈希扔上链。
记住:链上AI的推理记录,不是存得越多越安全,而是存得刚好能自证、刚好不违规。 这条线没人替你画,得拿自己的仓位去试。但试之前,先把保命的底线划清楚——没摸清数据归宿,别把底牌全押上去@OpenGradient
#opg $OPG OpenGradient的白皮书翻来覆去,x402结算层才是真正要命的关卡。这玩意儿干的是AI推理上链的活儿,$OPG 拿来付Gas和质押。但重点不在技术,在它丢给开发者三个选项——PRIVATE、BATCH_HASHED、INDIVIDUAL_FULL——看着像体贴,实则是把合规炸弹塞你手里,引爆时间由你定。
PRIVATE:链上不留痕。隐私保住了,但“可验证AI”的招牌直接碎一地。监管来查账,你拿什么证明Agent没作弊?空气吗?
INDIVIDUAL_FULL:完整日志永久上链。白皮书说适合“公开可审计的DeFi Agent”,翻译成白话:用户借钱额度、清算阈值、策略推理全裸奔。对手只要扫链,就能精准狙击你的头寸,比内幕交易还爽。
BATCH_HASHED:默克尔聚合,默认选项。成本低、验证可行、隐私凑合——但这是“三不沾”的妥协品。监管说“提交原始日志”,你给个哈希,法官能认?
说个真事儿:假设你跑个借贷Agent,选了FULL模式,某用户查询“最高可借多少”的推理过程全上链,对手据此算出他的风险敞口,直接抢跑清算。你赔的是真金白银,用户告的是你泄露隐私。而OpenGradient早把锅甩干净了——SDK里一个settlement_mode参数,开发者自己勾,出事别找项目方。
我的实盘策略,不玩虚的:主网上线前三个月,只跑非核心业务,强制BATCH_HASHED。同时盯住两个指标——链上审计请求频率,以及各模式下的纠纷投诉量。第三个月底,哪个模式出事率最低、监管摩擦最小,再决定把多少业务逻辑迁过去。在此之前,核心推理全部本地完成,只把验证哈希扔上链。
记住:链上AI的推理记录,不是存得越多越安全,而是存得刚好能自证、刚好不违规。 这条线没人替你画,得拿自己的仓位去试。但试之前,先把保命的底线划清楚——没摸清数据归宿,别把底牌全押上去@OpenGradient
2
91
·
--
#opg $OPG
Parlons d’OpenGradient : inutile de raconter des histoires sophistiquées, concentrons-nous plutôt sur son architecture HACA.
Quel est le défaut des blockchains traditionnelles ? Chaque nœud doit rejouer toutes les transactions. Vous transférez des fonds, pas de problème. Mais si vous faites tourner, sur 100 nœuds, un modèle de 70B chacun ? Les coûts sont multipliés par 100, le temps ne tient pas, et au final ce n’est même pas plus fiable. Le principe d’OpenGradient, c’est de séparer exécution et vérification : les nœuds d’inférence travaillent avec le GPU, puis ils produisent une preuve de certification TEE ou une preuve ZKML. Les nœuds complets se contentent de vérifier la preuve ; pas besoin de relancer bêtement le modèle.
Franchement, l’idée est techniquement plutôt solide. Les nœuds se répartissent en quatre “équipes” : les nœuds d’inférence exécutent le modèle, les nœuds complets enregistrent et vérifient les preuves, les nœuds de données alimentent avec des informations externes, et le stockage s’appuie sur Walrus. Mais où est le problème ? Les nœuds TEE doivent passer une authentification matérielle ; ce n’est pas quelque chose qu’une simple machine domestique peut faire tourner. Qui paie pour acheter des H100 ? Qui paie l’électricité de la salle serveur ?
J’ai justement relu le modèle économique du livre blanc. L’offre totale est de 1 milliard de tokens, et les récompenses de staking ne représentent qu’un dixième, libéré linéairement sur 96 mois. 96 mois, c’est quoi ? Huit ans. À la valorisation actuelle de l’OPG, la quantité libérée chaque mois, en moyenne, suffirait-elle à payer quelques climatiseurs ? L’exploitation des nœuds n’est pas une œuvre caritative : si les subventions s’arrêtent, la puissance de calcul tournera forcément plus vite que tout le monde.
Le projet affirme que, sur le réseau principal, ils ont effectué 2 millions d’inférences. Mais le nombre exact de nœuds d’inférence, et leurs configurations, n’a toujours pas été rendu public. Le récit technique est sexy, mais l’équation économique, ça tient ou pas ? Pour ma part, je garde la liste des nœuds en favoris ; je reviens faire l’audit dans trois mois. Est-ce que j’y fonce maintenant ? Je vais encore regarder : @OpenGradient
1
94
·
--
Voir la traduction
#opg $OPG 测了四天OpenGradient Chat,前后七八十条对话,从简单问答到多轮逻辑推理都试了,说点实操感受。
第一反应是快。晚上十一点和下午两三点都测过,高峰期也没明显卡顿,问完基本两秒内开始出字。翻白皮书第二章,他们把推理和验证拆成两条路径——GPU节点只管跑模型,结果单独走加密验证。这个设计实际体验中能感受到区别,不像有些项目,推理快了验证跟不上,或者验证做全了响应就拖垮。
但也有翻车。第三天晚上一条合约安全问题,推理很快,三秒出结果,但验证卡了快十秒,状态一直pending,差点以为断线。后来查链上记录,是某个验证节点出块慢了。白皮书不会写这种细节,但实际跑起来就是会遇到,这才是真实的链上AI。
再说节点分布。我找了两个跑过OPG节点的人聊,他们算了一笔账——目前OPG价格下,电费和机器折旧算进去,回本周期比官方说的长将近一倍。其中一个原话:“除非币价翻倍,不然扩机器就是赌。”目前全网推理节点就那么些,头部几个集中了大部分算力,这让我有点犹豫。
我的判断:拿它当中心化AI工具用,体验过关,甚至算好用。但链上验证那部分,暂时不会放大资金。等节点分散度从目前头部集中降到60%以下,再重新评估。OpenGradient的下限是验证路径在极端情况下会卡,上限看节点激励能否持续。用着爽和投着稳是两码事,我现在就盯着节点分布图看
@OpenGradient
102
·
--
Vérifié
#opg OPG token vaut-il vraiment le coup ? Parlons franchement
Pour commencer, la conclusion : OPG n'est pas un token à acheter les yeux fermés, mais sa logique de valeur est plus solide que la plupart des projets AI.
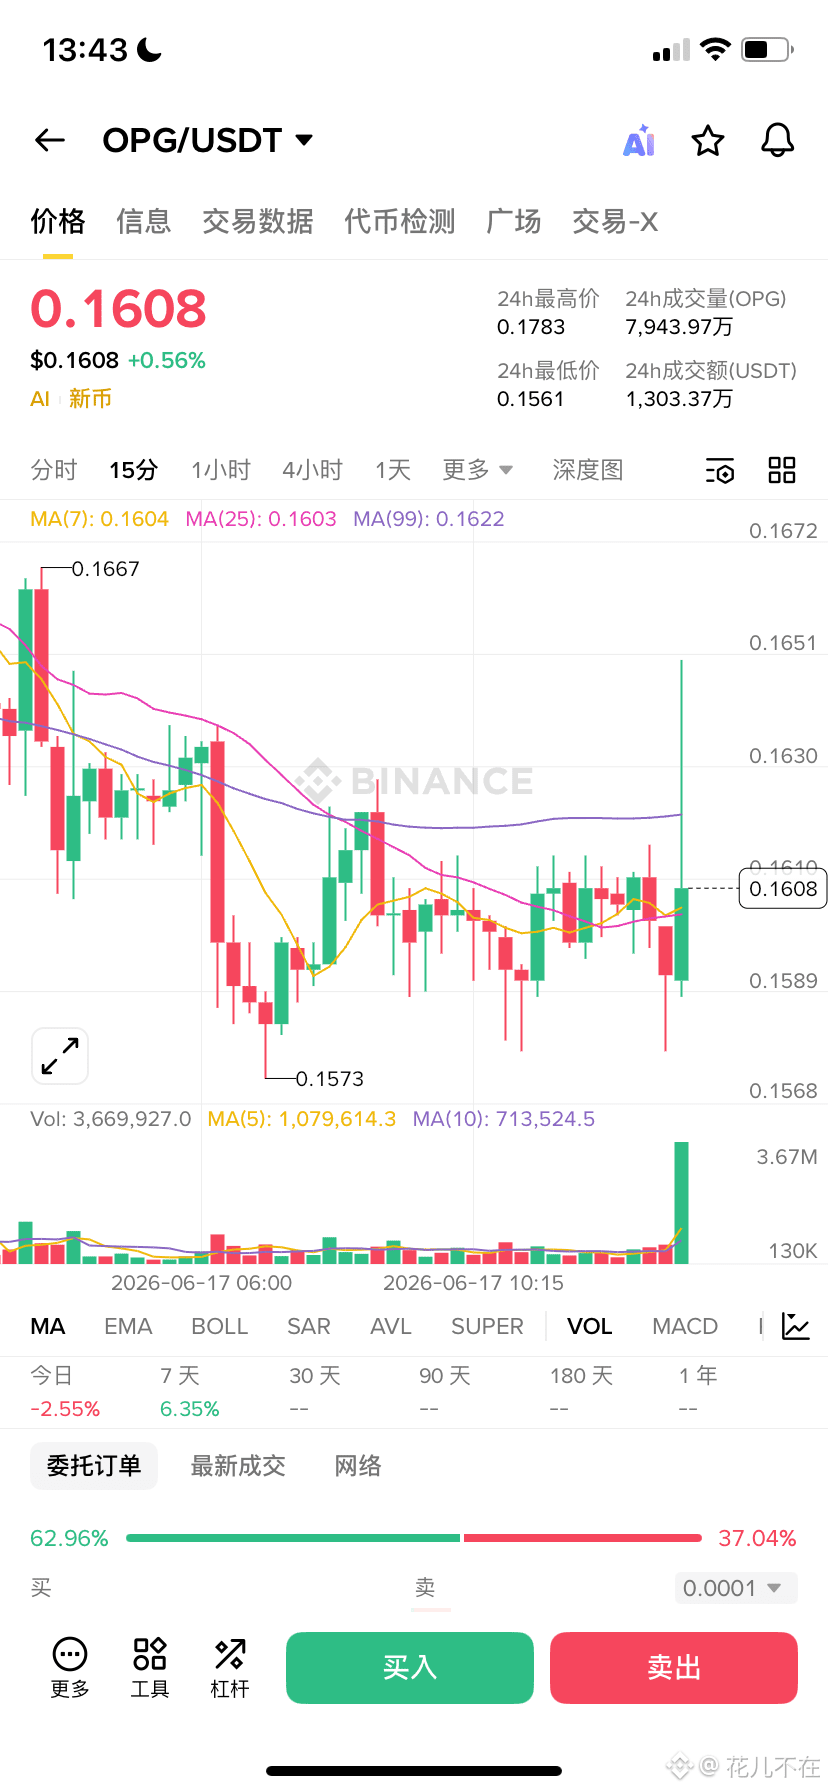
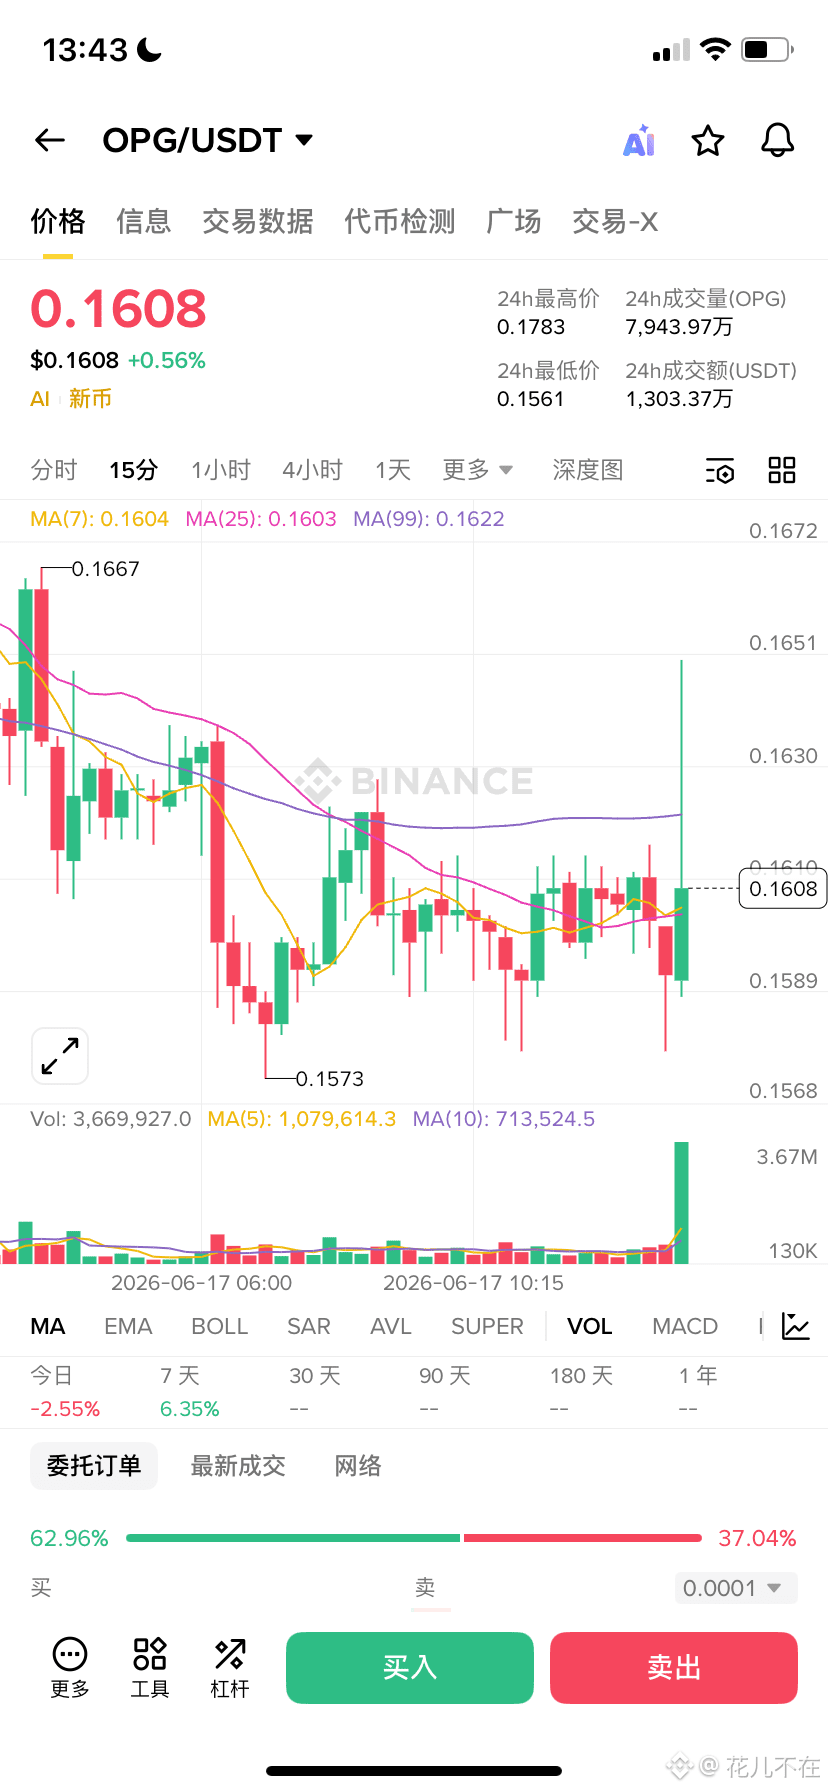
Beaucoup de gens demandent directement le prix, alors je vais te le dire, le 16 juin OPG est à 0,1618 dollars, avec une capitalisation de marché un peu plus de 30 millions. Mais ça, c'est pas le plus important. Tu dois d'abord comprendre une chose : ce token a-t-il vraiment une utilité ?
La demande est-elle réelle ou pas ?
OpenGradient a maintenant effectué plus de 2 millions de vérifications d'inférence AI, supportant plus de 2000 modèles. Chaque appel d'inférence nécessite de brûler des OPG. Ce ne sont pas des données gonflées par l'équipe du projet, c'est des enregistrements vérifiables sur la chaîne.
Binance a ajouté le spot le 22 mai, et Upbit en Corée a suivi. En gros, si de gros échanges sont prêts à l'accepter, ça veut dire qu'ils ont fait leur due diligence, ce n'est pas juste du vent.
Il y a un mystère dans la distribution des tokens
Avec un total de 1 milliard, il y a actuellement moins de 190 millions en circulation, soit environ 19%. À première vue, ça semble avoir une pression de déblocage, non ? Mais regarde de plus près : 40% pour l'écosystème sera débloqué progressivement sur 60 mois, et les 25% pour les contributeurs et investisseurs seront bloqués pendant 12 mois avant de commencer à se libérer, et ça va s'étaler sur 36 mois. Qu'est-ce que ça signifie ? De grosses positions sont retenues, il n'y aura pas de dumping à court terme.
Quatre niveaux de capture de valeur
OPG n'est pas un token de gouvernance sans substance. C'est un outil de paiement, pour ajuster un modèle AI, tu dois dépenser des OPG ; les nœuds doivent d'abord staker des OPG pour travailler, sinon ils risquent de perdre tout ; les développeurs qui téléchargent des modèles peuvent aussi gagner des OPG. Quatre niveaux de demande combinés, c'est bien plus solide que ces tokens vides qui ne servent qu'à voter.
Les risques doivent aussi être clarifiés
TEE dépend d'AWS, ce qui représente un risque de centralisation. L'équipe du projet le sait, mais pour le moment, il n'y a pas de meilleure option que Nitro. De plus, le système ZKML est trop coûteux pour les LLM, donc la plupart des scénarios dépendent toujours de TEE.
Pour finir, disons-le franchement $OPG
Le véritable test de cette niche sera : lorsque les inférences AI vérifiables deviendront une nécessité, la vitesse de consommation de l'OPG pourra-t-elle dépasser le déblocage des tokens. Actuellement, le marché est petit et volatil, pèse le pour et le contre. @OpenGradient
1
1
439
·
--
#opg $OPG Laisse-moi te dire un truc qui semble contre-intuitif : OpenGradient ne vise pas à résoudre "l'IA n'est pas assez puissante", mais plutôt "l'IA n'est pas fiable". Les conseils d'investissement ou les signaux de trading générés par les LLM, les utilisateurs ne peuvent pas vérifier indépendamment si le processus de calcul a été altéré. L'idée centrale du livre blanc est de rendre ce processus "auditable".
1. HACA : séparation de l'exécution et de la vérification
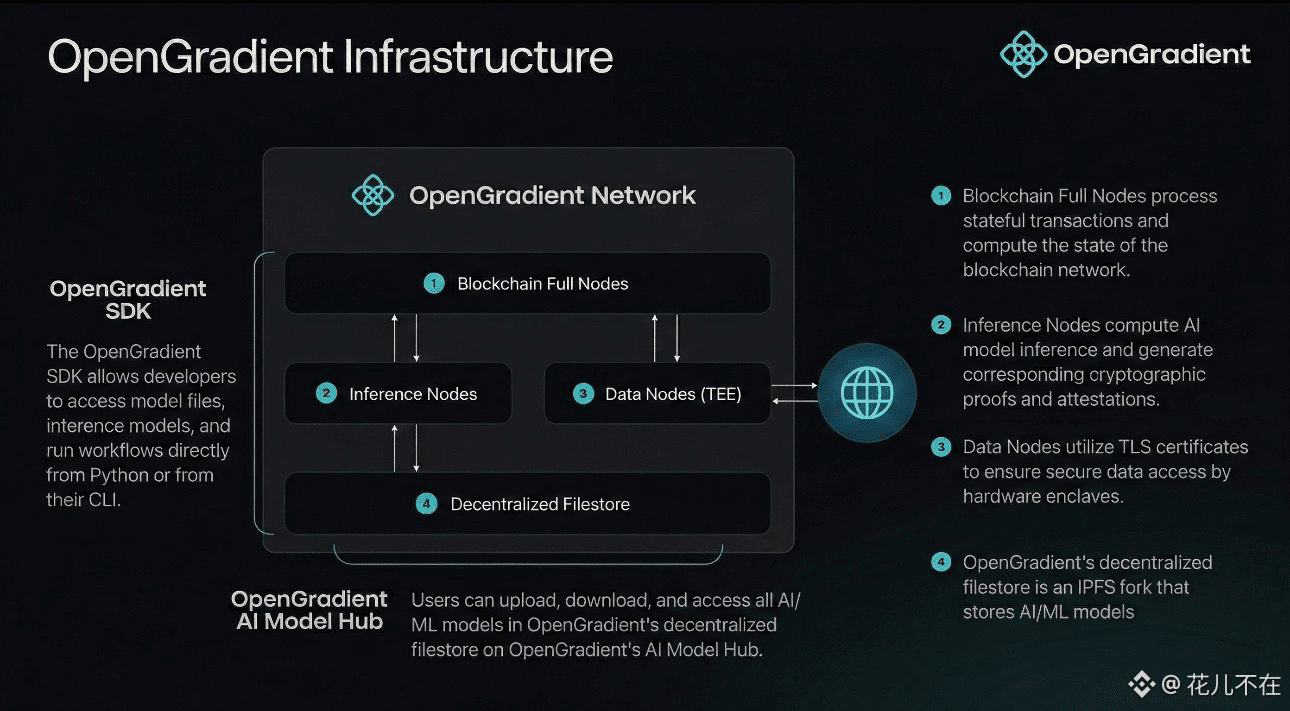
Les blockchains traditionnelles exigent que chaque nœud de validation exécute à nouveau chaque transaction, ce qui est irréaliste pour l'inférence IA. L'architecture HACA d'OpenGradient décompose le réseau en trois couches : nœuds d'inférence (GPU + TEE exécutant des modèles, retournant des résultats, la blockchain n'est pas sur le chemin critique), nœuds complets (validant TEE/ZKML, tout en maintenant le livre avec le consensus CometBFT), nœuds de données (accès sécurisé aux données externes dans le TEE). Les nœuds de validation ne font pas tourner de modèles, ils vérifient uniquement les preuves — c'est le cœur de l'optimisation des performances.
2. Cadre de vérification : menu de niveaux de confiance
Le livre blanc a conçu trois voies de validation : TEE (AWS Nitro Enclaves, documents certifiant que l'environnement n'a pas été altéré, couvrant les LLM et la plupart des cas ML), ZKML (preuve à connaissance nulle, déterminisme de niveau mathématique, mais coût élevé, utilisé uniquement pour des inférences ML à haut risque), Vanilla (sans preuve, scénarios à faible exigence). Le protocole de paiement x402 a été intégré à chaque instance TEE, éliminant les intermédiaires centralisés, supportant les règlements asynchrones, les demandes d'inférence prépayées ne sont pas bloquées sur la chaîne.
3. Token et état actuel
L'offre totale d'OPG est de 1 milliard de jetons, le TGE est prévu pour avril 2026 sur la chaîne Base, actuellement environ 19% en circulation. Les jetons sont utilisés pour payer les frais d'inférence, les pénalités de mise, et le vote de gouvernance. Les parts pour l'écosystème, les contributeurs, et les investisseurs sont toutes soumises à des verrouillages à long terme (12 mois de cliff + 36 mois de libération linéaire), ce qui contrôle la pression de vente à court terme. Le réseau est actuellement en phase de test, ayant traité plus de 2 millions d'inférences vérifiables, hébergé plus de 2000 modèles, et généré plus de 500 000 preuves.
Risques à surveiller : dépendance au TEE d'AWS Nitro, tension entre décentralisation et centralisation ; ZKML pas encore réaliste pour les LLM, l'équilibre "coût-sécurité" de la vérification est à la charge des développeurs ; les libérations d'offre continueront au cours des deux prochaines années, nécessitant une croissance des revenus du réseau pour s'aligner.
Quand "vérifiable" devient l'exigence par défaut des sorties IA, l'architecture d'OpenGradient prend vraiment sa valeur ajoutée.
#OPG $OPG @OpenGradient
113
·
--
#opg $OPG On va parler d'un truc sérieux. Beaucoup de gens regardent le prix du token OPG sans comprendre ce que l'architecture HACA résout vraiment.
Les blockchains traditionnelles ne peuvent pas gérer l'IA, et la raison est simple. La logique d'Ethereum consiste à ce que chaque nœud de validation exécute la même transaction pour parvenir à un consensus. Pas de souci pour les transferts, mais pour le raisonnement IA ? Faire tourner un grand modèle de 700 milliards de paramètres nécessite des GPU, du temps, et chaque sortie est différente. Faire tourner 100 nœuds de validation pour chaque transaction ? Les coûts explosent et le temps s'étire à l'infini. Certaines personnes considèrent l'IA comme un "oracle" en injectant des données, ce qui revient à transférer la confiance du fournisseur d'IA au fournisseur d'oracle, sans réel changement.
La pensée d'OpenGradient est simple : décomposer. Le cœur de HACA : séparation de l'exécution et de la vérification. Trois types de nœuds, chacun avec son rôle :
· Nœud d'inférence — GPU qui exécute le modèle et renvoie les résultats directement à l'utilisateur, avec une latence comparable à ChatGPT.
· Nœud complet — ne fait pas tourner le modèle, mais vérifie les preuves cryptographiques soumises par le nœud d'inférence (TEE ou ZKML). Si la vérification passe, c'est enregistré sur la chaîne, sans avoir besoin de connaître les mots clés, le modèle ou le résultat, juste des opérations cryptographiques.
· Nœud de données — se charge de récupérer les données externes, tout en garantissant qu'elles n'ont pas été manipulées dans le TEE.
Où est la magie de ce design ? L'inférence suit le "chemin rapide" — tu fais ta demande, le GPU calcule, et le résultat te revient en un éclair, sans impliquer la blockchain. La vérification suit le "chemin lent" — les preuves sont soumises de manière asynchrone, vérifiées par le nœud complet, et enregistrées sur la chaîne. La vitesse est au niveau Web2, la confiance est au niveau Web3. Plus il y a de nœuds d'inférence, plus le débit augmente, la pression sur la couche de vérification ne change pas — la validation des preuves se fait en millisecondes, peu importe si ton modèle a mis 5 secondes ou 50 secondes.
En termes simples : tu reçois tes résultats aussi vite qu'avec ChatGPT, mais chaque résultat peut être vérifié indépendamment et retracé de manière permanente — pas besoin de faire confiance à qui que ce soit.
Actuellement, le mainnet a exécuté plus de 2 millions d'inférences vérifiables, plus de 500 000 preuves, et plus de 2000 modèles. a16z et Coinbase Ventures sont déjà à bord. Ce mécanisme a décomposé l'"IA boîte noire" en "pipeline transparent", tout est en bonne voie, reste à voir si l'écosystème pourra fonctionner @OpenGradient
95
·
--
#bedrock $BR Dans le cercle actuel, on voit partout des annonces sur la liquidité complète de Bedrock, avec des airdrops et des rendements élevés qui stimulent continuellement le marché. De nombreux petits traders suivent le mouvement, empruntent et augmentent leurs interactions, essayant de tirer profit des récompenses. Après avoir testé le terrain en réel pendant un mois et demi, je vais sortir de l'emballage promotionnel et parler du projet du point de vue d'un investisseur ordinaire.
Le système de génération de rendement inter-chaînes basé sur uniBTC est le point fort du projet. Auparavant, pour que les actifs BTC traversent plusieurs écosystèmes d'investissement, il fallait passer par de multiples ponts, ce qui était non seulement chronophage, mais entraînait également des frais de chaîne supplémentaires. Avec une simple mise en jeu sur la plateforme, on peut générer des certificats de liquidité, permettant aux actifs de naviguer facilement entre divers protocoles de rendement, avec une efficacité de rotation des fonds qui surpasse de loin les produits de mise en jeu traditionnels sur le marché. La conception de l'architecture est très favorable aux fonds importants.
Cependant, pour simplifier les opérations, le projet a encapsulé en interne la gestion des nœuds de base, le contrôle des risques d'actifs et les règles de collecte de fonds. Les utilisateurs ne peuvent voir que les rendements sur l'interface, sans possibilité de consulter les détails de la garde des actifs sous-jacents, ce qui représente un risque considérable pour les anciens joueurs qui attachent de l'importance à la transparence sur la chaîne.
Actuellement, une multitude de petits traders avec des montants de quelques centaines de dollars suivent le cycle de mise en jeu pour accomplir des tâches. L'ensemble du modèle économique penche en faveur des grosses baleines. Les frais de Gas et les glissements de change engendrés par des opérations fréquentes avec de petits montants vont peu à peu ronger les rares récompenses écologiques. La plupart des participants finissent par ne pas réaliser de bénéfices, mais augmentent en fait le TVL du projet.
Je conseille de garder une attitude équilibrée et d'abandonner l'idée de s'enrichir rapidement grâce aux airdrops. Considérez le projet uniquement comme un outil de liquidité. Les certificats obtenus par la mise en jeu devraient être associés à des investissements stables dans des DeFi éprouvés, et les airdrops doivent être vus comme un bonus supplémentaire. Une fois que l'engouement du marché aura diminué, observez les fonds réellement conservés dans l'écosystème avant de planifier des investissements futurs.
#Bedrock #btcfire @Bedrock
65
·
--
#bedrock $BR Dans la communauté, de plus en plus de gens exhibent leurs points BR ; un ami a même mis en photo de profil un screenshot des 10 premiers du classement, disant à tout le monde : "Voilà le vrai savoir-faire de BTCFi". Honnêtement, j'ai failli éclater de rire — après six ans à naviguer dans l'univers DeFi, de MakerDAO jusqu'à la relance de la ré-ponte, j'ai vu ce genre de manœuvre, où le "seuil d'entrée" est déguisé en "incitation utilisateur", au moins dix fois.
Pour être franc, Bedrock ne doit pas son ascendant dans le domaine BTCFi à la simple possibilité de faire du cross-chain avec le BTC. Tu as remarqué ? Sa véritable barrière, c'est ce modèle de dépréciation non linéaire des points qui paraît équitable. L'équipe du projet est très astucieuse, au lieu de dire "n'entrez pas si vous n'avez pas les fonds", ils utilisent une formule de points pour discrètement établir une hiérarchie de capital : en mettant en jeu 1 BTC, un gros investisseur qui verrouille ses fonds pendant un an génère autant de points que les petits investisseurs qui entrent et sortent fréquemment pendant trois mois. Deux types de capitaux, deux systèmes de décote, séparés par un dôme de rendement que les petits ne pourront jamais traverser.
Les avantages de ce système pour le protocole sont trop évidents : la TVL a explosé de 500 millions à 3 milliards, et la liquidité est piégée dans des contrats imbriqués, même les baleines n'osent pas quitter facilement. Mais le coût est entièrement supporté par les petits investisseurs — j'ai vu de mes propres yeux des gens dans le groupe régler trois alarmes par jour, se lever à 2 heures du matin pour changer de pool et augmenter leurs points, dépensant des milliers de U en frais, mais leur classement de points ne bouge pas d'un iota. Pourquoi ? Parce que dans ce modèle où la durée de dépôt et le volume de capital déterminent tout, le capital tournant des petits ne rivalisera jamais avec les actifs dormants des gros.
Plus ironique encore, la plateforme crée délibérément l'illusion que "travailler dur vous enrichira". Tu passes tes journées à surveiller les fluctuations de l'APY, à déplacer tes fonds entre différents pools pour ce 0,01% de points supplémentaires qui t'émeut, ce cycle de Sisyphe est-il vraiment une participation équitable ? Nous ne faisons que migrer des tréfonds de la chaîne alimentaire financière traditionnelle vers un niveau subalterne du système de points sur la chaîne. Chaque point de $BR , récolté par les institutions à prix premium, repose sur d'innombrables petits capitaux, dilués par le temps et l'échelle, représentant un coût irrécupérable.
#bedrock $BR @Bedrock
104
Connectez-vous pour découvrir plus de contenu
Rejoignez la communauté mondiale des adeptes de cryptomonnaies sur Binance Square
⚡️ Suviez les dernières informations importantes sur les cryptomonnaies.
💬 Jugé digne de confiance par la plus grande plateforme d’échange de cryptomonnaies au monde.
👍 Découvrez les connaissances que partagent les créateurs vérifiés.
Adresse e-mail/Nº de téléphone
Sujets d’actualité
BinanceLaunchesBinanceIntelligence
36,762 vues
450 mentions
🚨 BINANCE VIENT D’INTÉGRER L’IA DIRECTEMENT À SA PLATEFORME D’ÉCHANGE — ET CELA POURRAIT CHANGER LA FAÇON DONT LES PARTICULIERS TRADENT.
Binance a officiellement lancé Binance Intelligence, une nouvelle couche d’IA intégrée à l’écosystème Binance. Elle regroupe trois produits :
Binance AI pour les utilisateurs du quotidien,
Binance AI Pro pour les processus de trading automatisés,
et Agent OS pour les développeurs qui créent des agents financiers.
La partie qui devrait intéresser les traders ?
Binance AI peut fournir des synthèses du marché, des alertes intelligentes, des récapitulatifs de profits et pertes (PnL) ainsi que des informations personnalisées, tandis que AI Pro est conçu pour transformer une idée de trading formulée en langage courant en une stratégie visuelle.
Cela signifie que la prochaine phase de la concurrence entre plateformes d’échange ne se jouera peut-être pas sur :
les frais les plus bas contre la liquidité la plus importante.
Mais plutôt sur :
qui offre aux traders la meilleure couche d’exécution basée sur l’IA.
Si Binance Intelligence entraîne réellement une activité accrue des utilisateurs, davantage de stratégies automatisées et une fréquence de trading plus élevée, surveillez $BNB en premier.
Adoption de l’IA ↑
→ engagement sur Binance ↑
→ activité de trading ↑
→ le récit autour de l’écosystème se renforce.
Le catalyseur que je surveillerais maintenant :
déploiement mondial + lancement d’AI Pro + adoption mesurable par les utilisateurs.
Parce qu’une fois que l’IA ne se contente plus de vous dire ce qui se passe sur le marché…
…et commence à vous aider à élaborer vos propres transactions ?
C’est là que cela prend une tout autre ampleur qu’un simple chatbot. 👀
#binancelaunchesbinanceintelligence #EvernorthXRPTreasuryCompletesSPACMerger #ADAGains10%Above$0.27 #ETHUp70%InQ3ButLiquidityFalls #EthStakingExitQueueHits2026High
KimHotbae
·20 mentions J’aime
·24.8k vues
EvernorthXRPTreasuryCompletesSPACMerger
32,517 vues
311 mentions
ADAGains10%Above$0.27
31,065 vues
206 mentions