Je viens de parcourir le cas technique NodeGhost d’@Acurast et j’y ai trouvé un résultat de test assez intéressant.
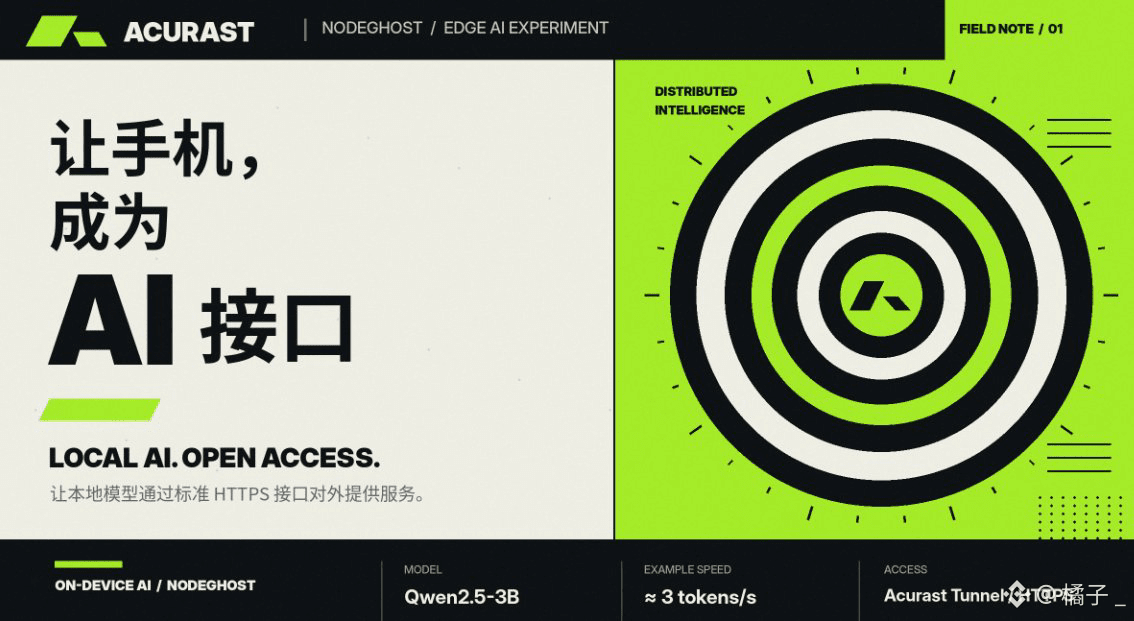
Un téléphone fait tourner le modèle Qwen2.5-3B quantifié, avec une vitesse de génération d’environ 3 tokens par seconde.
Pour répondre à une question d’environ 120 tokens, il faut compter près de 45 secondes.
Comparée à l’expérience offerte aujourd’hui par les grands modèles de langage, cette vitesse est effectivement un peu lente.
Mais ce qui a attiré mon attention dans ce cas, c’est un autre aspect de sa conception.
Grâce à Acurast Tunnel, un modèle qui se trouvait jusque-là sur un téléphone, sans adresse IP publique, peut fournir une interface HTTPS accessible de l’extérieur.
En utilisant ensuite l’API compatible avec OpenAI de NodeGhost, les développeurs peuvent envoyer des requêtes au téléphone sans pratiquement modifier leur façon habituelle de procéder.
Ainsi, le téléphone n’est plus seulement un Processor passif qui attend qu’on lui attribue des tâches sur le réseau : il peut aussi fournir des services standardisés d’inférence IA.
Bien sûr, ce cas reste pour l’instant une implémentation de référence sur le réseau Canary, avec des limites évidentes en matière de vitesse et de capacité à gérer des raisonnements complexes.
Mais je pense qu’il répond déjà à une question très concrète :
Si des développeurs souhaitent déployer leurs modèles sur des téléphones distribués, les applications existantes peuvent-elles les utiliser facilement ?
Cette approche technique dispose au moins déjà d’un exemple fonctionnel.
Quant à sa viabilité commerciale, il faudra encore évaluer la latence, la concurrence, les coûts et la stabilité à long terme.
Le $ACU d’Acurast sert à relier l’utilisation du réseau aux incitations liées à la puissance de calcul. Mais pour savoir si le projet pourra attirer une demande payante, il faudra voir si ces applications sont réellement compétitives.
Un téléphone fait tourner le modèle Qwen2.5-3B quantifié, avec une vitesse de génération d’environ 3 tokens par seconde.
Pour répondre à une question d’environ 120 tokens, il faut compter près de 45 secondes.
Comparée à l’expérience offerte aujourd’hui par les grands modèles de langage, cette vitesse est effectivement un peu lente.
Mais ce qui a attiré mon attention dans ce cas, c’est un autre aspect de sa conception.
Grâce à Acurast Tunnel, un modèle qui se trouvait jusque-là sur un téléphone, sans adresse IP publique, peut fournir une interface HTTPS accessible de l’extérieur.
En utilisant ensuite l’API compatible avec OpenAI de NodeGhost, les développeurs peuvent envoyer des requêtes au téléphone sans pratiquement modifier leur façon habituelle de procéder.
Ainsi, le téléphone n’est plus seulement un Processor passif qui attend qu’on lui attribue des tâches sur le réseau : il peut aussi fournir des services standardisés d’inférence IA.
Bien sûr, ce cas reste pour l’instant une implémentation de référence sur le réseau Canary, avec des limites évidentes en matière de vitesse et de capacité à gérer des raisonnements complexes.
Mais je pense qu’il répond déjà à une question très concrète :
Si des développeurs souhaitent déployer leurs modèles sur des téléphones distribués, les applications existantes peuvent-elles les utiliser facilement ?
Cette approche technique dispose au moins déjà d’un exemple fonctionnel.
Quant à sa viabilité commerciale, il faudra encore évaluer la latence, la concurrence, les coûts et la stabilité à long terme.
Le $ACU d’Acurast sert à relier l’utilisation du réseau aux incitations liées à la puissance de calcul. Mais pour savoir si le projet pourra attirer une demande payante, il faudra voir si ces applications sont réellement compétitives.