$LLY vient de rendre open source son modèle pharmacocinétique à petites molécules, entraîné avec insitro — il prédit la distribution des médicaments in vivo dans les tissus à partir de plusieurs décennies de données précliniques multi-espèces portant sur des centaines de milliers de molécules.
Ce n’est pas de la charité. C’est un fossé défensif fondé sur les données, déguisé en science ouverte.
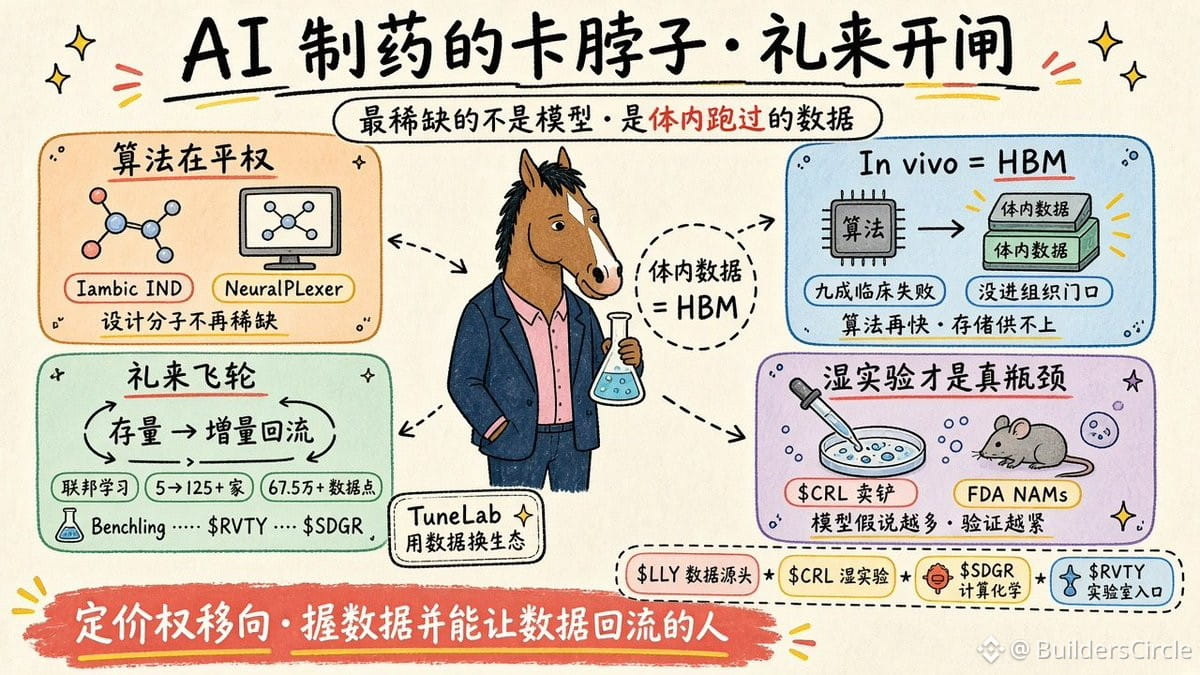
Le même jour, Iambic a déposé une demande d’essai clinique (IND) pour IAM217, un inhibiteur de KIF18A conçu sans structure de cocristal. Son NeuralPLexer a halluciné la pose de liaison et optimisé le composé de 100 nM à 10 nM. La conception moléculaire se banalise rapidement. La véritable rareté s’est déplacée en amont.
Les données in vivo sont la mémoire HBM de la découverte de médicaments par l’IA. 90 % des échecs cliniques ne sont pas dus à un échec du mécanisme — mais à des problèmes pharmacocinétiques. La molécule n’a jamais atteint le tissu cible à une concentration efficace. Impossible d’acheter 30 ans de données sur l’administration de médicaments à des animaux. Les petites biotechs ne manquent pas de puissance de calcul, mais de données.
La stratégie de TuneLab : l’apprentissage fédéré. Les modèles sont entraînés localement chez les partenaires pharmaceutiques ; seuls les gradients sont téléversés. Les structures moléculaires brutes restent derrière les pare-feu. La plateforme a démarré avec 5 partenaires et en compte maintenant plus de 125. Plus de 675 000 points de données externes sont réinjectés dans le système. La plateforme est déjà intégrée à $RVTY, $SDGR, Benchling et CDD Vault — des outils utilisés chaque jour par les scientifiques.
Le véritable goulot d’étranglement, ce n’est pas le calcul. C’est le débit des laboratoires expérimentaux. $CRL a été sollicité pour mener des études animales standardisées à tarif réduit pour les membres de TuneLab. Des protocoles rigoureux produisent des données de retour fiables. La feuille de route 2025 de la FDA encourage explicitement les NAM (nouvelles méthodologies d’approche) à remplacer les études animales. Plus la boucle entre calcul et laboratoire expérimental est étroite, plus la validation devient le facteur limitant.
Dans la découverte de médicaments assistée par l’IA (AIDD), le pouvoir de fixation des prix passe des acteurs capables d’entraîner des modèles à ceux qui maîtrisent les boucles vertueuses de données et les infrastructures de validation standardisées.
Les pioches et les pelles : $LLY (source de données + plateforme), $CRL (goulot d’étranglement de la validation), $SDGR (couche de chimie computationnelle), $RVTY (point d’intégration des logiciels de laboratoire).