GitHub est soudainement devenu très populaire récemment avec un agent IA pour navigateur assez intéressant.
Son nom est Jev Ultrafast.
Le projet n’est apparu que le 16 septembre et, après environ 15 heures en ligne, il n’avait pas encore 1 000 Stars.
Quelques jours plus tard :
9/16 : moins de 1 000 Stars
↓
9/21 : environ 6 800
↓
Actuellement : plus de 10 000 Stars
En seulement 6 jours, la vitesse de croissance est tout simplement impressionnante.
Mais ce qui mérite vraiment d’être noté n’est pas le nombre de Stars sur GitHub, c’est plutôt le choix qu’il a fait pour son Browser Agent, un choix vraiment différent.
À l’heure actuelle, la plupart des méthodes d’IA Browser Agent pour manipuler des pages web sont à peu près les suivantes :
Capturer une image
→ L’IA analyse l’écran
→ Trouver les boutons
→ Cliquer
→ Refaire une capture
→ Déterminer l’étape suivante
Cette approche est intuitive, mais elle implique aussi beaucoup de traitement visuel, de raisonnement du modèle et de coûts liés aux actions.
L’approche de Jev est différente.
Il n’a pas besoin de faire « regarder l’écran » en continu à l’IA. Il transforme directement le DOM de la page web et les éléments actionnables en un espace d’actions (Action Space) structuré.
Ce que le modèle voit ressemble davantage à :
Bouton A
Champ de saisie B
Option C
Puis il n’a plus qu’à décider quelle action exécuter ensuite.
Le LLM n’est appelé que lorsqu’il est réellement nécessaire de générer du texte.
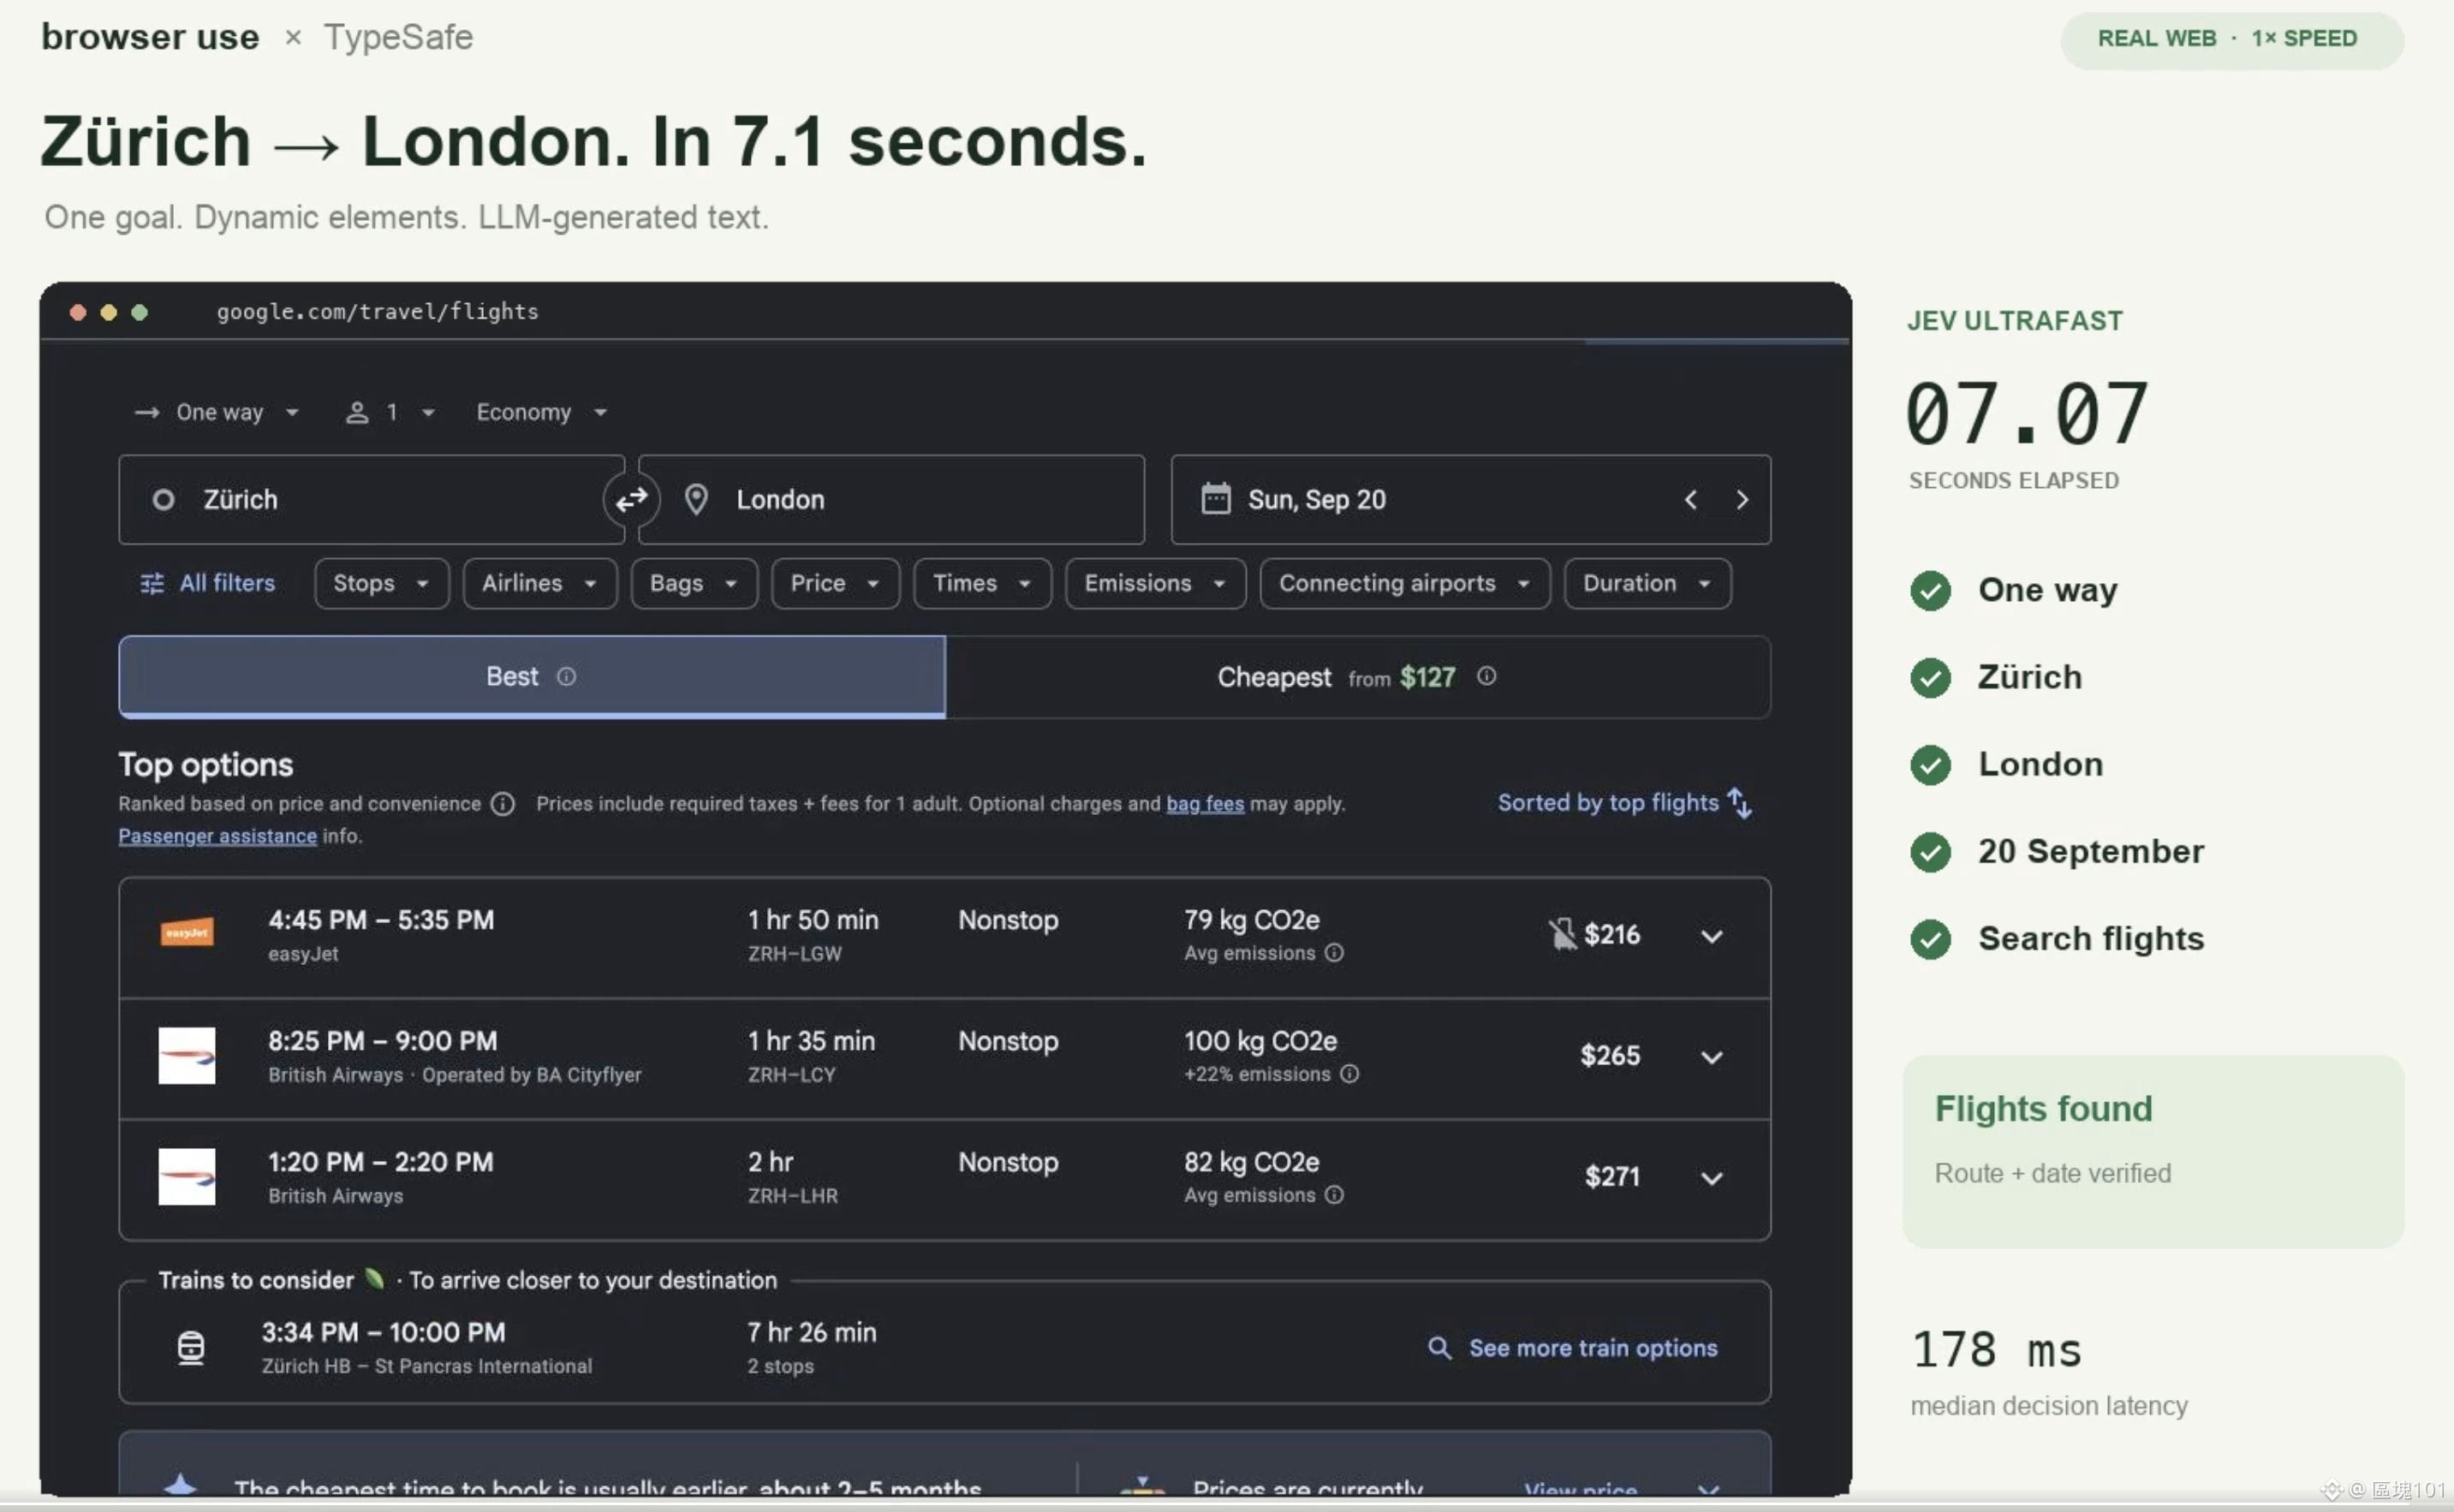
Dans une démo Google Flights présentée officiellement, pour passer de Zurich à Londres (recherche de vols), l’exécution prend environ 7,1 secondes.
Les tests publiés officiellement indiquent aussi que, pour certaines tâches, les appels au protocole du navigateur (browser protocol calls) peuvent être réduits de manière significative.
Cette idée me paraît vraiment intéressante.
Par le passé, quand les gens parlaient d’AI Agents, l’attention se portait presque uniquement sur :
Le modèle est-il plus intelligent ?
Mais après un déploiement à grande échelle des Agents, un autre problème pourrait être plus important :
Pour accomplir une tâche, de combien de fois le modèle faut-il faire des inférences, combien de Tokens, combien de secondes… et combien d’argent ?
Si un Browser Agent peut « voir » beaucoup moins de fois et « réfléchir » beaucoup moins de fois, tout en accomplissant le même travail,
la prochaine compétition d’Agents ne sera peut-être pas seulement une question d’Intelligence.
Mais plutôt :
d’Efficacité.
Son nom est Jev Ultrafast.
Le projet n’est apparu que le 16 septembre et, après environ 15 heures en ligne, il n’avait pas encore 1 000 Stars.
Quelques jours plus tard :
9/16 : moins de 1 000 Stars
↓
9/21 : environ 6 800
↓
Actuellement : plus de 10 000 Stars
En seulement 6 jours, la vitesse de croissance est tout simplement impressionnante.
Mais ce qui mérite vraiment d’être noté n’est pas le nombre de Stars sur GitHub, c’est plutôt le choix qu’il a fait pour son Browser Agent, un choix vraiment différent.
À l’heure actuelle, la plupart des méthodes d’IA Browser Agent pour manipuler des pages web sont à peu près les suivantes :
Capturer une image
→ L’IA analyse l’écran
→ Trouver les boutons
→ Cliquer
→ Refaire une capture
→ Déterminer l’étape suivante
Cette approche est intuitive, mais elle implique aussi beaucoup de traitement visuel, de raisonnement du modèle et de coûts liés aux actions.
L’approche de Jev est différente.
Il n’a pas besoin de faire « regarder l’écran » en continu à l’IA. Il transforme directement le DOM de la page web et les éléments actionnables en un espace d’actions (Action Space) structuré.
Ce que le modèle voit ressemble davantage à :
Bouton A
Champ de saisie B
Option C
Puis il n’a plus qu’à décider quelle action exécuter ensuite.
Le LLM n’est appelé que lorsqu’il est réellement nécessaire de générer du texte.
Dans une démo Google Flights présentée officiellement, pour passer de Zurich à Londres (recherche de vols), l’exécution prend environ 7,1 secondes.
Les tests publiés officiellement indiquent aussi que, pour certaines tâches, les appels au protocole du navigateur (browser protocol calls) peuvent être réduits de manière significative.
Cette idée me paraît vraiment intéressante.
Par le passé, quand les gens parlaient d’AI Agents, l’attention se portait presque uniquement sur :
Le modèle est-il plus intelligent ?
Mais après un déploiement à grande échelle des Agents, un autre problème pourrait être plus important :
Pour accomplir une tâche, de combien de fois le modèle faut-il faire des inférences, combien de Tokens, combien de secondes… et combien d’argent ?
Si un Browser Agent peut « voir » beaucoup moins de fois et « réfléchir » beaucoup moins de fois, tout en accomplissant le même travail,
la prochaine compétition d’Agents ne sera peut-être pas seulement une question d’Intelligence.
Mais plutôt :
d’Efficacité.