#multiversxplanshardforkrecovery
⚠️ Plans de MultiversX pour rétablir la stabilité ⚠️
Le réseau fonctionnait normalement. Puis, en modifiant l’exploitation d’un seul rythme, les validateurs ont été forcés de s’arrêter et les développeurs ont dû se concentrer sur une seule question : comment restaurer la chaîne sans compromettre son historique ?
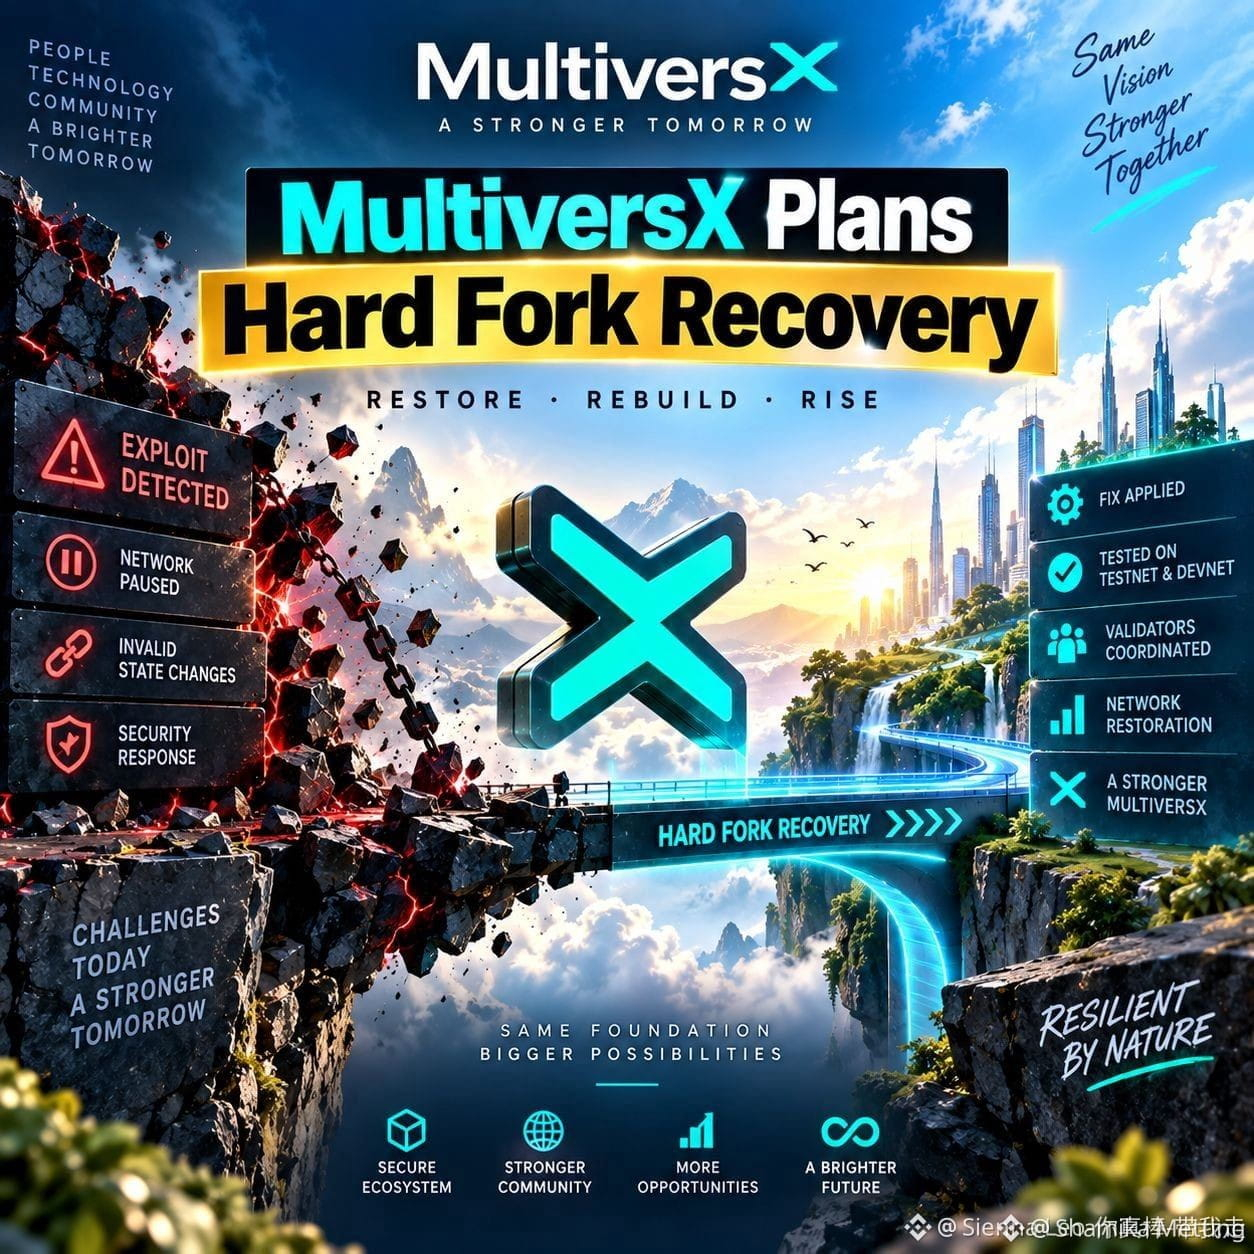
MultiversX affirme qu’un attaquant a exploité un problème d’atomicité au niveau de la machine virtuelle (VM) le 19 septembre, entraînant des changements d’état invalides et un arrêt de la progression du réseau. L’équipe confirme que la faille était circonscrite et qu’un correctif a été préparé le jour même.
Le plan de reprise consiste désormais à effectuer un hard fork coordonné à partir d’un point de contrôle « sain » connu. MultiversX indique que la procédure a été examinée au préalable sur Testnet et Devnet, avec participation des validateurs avant le redémarrage principal.
Mon avis : la partie la plus intéressante n’est pas seulement qu’un hard fork est à venir. Mais plutôt la manière dont le réseau réagit sous pression. La reprise doit équilibrer la vitesse et la sûreté de l’état, la coordination des validateurs et la protection des utilisateurs.
Et même avant le signal « tout est OK », MultiversX a conseillé aux utilisateurs de ne pas envoyer de transactions, ni de les renvoyer, et de ne pas utiliser des itinéraires de dépôt et de retrait EGLD ou ESDT via des plateformes d’échange (exchanges) ou des ponts (bridges).
❓ Pensez-vous qu’une restauration de hard fork transparente et coordonnée puisse renforcer la confiance dans MultiversX ?
Merci de votre suivi
#MultiversX #EGLD #GrowWithSAC $EGLD $SAGA $FTT
#MultiversXPlansHardForkRecovery
⚠️ Plans de MultiversX pour rétablir la stabilité ⚠️
Le réseau fonctionnait normalement. Puis, en modifiant l’exploitation d’un seul rythme, les validateurs ont été forcés de s’arrêter et les développeurs ont dû se concentrer sur une seule question : comment restaurer la chaîne sans compromettre son historique ?
MultiversX affirme qu’un attaquant a exploité un problème d’atomicité au niveau de la machine virtuelle (VM) le 19 septembre, entraînant des changements d’état invalides et un arrêt de la progression du réseau. L’équipe confirme que la faille était circonscrite et qu’un correctif a été préparé le jour même.
Le plan de reprise consiste désormais à effectuer un hard fork coordonné à partir d’un point de contrôle « sain » connu. MultiversX indique que la procédure a été examinée au préalable sur Testnet et Devnet, avec participation des validateurs avant le redémarrage principal.
Mon avis : la partie la plus intéressante n’est pas seulement qu’un hard fork est à venir. Mais plutôt la manière dont le réseau réagit sous pression. La reprise doit équilibrer la vitesse et la sûreté de l’état, la coordination des validateurs et la protection des utilisateurs.
Et même avant le signal « tout est OK », MultiversX a conseillé aux utilisateurs de ne pas envoyer de transactions, ni de les renvoyer, et de ne pas utiliser des itinéraires de dépôt et de retrait EGLD ou ESDT via des plateformes d’échange (exchanges) ou des ponts (bridges).
❓ Pensez-vous qu’une restauration de hard fork transparente et coordonnée puisse renforcer la confiance dans MultiversX ?
Merci de votre suivi
#MultiversX #EGLD #GrowWithSAC $EGLD $SAGA $FTT
#MultiversXPlansHardForkRecovery