Qwen vient de lancer son premier modèle omni-modal avec des capacités agentiques natives — c’est vraiment incroyable
Ce qu’il fait :
• Compréhension audio-vidéo native + raisonnement + utilisation d’outils dans un seul modèle
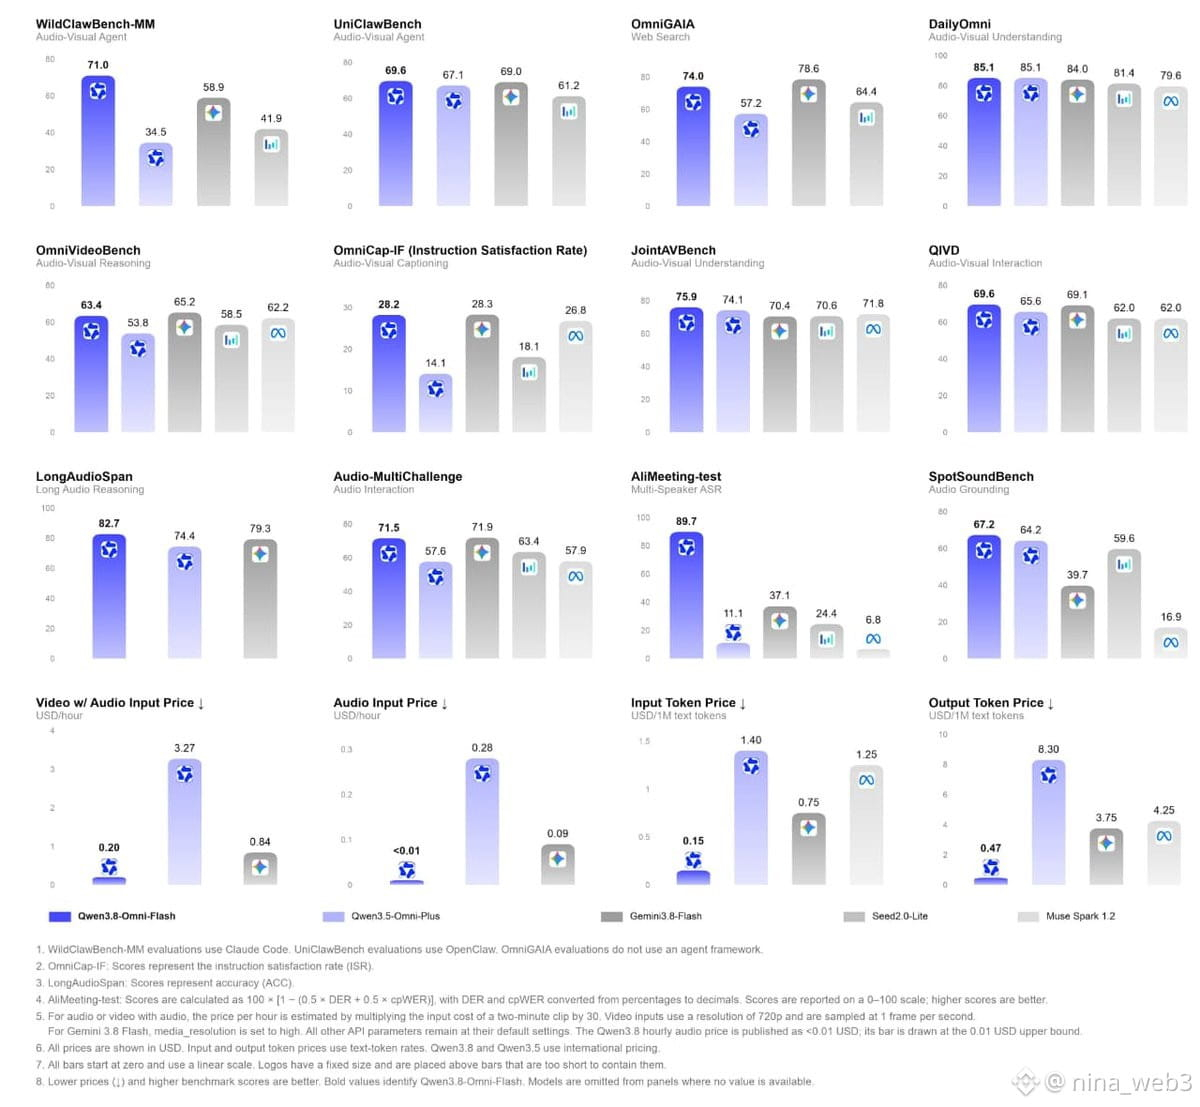
• Se rapproche des performances de Gemini 3.8 Flash sur des benchmarks audio-vidéo
• Fenêtre de contexte de 1M tokens — analyse des vidéos longues et extrait les moments clés avec 51,8% de tokens en moins
Regarde-le, écoute-le, planifie-le, exécute-le. Tout dans un seul modèle. Pas besoin de bricolage, pas de galère de pipeline.
C’est le genre de changement d’infrastructure qui distingue les vrais concepteurs des “prompt jockeys”. Si tu enchaînes encore 5 API différentes pour traiter la vidéo, tu es déjà en retard.
Ce qu’il fait :
• Compréhension audio-vidéo native + raisonnement + utilisation d’outils dans un seul modèle
• Se rapproche des performances de Gemini 3.8 Flash sur des benchmarks audio-vidéo
• Fenêtre de contexte de 1M tokens — analyse des vidéos longues et extrait les moments clés avec 51,8% de tokens en moins
Regarde-le, écoute-le, planifie-le, exécute-le. Tout dans un seul modèle. Pas besoin de bricolage, pas de galère de pipeline.
C’est le genre de changement d’infrastructure qui distingue les vrais concepteurs des “prompt jockeys”. Si tu enchaînes encore 5 API différentes pour traiter la vidéo, tu es déjà en retard.