


Une IA qui paraît moins capable, pourquoi est-elle au contraire devenue si populaire ?
Auteur de l’article : Zhu Xueying (朱雪莹)
Source : Wall Street Insight (华尔街见闻)
Ces deux derniers jours, un modèle d’IA un peu contre-intuitif a soudainement envahi les écrans.
Elle s’appelle Jev.
Elle ne discute pas, n’écrit pas du code, et n’a même pas comme ChatGPT à générer un long pavé de réponse. Elle ne fait qu’une chose : porter un jugement.
Pourtant, c’est précisément un modèle qui semble « amputé d’une grande partie de ses capacités » qui a soudain explosé dans le cercle des développeurs.
Certaines personnes l’ont utilisé 40 secondes pour analyser 724 publicités en temps réel, et ont fait au total 8 724 jugements ; d’autres l’ont branché à Claude Code pour nettoyer le contexte inutile ; et il y en a aussi qui lui font jouer le rôle de « arbitre » pour un Agent, afin de vérifier si la tâche est réellement accomplie. LangChain a déjà commencé à tester les performances de Jev comme évaluateur d’Agent.
Pire encore, c’est la vitesse et le prix.
D’après les tests publiés par TypeSafe, Jev a atteint jusqu’à environ 193,6× d’accélération, et jusqu’à 444,6× de réduction des coûts. Pour chaque million de tokens, seulement 0,042 $ ; les tokens en sortie sont même gratuits.
Une IA qui paraît moins capable, pourquoi est-elle au contraire devenue si populaire ?
Parce qu’à l’ère des Agents, ce dont l’IA a vraiment besoin n’est peut-être pas seulement « mûrement réfléchir », mais aussi des décisions massives, rapides et bon marché : que faire ensuite, quel outil appeler, la tâche est-elle vraiment terminée. Et surtout, à l’avenir, ces décisions doivent être faites par l’IA elle-même en arrière-plan, sans qu’un humain doive rester assis devant l’écran. C’est exactement ce que Jev vise : ces minuscules décisions susceptibles de survenir des millions de fois par jour.
Le plus intéressant, c’est que le fondateur du modèle Jev, Diogo Almeida, a justement participé au RLHF — et qu’il commence maintenant à le remettre en question. Cette méthode d’entraînement, qui rend ChatGPT si pratique, pourrait ne pas convenir à une IA qui s’oriente vraiment vers l’automatisation.
Il y a un peu plus d’un mois, Almeida a donné un discours. En regardant avec du recul, ce discours ressemble presque à un « manuel d’explication » des idées derrière Jev.
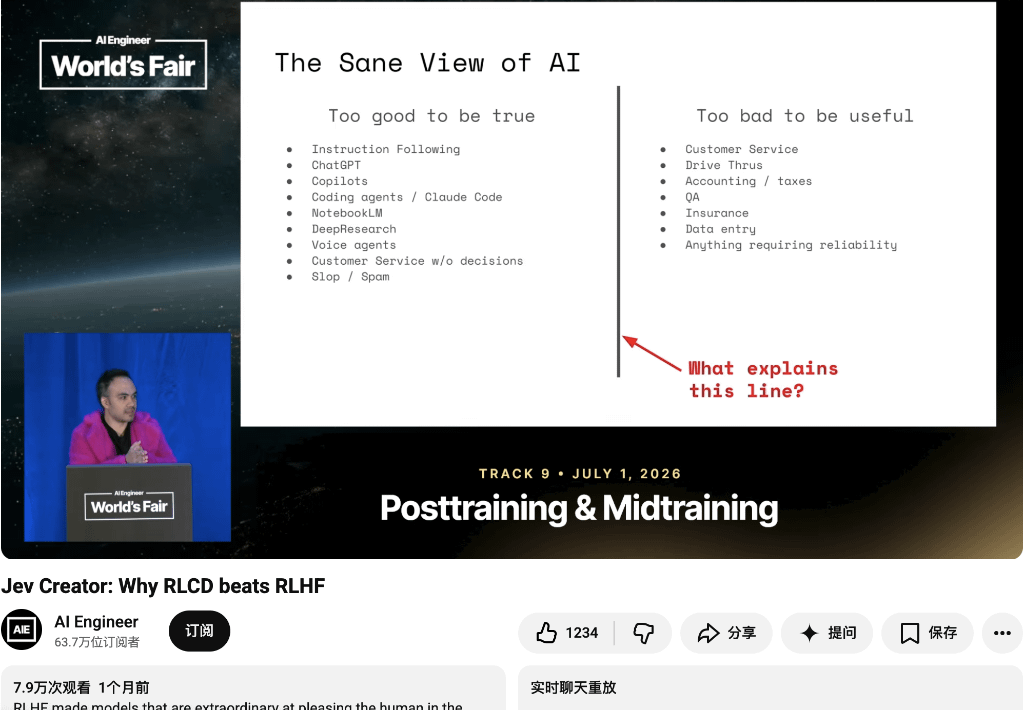
Si l’IA fait déjà des mathématiques avancées, pourquoi n’arrive-t-elle pas à faire un bon service client ?
Le parcours de Diogo Almeida est très particulier.
Il a déjà travaillé chez OpenAI : il était l’un des contributeurs aux travaux liés à GPT-4, ChatGPT et InstructGPT/RLHF. Autrement dit, il a participé de ses propres mains à construire l’une des phases de pré-entraînement (post-entrainement) les plus importantes des grands modèles d’aujourd’hui.
Mais dans ce discours, il a commencé par se taquiner lui-même : il faisait partie des rares personnes à OpenAI à avoir publiquement « critiqué » ChatGPT.
Le thème de son discours est encore plus direct : « What's Next After RLHF ? »
Diogo a d’abord posé une question qui semble contradictoire.
Aujourd’hui, les grands modèles peuvent déjà s’attaquer à des problèmes de mathématiques très difficiles. Le code, le raisonnement et toutes sortes de benchmarks progressent en continu.
Mais dans les activités professionnelles que de nombreuses entreprises veulent vraiment automatiser, l’humain n’est jamais vraiment déplaçable.
Par exemple le service client.
Faire en sorte que l’IA aille chercher des informations, résume des documents, rédige des réponses : aucun problème.
Mais si on laisse l’IA décider elle-même : cet argent doit-il être remboursé ou non ? Cet utilisateur doit-il être indemnisé ?
Les entreprises deviennent soudain prudentes.
Ces choses-là paraissent pourtant bien plus simples que les mathématiques avancées. Alors pourquoi n’ose-t-on pas les confier à l’IA ?
La réponse de Diogo est très simple : « Today's AI is incredible at assistance, not automation. »
Aujourd’hui, l’IA sait bien t’aider à faire le travail, mais elle n’arrive pas encore à le terminer toute seule.
Ces deux choses, en apparence, ne diffèrent que d’un détail. En réalité, elles sont totalement différentes.
Même si Claude Code est très fort, tu es quand même généralement assis devant l’ordinateur. Il écrit du code : tu regardes. Il modifie des fichiers : tu vérifies. Il se trompe : tu lui demandes de corriger.
Donc, de l’avis de Diogo, Claude Code fait encore partie de l’« ère de l’assistance » lancée par ChatGPT.
Qu’est-ce que l’automatisation, au juste ?
Les humains ne sont tout simplement pas là.
Dans l’arrière-plan, l’IA juge et exécute elle-même. En une journée, elle peut tourner des dizaines ou même des centaines de milliers de fois, voire plus — et tu ne verras même jamais ce qu’elle a fait.
D’où vient alors ce paradoxe : pourquoi aujourd’hui l’IA est aussi intelligente, mais dépend quand même à ce point de l’humain ?
Diogo pointe du doigt une chose qu’il connaît très bien : le RLHF.
Quand on entraîne l’IA, on y met l’humain dans la boucle : il y a quelque chose d’assez ironique là-dedans.
Parce que, précisément, le RLHF fait partie des voies techniques que Diogo avait contribué à faire avancer à l’époque.
La logique de base du RLHF n’est en fait pas compliquée : on collecte les préférences humaines, puis on entraîne le modèle pour qu’il s’y conforme de plus en plus.
C’est pourquoi Diogo donne, dans son discours, une explication très directe : pourquoi aujourd’hui les grands modèles ont toujours besoin d’un humain dans la boucle ?
Parce que lorsqu’on l’a entraîné, au sens littéral, on a mis l’humain dans cette boucle.
Dès le départ, le modèle apprend : quel type de réponse les humains préfèrent ?
Cela explique aussi un trait des grands modèles qu’on connaît déjà très bien : même quand ils ne savent pas, ils arrivent souvent à parler comme s’ils savaient parfaitement faire.
Diogo a donné sur place un exemple très parlant et plutôt « piquant ».
Quelqu’un a envoyé à ChatGPT un enregistrement de pets, lui disant que c’était sa propre création musicale, puis lui demandant de l’évaluer « sincèrement et franchement ».
Résultat : ChatGPT s’est mis à faire l’éloge de tout cela avec sérieux, disant que c’était une musique d’ambiance à la fois inquiétante et étrange.
Diogo résume même tout en une phrase : « Overpromising is a feature. »
La surpromesse n’est pas un bug, c’est une fonctionnalité.
Pour les produits de chat, cela n’est peut-être pas fatal : l’utilisateur est encore devant son écran, s’il se trompe on peut corriger.
Mais les systèmes d’automatisation réellement efficaces sont tout à fait différents.
La machine ne se soucie pas si tes réponses sonnent bien. Elle a juste besoin de savoir deux choses : quoi faire exactement, et à quel point tu es sûr.
C’est ce qui explique aussi pourquoi, un peu plus d’un mois après sa publication, Jev semble si anormalement décalé.
Du coup, Jev ne fait tout simplement plus « parler » l’IA.
Même si, au final, les modèles ordinaires n’ont besoin de répondre que « A ou B », ils passent souvent par un processus de génération de tokens.
Jev coupe directement cette partie.
Pour l’instant, elle fait principalement trois choses :
Noul, répondre Yes ou No ;
Choice, choisir parmi plusieurs options ;
Score, noter selon les critères standard.
Puis il renvoie directement le jugement et la probabilité.
Il ne te rédige pas de petits essais, et ne discute pas avec toi.
La latence de bout en bout annoncée officiellement serait aussi faible que 70 à 500 millisecondes : 20 à 200 fois plus rapide que des modèles de pointe. Et le prix serait 40 à 400 fois plus bas.
Mais le plus crucial, en réalité, ce n’est pas « la rapidité » : c’est la probabilité derrière.
Pour cela, TypeSafe propose une nouvelle méthode d’entraînement : RLCD, Reinforcement Learning for Calibrated Decisions, soit apprentissage par renforcement pour la calibration des décisions.
Le problème qu’il veut résoudre est très concret : si une IA te dit qu’une chose a 80 % de chances d’arriver, est-ce que ce 80 % vaut vraiment la peine d’être cru ?
Dans l’idéal, une série de situations pour lesquelles le modèle estime avoir 80 % de chances : à la fin, environ 80 % d’entre elles devraient réellement se produire.
C’est extrêmement important dans les systèmes d’automatisation.
99 % de chances : tu peux exécuter directement.
Avec 51 % de chances de réussir, on peut le confier à un modèle plus puissant et plus coûteux, voire à un humain.
Le vrai problème, ce n’est pas que l’IA ne sache pas. C’est que l’IA ne sait pas qu’elle ne sait pas.
Ainsi, ce que Jev veut vraiment changer, c’est l’objet de sortie de l’IA.
Dans le passé, les réponses générées par ChatGPT étaient surtout destinées à être lues par les humains. Les jugements et probabilités proposés par Jev sont, eux, prêts à être directement transmis au logiciel.
À l’ère des Agents, il ne faudra peut-être pas un cerveau plus grand
Et cela explique aussi pourquoi Jev a précisément explosé maintenant.
Parce qu’une fois que l’Agent tourne vraiment, il produit une quantité énorme de petits jugements :
Quel outil appeler ensuite ? Sur cette page, quel bouton cliquer ? Ce message est-il encore utile ? La tâche est-elle vraiment terminée ? Faut-il re-vérifier le résultat ?
Ces problèmes, pris individuellement, ne semblent pas difficiles. Mais un Agent, dans une seule journée, peut avoir besoin de juger des centaines de milliers, voire des millions de fois.
Si à chaque fois on appelle le modèle le plus puissant, qu’on lui laisse quelques secondes pour « mûrement réfléchir », puis qu’on lui fasse cracher une longue rafale de tokens, les coûts et la latence montent très vite.
C’est justement ce niveau que Jev veut capter.
Confier à Jev un grand volume de petites décisions fréquentes ; puis réserver aux grands modèles les tâches qui exigent un raisonnement complexe.
C’est aussi pour ça que TypeSafe appelle Jev un System One Model.
Ce concept vient du « système 1 » et du « système 2 » de Daniel Kahneman : l’un gère des jugements rapides et intuitifs, l’autre des réflexions plus lentes et complexes.
Même le nom de Jev vient du « paradoxe de Jevins (paradox de Jev) » :
Quand une ressource devient de plus en plus bon marché, les gens n’en utilisent pas forcément moins : au contraire, ils pourraient en utiliser davantage.
Si appeler une IA coûte cher, tu ne l’utiliserais que pour les endroits les plus importants.
Mais que se passerait-il si un jugement d’IA était suffisamment bon marché pour être presque négligeable ?
Un e-mail, un journal, un appel d’outil, un bouton sur une page : à chaque étape de l’exécution d’un Agent, un jugement d’IA peut intervenir.
Bien sûr, dire aujourd’hui que Jev représente la prochaine génération d’IA, c’est encore trop tôt.
Ce que l’on appelle sa « zéro hallucination » signifie surtout qu’il ne va pas inventer n’importe quelle réponse en dehors des types de réponses prescrits ; des données extrêmes comme 193,6× et 444,6× proviennent aussi principalement des tests propres à TypeSafe.
Mais ce qui mérite vraiment d’être surveillé lors de ce boom de Jev, ce n’est peut-être pas seulement de savoir s’il peut défier GPT ou Claude.
… alors qu’il y a, justement, quelqu’un qui a participé à créer ChatGPT et qui repose maintenant une question plus fondamentale :
Ces dernières années, toute l’industrie s’est demandé comment faire en sorte que l’IA réfléchisse plus longtemps et en dise plus.
Mais si, à l’avenir, on a réellement besoin de dizaines de milliards de jugements entre machines, pourquoi chaque fois l’IA doit-elle d’abord « dire un morceau » ?
ChatGPT a appris à la machine à parler aux humains.
Et l’étape suivante sur laquelle mise Jev, c’est : quand les humains ne seront plus assis devant l’écran, la machine pourra-t-elle décider elle-même ?