


Les facteurs de l’espace latent peuvent être analysés et utilisés pour générer des scénarios d’interventions biologiques testables en laboratoire ou pour reproduire des lois physiques, permettant à l’IA de passer de la simple prédiction à une interface de découverte scientifique explicable et vérifiable.
Auteur de l’article : QuanZi (Quantum Wei)
Source : Mars Finance (火星财经)
Un rapport technique fait apparaître, qui plus est, deux objets de recherche qui semblent sans rapport — suivre l’IA, c’est vraiment découvrir de nouvelles perspectives.
L’un est un organoïde issu de patients, l’autre s’étend jusqu’à l’échelle de l’univers macroscopique…
D’abord, parlons de cette dernière : les chercheurs utilisent les facteurs internes appris par le modèle pour proposer des scénarios d’intervention de type combinaison de cytokines avec blocage d’anticorps, puis valident le tout étape par étape via des expériences sur lignées cellulaires, organoïdes et souris.
Quant au second, les chercheurs alimentent le modèle avec les trajectoires simulées de positions et vitesses planétaires, sans lui dire la loi de Kepler.
Une fois l’apprentissage terminé, après analyse des modes de prédiction internes, la pente ajustée de la relation « fréquence de l’orbite – demi-grand axe » vaut -1,4991 (la valeur théorique de la troisième loi de Kepler est -1,5) et le coefficient R² = 0,99999999.
Deux domaines qui n’ont apparemment rien à voir — la recherche sur les tumeurs et le calcul d’orbites planétaires — arrivent pourtant à être résolus avec la même méthode d’apprentissage par prédiction.
Le monde est vaste et varié : la météo, les molécules, les cellules, les patients, les robots et même les planètes suivent chacun des lois totalement différentes.
Mais quand l’IA comprend « comment » ces systèmes évoluent, pourrait-elle partager une méthode plus fondamentale ?
Récemment, le JEPA-Anything de PhAI Labs, publié en collaboration avec des équipes d’Oxford, Stanford, Princeton, le CUHK et d’autres universités, tente justement de répondre à cette question.
Le papier montre que JEPA-Anything est un cadre inter-domaines orienté vers des modèles de prédiction de l’apprentissage de différents « mondes ».
Dans chaque domaine, on conserve sa forme d’observation, la construction context-target et l’encodeur, mais on partage le cœur de prédiction en aval ainsi qu’une interface unifiée de latent world-state.
Parmi eux se trouve un mécanisme clé appelé OPF (Orthogonal Predictive Factorization, factorisation prédictive orthogonale).
On peut d’abord le comprendre simplement comme suit :
Ne regroupe pas tous les changements du monde, entassés ensemble, pour les apprendre à modéliser.
Modéliser le monde : un seul chemin de prédiction ne suffit pas. D’abord, clarifions un concept : dans l’étude JEPA-Anything, que signifie exactement « modèle du monde » ?
La définition fournie par le papier JEPA-Anything combine à la fois généralité et opérationnalité.
Le papier écrit que tant que le modèle peut, à partir des informations disponibles (Context), construire un état interne et prédire un autre état du même système, alors cela peut être classé dans la catégorie des modèles du monde à espace latent (Latent World Model).
Ici, « un autre état » peut être un état futur dans le temps, ou encore une région cachée dans l’espace, un point de vue différent, voire le résultat après l’application d’une certaine intervention.
En suivant cette idée, l’industrie a déjà développé au cours des dernières années des trajectoires technologiques de plus en plus mûres.
Par exemple, DreamerV3 souligne l’importance de d’abord construire un modèle de l’environnement, puis de « concevoir » les conséquences d’actions à l’intérieur du modèle ; V-JEPA 2 combine l’apprentissage de représentations vidéo et le contrôle robotique : avant de planifier ses mouvements, le bras mécanique prédit le feedback physique provoqué par différentes actions.
Et JEPA — Joint-Embedding Predictive Architecture (architecture de prédiction par co-embedding), représentative de l’une des voies pertinentes.
Plutôt que de reconstruire directement l’état cible dans l’espace original, JEPA choisit d’effectuer des prédictions dans l’espace de représentation : il n’est pas nécessaire de restaurer chaque pixel ou chaque détail.
Il encode d’abord l’information des observations en représentations internes dans l’espace latent, puis réalise la prédiction dans cet espace de représentation.
Ce type de conception laisse au modèle davantage de capacités de représentation pour les structures ayant une valeur de prédiction, et réduit les perturbations dues à des détails bruts d’espace comme la texture et le bruit.
En revanche, JEPA standard fait généralement converger toute l’information vers un même embedding cible et suit le même chemin de prédiction.
Mais les changements du monde réel ne sont généralement pas monothread.
Par exemple, le déplacement global des molécules s’accompagne souvent de vibrations microscopiques des atomes internes ; dans l’évolution lente des systèmes météorologiques macroscopiques, des perturbations locales intenses se mêlent ; et, dans les systèmes biologiques, c’est encore plus complexe : des changements à plusieurs échelles et via de multiples voies se synchronisent à tout instant.
Quand des signaux de différentes échelles, de différentes entités et de différentes difficultés sont forcés à se compresser ensemble, les signaux plus faciles à prédire et dont les changements sont plus marqués peuvent d’abord occuper plus de capacité de prédiction.
En revanche, les informations relativement faibles mais pourtant cruciales sont soit compensées dans les conflits de gradients, soit totalement masquées par les signaux forts.
Les chercheurs le résument comme un problème de « la manière dont la capacité de prédiction est répartie », et proposent de nouvelles pistes de solution.
Puisque l’encombrement entraîne un écrasement, il faut décorréler l’espace.
C’est ainsi qu’est né JEPA-Anything.
Son mécanisme central, l’OPF (factorisation prédictive orthogonale), découpe l’état cible initialement complet en plusieurs sous-espaces mutuellement complémentaires, confiés à différentes branches de prédiction traitées indépendamment, puis finalement recombinés pour reconstruire l’état du monde complet.
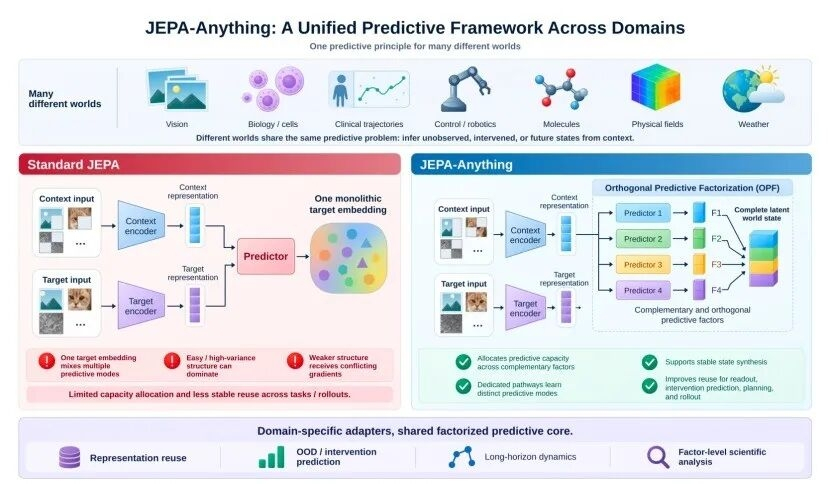
Pour empêcher que des évolutions multi-branches ne deviennent un état redondant où « plusieurs équipes apprennent la même chose », l’OPF introduit des contraintes d’orthogonalité : les différents facteurs occupent autant que possible des directions de prédiction qui ne se chevauchent pas. Cela réduit la re-apprentissage d’une même classe d’informations par plusieurs branches ; en outre, grâce aux contraintes d’activité des facteurs et à la contrainte de variance de l’encodeur, on évite que certains facteurs ne deviennent inactifs et on réduit le risque d’effondrement des représentations.
À noter que ces facteurs ne sont pas pré-définis comme : « tu gères la vitesse », « tu gères la température », « tu gères telle voie biologique ».
Ce qu’ils apprennent est déterminé par les structures prédictibles présentes dans les données.
Après l’entraînement, ces facteurs laissent ainsi une interface interne exploitable pour des analyses ultérieures.
Peu importe à quel point on formule joliment la méthodologie de validation sur sept catégories de systèmes avec le même cœur de prédiction : au final, elle doit encore être validée par une généralisation inter-domaines.
Il faut donc mentionner l’originalité du design expérimental de JEPA-Anything.
Il ne s’est pas limité aux domaines traditionnels comme la représentation vidéo ou le contrôle robotique : il place directement le même cœur de prédiction (Predictive Core) dans sept systèmes nettement différents — vision, biologique, clinique, contrôle, moléculaire, champs physiques et météo — pour validation.
La notion « Anything » ne signifie pas qu’on mélange forcément les données de tous les domaines pour les reconstruire sous un même format d’entrée : images, séquences de cellules uniques, structures moléculaires et même données météorologiques conservent encore leurs encodeurs et formes de données les plus adaptés.
Ce qu’il unifie, c’est l’ensemble de règles fondamentales suivant :
Une fois les données converties en représentations d’espace latent, comment doit-on construire la partie de prédiction et réaliser l’apprentissage ?
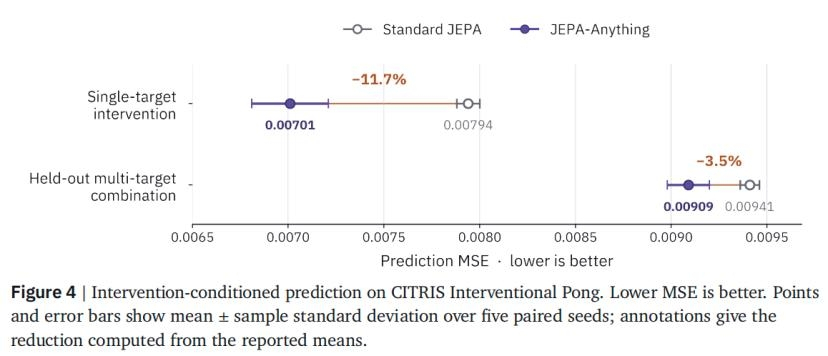
Le papier effectue d’abord des expériences dans CITRIS Interventional Pong, un environnement dynamique contrôlé construit à partir d’un Pong simplifié, afin de vérifier si le modèle peut « décomposer l’apprentissage » des changements composites puis les recombiner.
Durant l’entraînement, le modèle ne reçoit que des données de changements d’un seul facteur. Pendant le test, il faut faire face à des interventions combinatoires de plusieurs facteurs jamais apparues auparavant.
Si le modèle se contente d’enregistrer mécaniquement tous les motifs du jeu d’entraînement, il échouera forcément face à toute combinaison nouvelle ; si au contraire le modèle apprend des règles de changement d’état réutilisables entre différentes transformations, il a davantage de chances de recombiner ces règles pour de combinaisons jamais vues.
Les résultats expérimentaux montrent qu’en interventions unitaires au sein de la distribution, JEPA-Anything réduit d’environ 11,7 % l’erreur de prédiction par rapport à JEPA standard ; et, pour des interventions combinatoires à facteurs jamais vus, l’erreur quadratique moyenne (MSE) baisse aussi d’environ 3,5 %, avec une amélioration totale sur cinq seeds de training en appariement.
Ensuite, la validation s’est orientée vers des systèmes réels plus complexes.
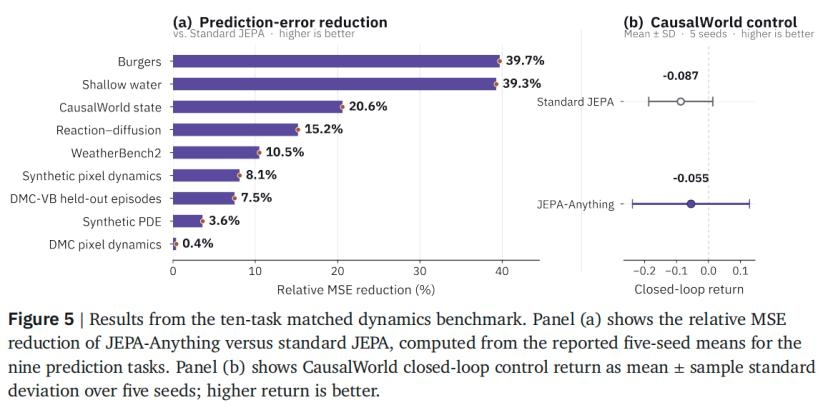
L’article construit un banc d’essai de dynamique rigoureusement aligné (Matched Dynamics Benchmark) : sur dix tâches, il garantit que JEPA standard et JEPA-Anything utilisent exactement les mêmes données d’entraînement, encodeurs, réseaux de base de transition d’état, budgets de calcul et découpages d’évaluation.
Parmi les neuf tâches de prédiction, les indicateurs de performance de JEPA-Anything s’améliorent tous.
Par exemple, sur l’équation de Burgers dans PDEBench, la MSE baisse de 39,7 % ; sur l’équation des eaux peu profondes, elle baisse de 39,3 % ; et sur WeatherBench 2, elle baisse de 10,5 %.
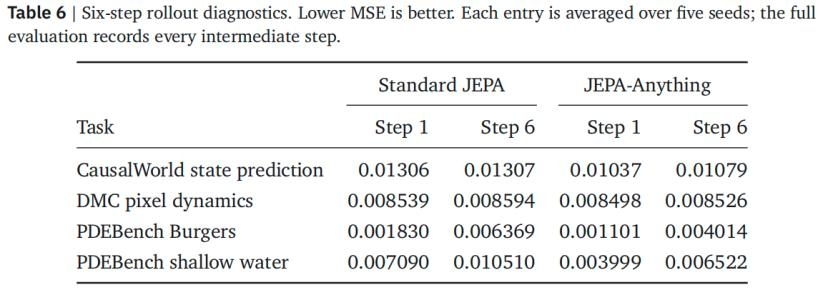
Le papier fait aussi des rollouts sur plusieurs pas : à chaque prédiction, on la laisse devenir l’entrée de la suivante, afin d’observer ce qui se produit lorsque l’erreur se transmet de manière continue.
Dans les systèmes moléculaires, on étire davantage la chronologie.
Dans quatre systèmes — eau liquide, α-quartz, paracétamol et benzène — le modèle doit continuellement prédire les positions et vitesses atomiques futures, et réinjecter en continu ses sorties en entrée.
Finalement, aussi bien l’erreur MAE lors des prédictions à un pas que le RMSD de la position après un rollout libre de 100 pas : dans quatre systèmes moléculaires différents, JEPA-Anything a obtenu la plus faible erreur.
Cependant, il faut noter que les données expérimentales ne présentent pas une courbe idéale où un mécanisme unique écrase tout le reste.
En test de contrôle continu, JEPA-Anything n’est pas systématiquement meilleur sur chaque tâche : sur Walker2d et HalfCheetah, son score moyen est supérieur à celui de JEPA standard ; mais sur Hopper, c’est JEPA standard qui est plus performant.
Plus on s’éloigne de la distance de la prédiction continue, plus l’erreur s’accumule.
Sur des tests additionnels de Burgers, lorsque la longueur de prédiction passe de 20 pas à 50 pas, JEPA-Anything reste en tête, mais son avantage diminue nettement.
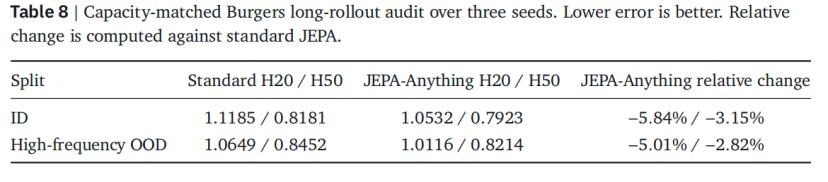
Ainsi, ce rapport vérifie l’existence d’une « applicabilité inter-domaines du principe de prédiction », plutôt que l’idée qu’« un unique modèle du monde pour tous les domaines est déjà implémenté ».
Mais au moins ces résultats indiquent que ce principe de prédiction possède un potentiel de réutilisation inter-domaines.
La structure apprise par JEPA-Anything peut-elle résister à une vérification externe ? Les expériences précédentes répondaient surtout à la question de savoir si la prédiction et la représentation d’état sont valides. Avec la troisième série d’expériences, le papier poursuit une question encore plus approfondie :
Les facteurs (factor) formés dans l’espace latent du modèle possèdent-ils, en fin de compte, une valeur pour l’exploration scientifique ?
C’est ainsi qu’apparaissent, en introduction de cet article, deux exemples de recherche aux styles très différents, mais étrangement complémentaires.
Cas 1 : de facteurs internes à une intervention candidate vérifiable. Dans la recherche sur le cancer du foie, les chercheurs ne considèrent pas simplement JEPA-Anything comme un « prédicteur boîte noire » : ils analysent dans le domaine les coordonnées de facteurs orthogonaux (Orthogonal Factor Coordinates) formées en interne, puis en extraient une combinaison candidate : l’association IL-18 avec le blocage NT5E/CD73.
L’équipe a ensuite poussé le dispositif jusqu’au système de co-culture Huh7-PBMC, puis aux organoïdes de carcinome hépatocellulaire issus de patients et aux fragments de tumeurs, avant d’ajouter une validation avec des souris immunocompétentes.
Les données expérimentales montrent que, dans 3 organoïdes de patients et 3 fragments de tissus tumoraux, la combinaison d’inhibiteurs IL-18 et CD73 présente le plus fort potentiel de destruction des cellules tumorales et s’accompagne d’une activation immunitaire significativement renforcée.
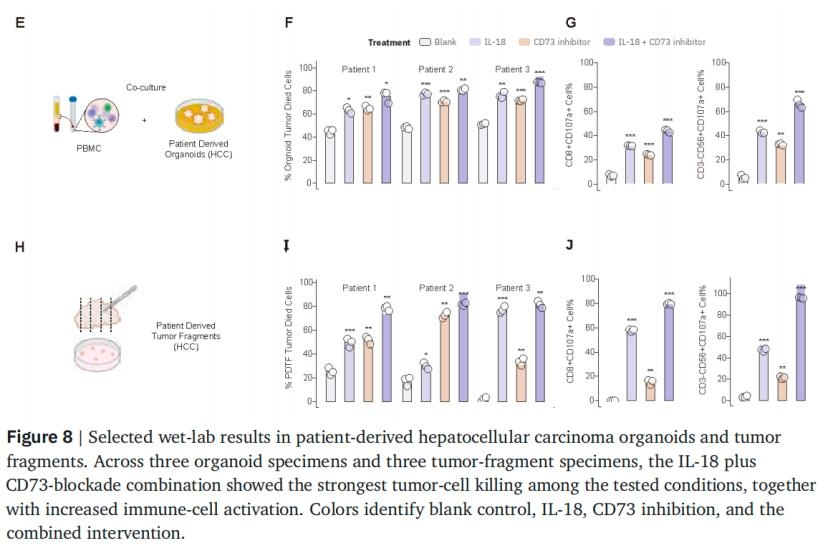
Cela implique que le Latent Factor interne n’est plus seulement chargé de rendre les nombres de prédiction « plus jolis ».
Il devient une interface permettant aux chercheurs d’analyser l’état d’un système et de proposer des hypothèses candidates testables expérimentalement, formant ainsi une chaîne « structure interne du modèle → analyse du domaine → intervention candidate → validation expérimentale ».
Cas 2 : le « rapprochement » d’orbites planétaires, des modes latents vers des lois physiques connues. Cette expérience, au lieu de se limiter à ce que les humains savent déjà, prend en sens inverse la troisième loi de Kepler connue de l’humanité pour vérifier si ce que le modèle apprend en interne a une signification physique.
Les chercheurs ne font entrer dans le modèle que les trajectoires de position et de vitesse des planètes générées par simulation, sans aucune formule a priori.
Après l’entraînement, les chercheurs effectuent une analyse spectrale des modes latents (Latent Modes) du modèle, puis associent les fréquences extraites à la longueur du demi-grand axe de l’orbite.
Les résultats montrent qu’en l’absence de formules fixées à l’avance, les chercheurs parviennent tout de même à extraire, à partir des modes latents appris par le modèle, des lois d’échelle très cohérentes avec la relation entre ces variables — la pente ajustée est -1,4991, très proche de la valeur théorique -1,5, avec une erreur extrêmement faible.
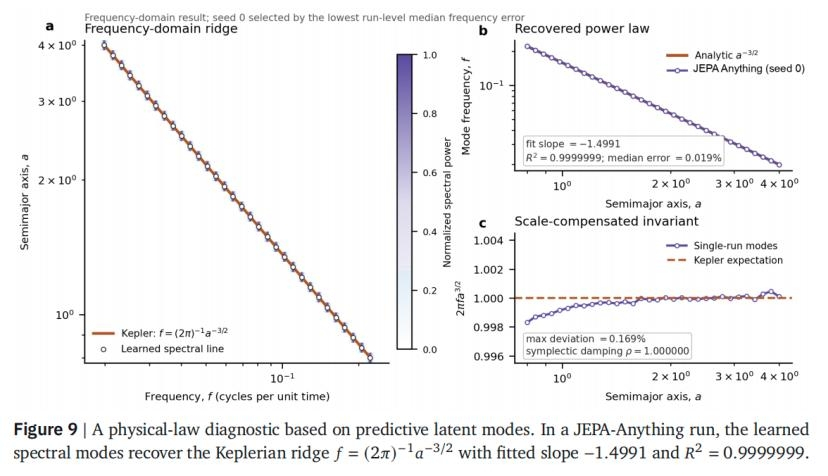
Un exemple part des facteurs internes et va vers des expériences humides ; l’autre sort les modes internes et les confronte aux lois physiques déjà connues.
Les deux fournissent, dans des directions différentes, des preuves d’exemples montrant que la structure interne apprise par le modèle peut devenir une interface d’analyse scientifique.
Les chercheurs ne sont pas forcément limités à n’observer qu’un chiffre de prédiction à l’aboutissement : peuvent-ils continuer à l’interroger et comprendre quelles transformations il capture ? Ces transformations correspondent-elles à de vraies lois ? Peut-on en tirer quelque chose qui mérite d’être vérifié dans la prochaine étape ?
C’est précisément la place de JEPA-Anything dans le cadre stratégique global de PhAI Labs.
Auparavant, PhAI Labs a proposé des « Discovery Foundation Models » (DFM), visant à faire évoluer l’IA vers une exploration scientifique ouverte.
Dans la vision des DFM, l’IA doit davantage participer à l’identification de l’inconnu, à la formulation d’hypothèses, à la conception d’interventions, et à un processus de découverte scientifique qui se corrige continuellement en fonction des preuves externes.
JEPA-Anything se situe à l’étage du modèle du monde dans cette architecture.
Il cherche à compresser la trajectoire scientifique et la part de ce qui est prédictible dans les changements du monde réel en une capacité de prédiction plus rapide à mobiliser, afin de fournir une couche d’approximation avant de mener des expériences réelles, plus longues et plus coûteuses.
À ce stade, en reconsidérant l’ampleur « des cellules cancéreuses aux orbites planétaires », sa signification ne se limite plus à montrer un contraste visuel ou un effet conceptuel accrocheur.
Ce que les chercheurs explorent, c’est si, face à des systèmes complexes dont les mécanismes diffèrent fortement, l’IA peut partager une méthode d’apprentissage de la « logique d’évolution » ; et, une fois ces changements encodés dans l’état interne, si ces structures internes peuvent être sorties et analysées par les chercheurs, puis confrontées à des résultats expérimentaux et à des lois connues.
On est encore loin de « comprendre tout le monde » par l’IA. JEPA-Anything fournit plutôt, pour l’instant, quelque chose qui ressemble à une possibilité :
La structure apprise à l’intérieur du modèle du monde sert non seulement la prédiction, mais peut aussi être analysée davantage par les chercheurs, puis faire l’objet de tests expérimentaux et de validations par des lois connues.
Autrement dit, le modèle ne se contente pas de prédire un monde : il commence aussi à exposer le « monde » qu’il a appris, afin que les scientifiques puissent poursuivre leurs recherches.