Je fais des recherches sur KGeN récemment, et il y a un changement assez évident.
Avant, quand je voyais ce genre de projet, je commençais par regarder :
le prix des pièces.
Aujourd’hui, je me pose d’abord cette question :
à quel problème précis il répond ?
La réponse de KGeN pour moi est assez simple :
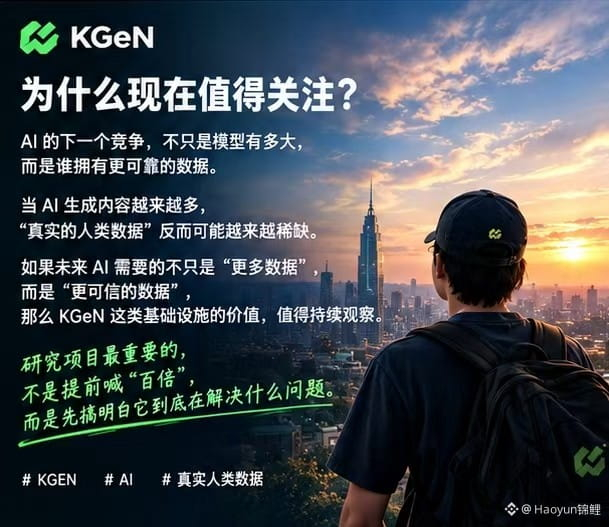
L’IA a besoin de données, mais à l’avenir, elle aura peut-être encore plus besoin de “données humaines de confiance”.
Ce raisonnement est en fait assez facile à comprendre.
Imaginons que vous fassiez apprendre à une IA 100 millions de contenus internet.
Ça a l’air énorme.
Mais si une grande partie de ces contenus a été générée par des robots, par une IA, qu’il s’agit de contenu répété, de faible qualité…
Alors même en très grande quantité, ça ne sert pas à grand-chose.
À l’inverse, si les données viennent de pays différents, de langues différentes, de contextes de vie différents, et qu’en plus, derrière, il s’agit vraiment de personnes réelles vérifiées, alors la valeur peut être totalement différente.
C’est exactement vers cette direction que KGeN avance maintenant.
Officiellement, l’équipe considère actuellement le réseau comme un “Verified Human Network”, puis l’étend davantage aux données multimodales, à l’IA physique et aux LLM.
Ce que j’aime particulièrement dans ce projet, c’est que :
il ne cherche pas du tout à vous dire “l’IA est très sexy, donc il faut aussi faire de l’IA”.
Au lieu de ça, il part d’un problème plus concret :
quand l’IA deviendra de plus en plus puissante, où pourra-t-on encore trouver de vrais humains ?
Pour moi, la question a-t-elle de la valeur ? Je pense qu’il ne faut pas tirer de conclusion trop vite.
Regardez simplement les besoins en données à venir, les collaborations commerciales et les usages réels : la réponse finira par s’imposer.
Le plus important dans un projet de recherche n’est pas de lancer prématurément des promesses du type “cent fois”, mais d’abord de comprendre exactement à quel problème il tente de répondre.
C’est d’ailleurs le ressenti principal que j’ai eu en découvrant KGeN récemment.
#KGEN 🟩
Avant, quand je voyais ce genre de projet, je commençais par regarder :
le prix des pièces.
Aujourd’hui, je me pose d’abord cette question :
à quel problème précis il répond ?
La réponse de KGeN pour moi est assez simple :
L’IA a besoin de données, mais à l’avenir, elle aura peut-être encore plus besoin de “données humaines de confiance”.
Ce raisonnement est en fait assez facile à comprendre.
Imaginons que vous fassiez apprendre à une IA 100 millions de contenus internet.
Ça a l’air énorme.
Mais si une grande partie de ces contenus a été générée par des robots, par une IA, qu’il s’agit de contenu répété, de faible qualité…
Alors même en très grande quantité, ça ne sert pas à grand-chose.
À l’inverse, si les données viennent de pays différents, de langues différentes, de contextes de vie différents, et qu’en plus, derrière, il s’agit vraiment de personnes réelles vérifiées, alors la valeur peut être totalement différente.
C’est exactement vers cette direction que KGeN avance maintenant.
Officiellement, l’équipe considère actuellement le réseau comme un “Verified Human Network”, puis l’étend davantage aux données multimodales, à l’IA physique et aux LLM.
Ce que j’aime particulièrement dans ce projet, c’est que :
il ne cherche pas du tout à vous dire “l’IA est très sexy, donc il faut aussi faire de l’IA”.
Au lieu de ça, il part d’un problème plus concret :
quand l’IA deviendra de plus en plus puissante, où pourra-t-on encore trouver de vrais humains ?
Pour moi, la question a-t-elle de la valeur ? Je pense qu’il ne faut pas tirer de conclusion trop vite.
Regardez simplement les besoins en données à venir, les collaborations commerciales et les usages réels : la réponse finira par s’imposer.
Le plus important dans un projet de recherche n’est pas de lancer prématurément des promesses du type “cent fois”, mais d’abord de comprendre exactement à quel problème il tente de répondre.
C’est d’ailleurs le ressenti principal que j’ai eu en découvrant KGeN récemment.
#KGEN 🟩