$ETH Vitalik : la conception de mécanismes adverses pourrait être la clé de la sécurité de l’IA
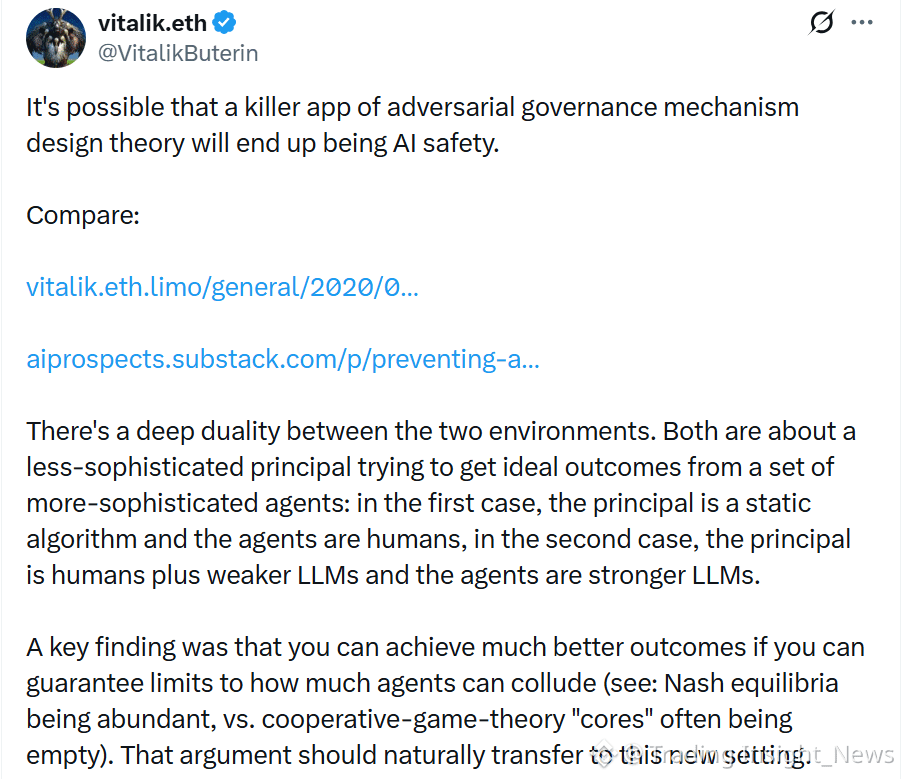
Vitalik Buterin vient de faire une comparaison marquante : la théorie de la conception de mécanismes adverses, familière en crypto, pourrait avoir une application importante pour la sécurité de l’IA.
Les deux domaines partagent une structure binaire profonde entre le principal et l’agent :
En crypto : le principal est un algorithme statique (capacité limitée), l’agent est un humain (capacité plus forte).
En IA : le principal est un humain et un LLM plus faible, l’agent est un LLM plus puissant.
Des recherches connexes montrent que si vous pouvez limiter le niveau de collusion entre les agents, vous pouvez obtenir de meilleurs résultats. Cette conclusion pourrait s’appliquer directement à la sécurité de l’IA.
C’est l’une des idées les plus intéressantes que Vitalik a partagées récemment. Le problème central de la sécurité de l’IA est le suivant : comment les humains peuvent-ils contrôler un système plus intelligent qu’eux ?
La réponse, la crypto l’a apprise au fil des années : ne pas contrôler en faisant confiance, contrôler par la conception de mécanismes. Les mécanismes adverses où les parties ont des intérêts divergents et se contrôlent mutuellement se sont révélés efficaces dans les protocoles blockchain.
Appliquer cette logique à l’IA est une approche nouvelle. Au lieu d’essayer de « former » l’IA pour qu’elle soit bonne, nous pourrions concevoir des environnements où les agents d’IA se vérifient et se contraignent les uns les autres.
Pensez-vous que les mécanismes adverses pourraient être une solution réelle à la sécurité de l’IA, ou seulement une approche théorique ?
Les informations sont fournies à titre indicatif, et ne constituent pas un conseil en investissement. Veuillez lire attentivement avant de prendre une décision.
Vitalik Buterin vient de faire une comparaison marquante : la théorie de la conception de mécanismes adverses, familière en crypto, pourrait avoir une application importante pour la sécurité de l’IA.
Les deux domaines partagent une structure binaire profonde entre le principal et l’agent :
En crypto : le principal est un algorithme statique (capacité limitée), l’agent est un humain (capacité plus forte).
En IA : le principal est un humain et un LLM plus faible, l’agent est un LLM plus puissant.
Des recherches connexes montrent que si vous pouvez limiter le niveau de collusion entre les agents, vous pouvez obtenir de meilleurs résultats. Cette conclusion pourrait s’appliquer directement à la sécurité de l’IA.
C’est l’une des idées les plus intéressantes que Vitalik a partagées récemment. Le problème central de la sécurité de l’IA est le suivant : comment les humains peuvent-ils contrôler un système plus intelligent qu’eux ?
La réponse, la crypto l’a apprise au fil des années : ne pas contrôler en faisant confiance, contrôler par la conception de mécanismes. Les mécanismes adverses où les parties ont des intérêts divergents et se contrôlent mutuellement se sont révélés efficaces dans les protocoles blockchain.
Appliquer cette logique à l’IA est une approche nouvelle. Au lieu d’essayer de « former » l’IA pour qu’elle soit bonne, nous pourrions concevoir des environnements où les agents d’IA se vérifient et se contraignent les uns les autres.
Pensez-vous que les mécanismes adverses pourraient être une solution réelle à la sécurité de l’IA, ou seulement une approche théorique ?
Les informations sont fournies à titre indicatif, et ne constituent pas un conseil en investissement. Veuillez lire attentivement avant de prendre une décision.