Anthropic 这次给什么是“非法蒸馏”科普了😛 Dans le tout dernier « rapport de détection et de lutte contre l’abus d’IA », en plus des attaques informatiques, des opérations de surveillance, des fermes de bots (watercamps), des fraudes et des abus biologiques, on y détaille aussi ouvertement les pratiques d’« illegal distillation » de sept laboratoires chinois d’IA ! D’abord, écartons les bonnes intentions consistant à utiliser la distillation pour des modèles à poids ouverts afin de « parvenir à une égalité intelligente » pour tous : le point de relais, c’est une atteinte à la vie privée vraiment terrifiante. En cas de besoin, ne les détournez surtout pas…
La distillation, en soi, est une technique d’entraînement légale : avec un modèle « enseignant » grand et puissant, on génère des réponses à partir d’un lot d’entrées, puis on utilise ces questions-réponses pour entraîner un modèle « étudiant » plus petit, afin d’imiter l’enseignant et d’obtenir des capacités supérieures à moindre coût.
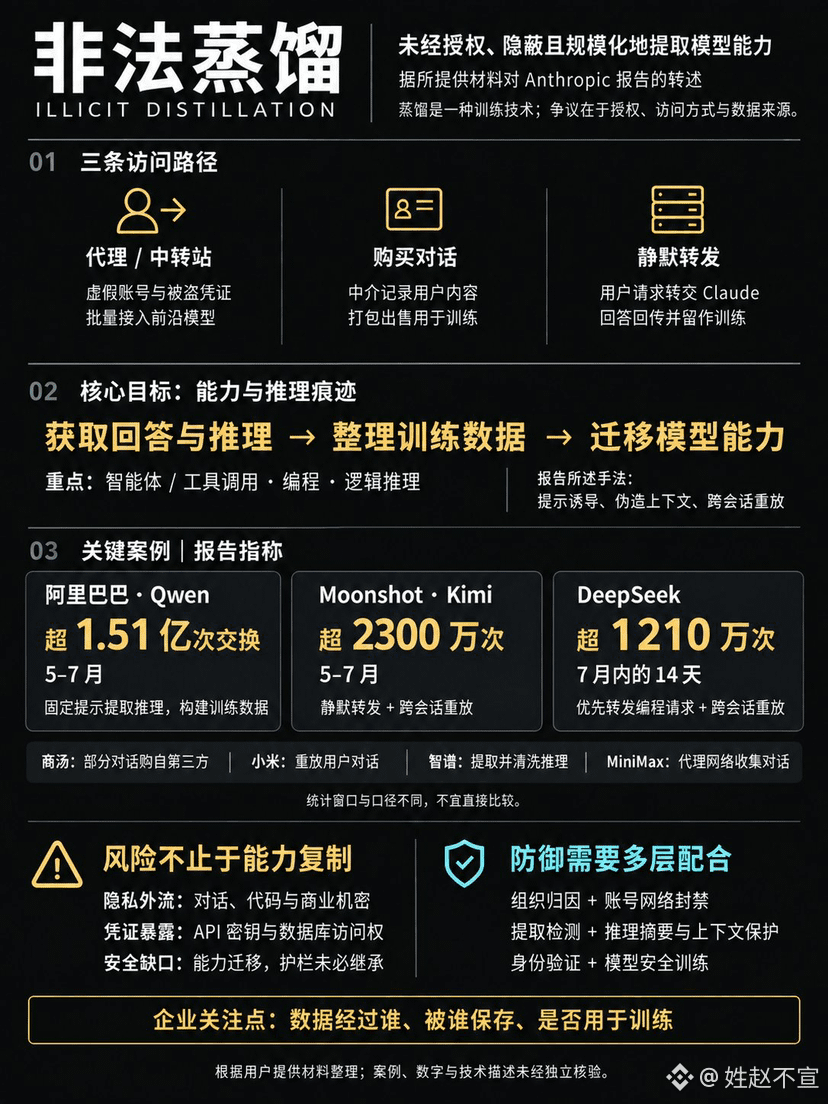
Dans le rapport, la « distillation illégale » est définie ainsi : procéder à grande échelle, de manière discrète, et extraire sans autorisation les capacités d’un modèle pour les reproduire dans un autre. Son trait central repose sur la fraude : fabriquer des milliers de faux comptes en s’appuyant sur des identités bidon, des cartes bancaires dérobées / des cartes de crédit virtuelles, des identifiants de connexion volés et des clés API.
Trois voies principales :
1. Services de proxy / « relais » : via des services de proxy qui acheminent les requêtes, en utilisant de fausses identités, de fausses cartes ou des cartes volées, ainsi que des clés API dérobées, pour inscrire en masse des milliers de comptes et contourner les restrictions géographiques. Les identifiants volés sont souvent ceux d’entreprises ou de personnes légitimes, ce qui nuit directement aux clients réels ;
2. Acheter des historiques de conversation auprès de revendeurs tiers
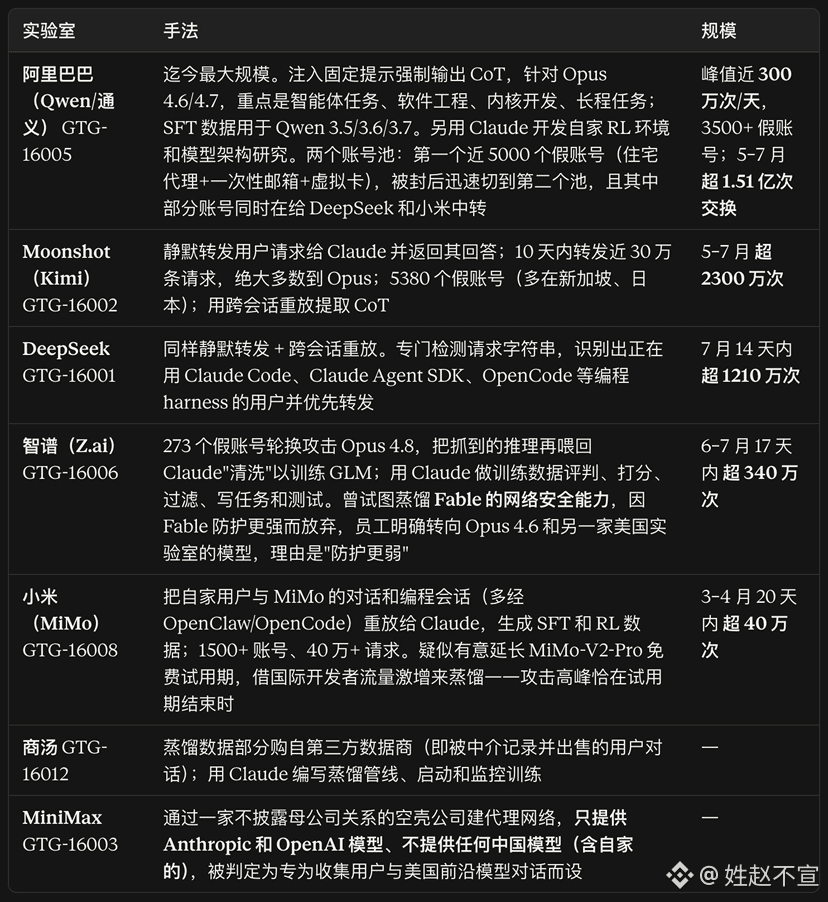
Certains opérateurs de services de proxy conservent l’intégralité des conversations des utilisateurs avec des modèles américains, sans que les utilisateurs en aient connaissance et sans consentement, puis les emballent pour les vendre à des laboratoires (le pipeline de distillation de SenseTime s’est servi de ce type d’historiques achetés) ;
3. Transfert silencieux des requêtes de ses propres utilisateurs (le plus discret) : le laboratoire transmet secrètement les requêtes de ses utilisateurs à Claude, puis renvoie la réponse de Claude à l’utilisateur comme si elle provenait de son propre modèle, tout en conservant ces échanges pour l’entraînement. C’est la méthode de Moonshot et de DeepSeek ! On ne peut que reconnaître les performances du produit 😆
Le fait de monnayer la vie privée des utilisateurs est la conséquence la plus grave. DeepSeek, Xiaomi et Moonshot fournissent des conversations de leurs utilisateurs à Claude, sans que les utilisateurs en soient informés. Bon nombre des requêtes proviennent de services tiers de routage de modèles couramment utilisés en Europe et aux États-Unis, impliquant des centaines d’utilisateurs finaux et au moins une douzaine de langues de noms, d’e-mails et de données d’entreprise.
La distillation, en soi, est une technique d’entraînement légale : avec un modèle « enseignant » grand et puissant, on génère des réponses à partir d’un lot d’entrées, puis on utilise ces questions-réponses pour entraîner un modèle « étudiant » plus petit, afin d’imiter l’enseignant et d’obtenir des capacités supérieures à moindre coût.
Dans le rapport, la « distillation illégale » est définie ainsi : procéder à grande échelle, de manière discrète, et extraire sans autorisation les capacités d’un modèle pour les reproduire dans un autre. Son trait central repose sur la fraude : fabriquer des milliers de faux comptes en s’appuyant sur des identités bidon, des cartes bancaires dérobées / des cartes de crédit virtuelles, des identifiants de connexion volés et des clés API.
Trois voies principales :
1. Services de proxy / « relais » : via des services de proxy qui acheminent les requêtes, en utilisant de fausses identités, de fausses cartes ou des cartes volées, ainsi que des clés API dérobées, pour inscrire en masse des milliers de comptes et contourner les restrictions géographiques. Les identifiants volés sont souvent ceux d’entreprises ou de personnes légitimes, ce qui nuit directement aux clients réels ;
2. Acheter des historiques de conversation auprès de revendeurs tiers
Certains opérateurs de services de proxy conservent l’intégralité des conversations des utilisateurs avec des modèles américains, sans que les utilisateurs en aient connaissance et sans consentement, puis les emballent pour les vendre à des laboratoires (le pipeline de distillation de SenseTime s’est servi de ce type d’historiques achetés) ;
3. Transfert silencieux des requêtes de ses propres utilisateurs (le plus discret) : le laboratoire transmet secrètement les requêtes de ses utilisateurs à Claude, puis renvoie la réponse de Claude à l’utilisateur comme si elle provenait de son propre modèle, tout en conservant ces échanges pour l’entraînement. C’est la méthode de Moonshot et de DeepSeek ! On ne peut que reconnaître les performances du produit 😆
Le fait de monnayer la vie privée des utilisateurs est la conséquence la plus grave. DeepSeek, Xiaomi et Moonshot fournissent des conversations de leurs utilisateurs à Claude, sans que les utilisateurs en soient informés. Bon nombre des requêtes proviennent de services tiers de routage de modèles couramment utilisés en Europe et aux États-Unis, impliquant des centaines d’utilisateurs finaux et au moins une douzaine de langues de noms, d’e-mails et de données d’entreprise.