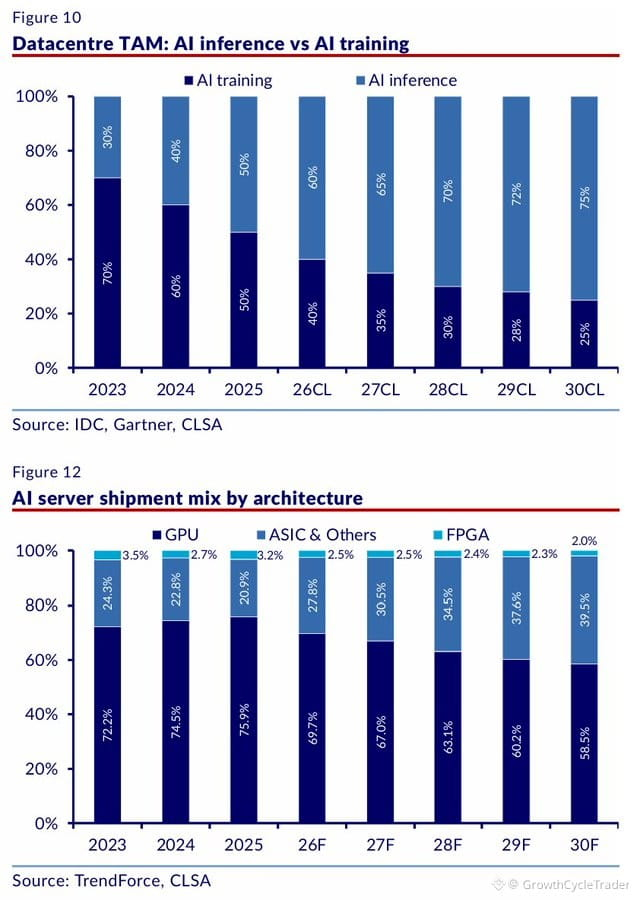
L’inférence est en train de devenir discrètement la prochaine grande histoire de chaîne d’approvisionnement à mille milliards de dollars. En 2023, l’inférence représentait environ 30 % de la demande en calcul liée à l’IA. D’ici 2030, elle devrait atteindre 75 %. Chaque chatbot, assistant de programmation, moteur de recherche et agent aura besoin d’une puissance de calcul constante pour répondre en temps réel.
Ce changement bouleverse l’ensemble de la pile d’infrastructure.
$AVGO en profite, car les puces IA sur mesure devraient passer de 24 % des livraisons de serveurs d’IA en 2023 à près de 40 % d’ici 2030. Marvell joue le rôle du volet réseau : les clusters d’IA ont besoin de connexions optiques à très haut débit pour faire circuler les données entre des milliers de puces.
Coherent et Lumentum fournissent les transceivers et les lasers qui propulsent les données à travers la fibre à des vitesses toujours plus élevées. Celestica construit les serveurs, les baies et les systèmes réseau réels pour les clients cloud et IA.
Vertiv gère le problème thermique. À mesure que les baies d’IA deviennent plus puissantes, le refroidissement par air cesse de fonctionner, ce qui stimule la demande en refroidissement liquide et en gestion thermique.
Eaton et Schneider Electric fournissent l’infrastructure électrique — appareillage de commutation, distribution d’énergie, transformateurs, systèmes de secours. Quanta Services construit les lignes de transport qui relient les campus d’IA au réseau.
La mémoire constitue un autre goulot d’étranglement. L’inférence exige que les modèles restent chargés et répondent instantanément, ce qui soutient la demande en mémoire à bande passante élevée de la part de $MU, SanDisk, SK Hynix et Samsung.
L’inférence n’est pas seulement une histoire logicielle. Elle crée une deuxième vague de demande en infrastructure physique, et la chaîne d’approvisionnement l’intègre déjà dans sa tarification.
Ce changement bouleverse l’ensemble de la pile d’infrastructure.
$AVGO en profite, car les puces IA sur mesure devraient passer de 24 % des livraisons de serveurs d’IA en 2023 à près de 40 % d’ici 2030. Marvell joue le rôle du volet réseau : les clusters d’IA ont besoin de connexions optiques à très haut débit pour faire circuler les données entre des milliers de puces.
Coherent et Lumentum fournissent les transceivers et les lasers qui propulsent les données à travers la fibre à des vitesses toujours plus élevées. Celestica construit les serveurs, les baies et les systèmes réseau réels pour les clients cloud et IA.
Vertiv gère le problème thermique. À mesure que les baies d’IA deviennent plus puissantes, le refroidissement par air cesse de fonctionner, ce qui stimule la demande en refroidissement liquide et en gestion thermique.
Eaton et Schneider Electric fournissent l’infrastructure électrique — appareillage de commutation, distribution d’énergie, transformateurs, systèmes de secours. Quanta Services construit les lignes de transport qui relient les campus d’IA au réseau.
La mémoire constitue un autre goulot d’étranglement. L’inférence exige que les modèles restent chargés et répondent instantanément, ce qui soutient la demande en mémoire à bande passante élevée de la part de $MU, SanDisk, SK Hynix et Samsung.
L’inférence n’est pas seulement une histoire logicielle. Elle crée une deuxième vague de demande en infrastructure physique, et la chaîne d’approvisionnement l’intègre déjà dans sa tarification.