Quand Dusk rencontre des problèmes, je me préoccupe davantage de qui a la main pour restaurer le réseau
En lisant la partie consensus de Dusk, je vois que le fonctionnement normal n’est pas l’endroit le plus inquiétant. Le plus intéressant, c’est le moment où le réseau n’arrive pas à atteindre le quorum de façon continue.
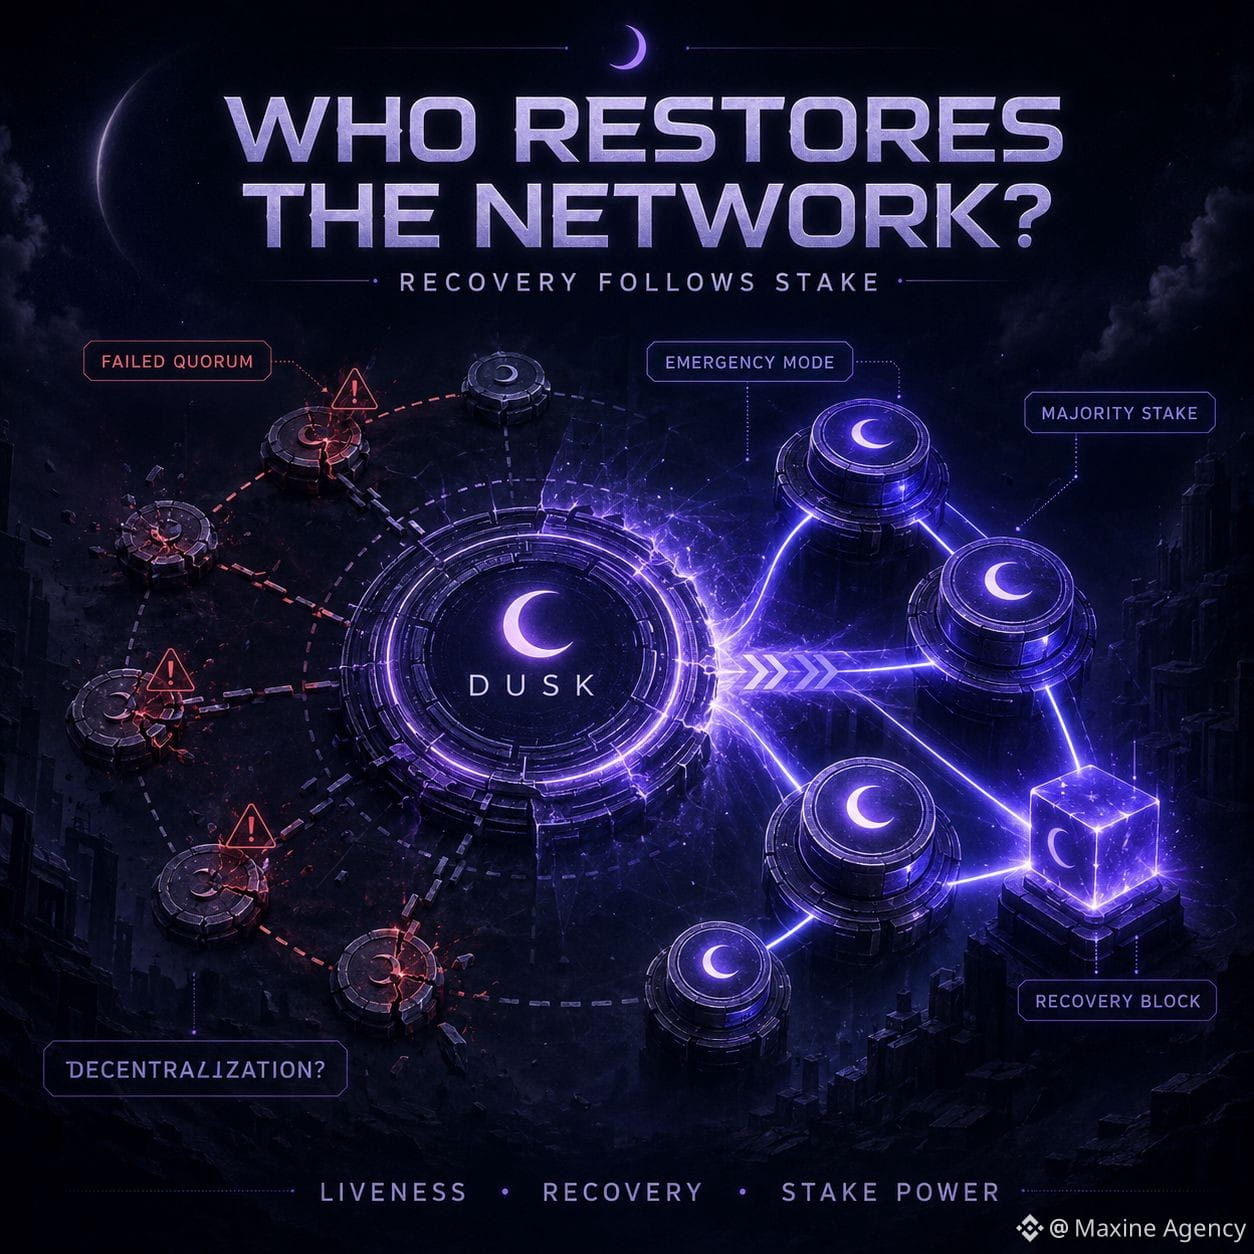
Après 16 itérations échouées, Succinct Attestation passe en mode d’urgence. Le timeout de chaque étape est supprimé, et plusieurs itérations peuvent être ouvertes en parallèle pour augmenter la probabilité de trouver un bloc valide. Si plusieurs candidats atteignent le consensus, le bloc correspondant à l’itération la plus basse est prioritaire.
Cette conception aide le réseau à ne pas rester bloqué uniquement à cause de quelques provisioners lents ou déconnectés. Mais elle m’amène aussi à m’attarder sur une autre limite : lorsque la qualité du réseau se dégrade, la capacité de récupération dépend de manière plus nette de la répartition du stake.
Dans le scénario final, le bloc d’urgence n’est créé que lorsque le groupe de provisioners le demande et qu’il contrôle la majorité du stake total du réseau. Alors que pour participer directement au consensus, un provisioner doit aujourd’hui disposer d’un stake minimum de 1.000 DUSK.
Ainsi, je ne vois pas seulement le staking comme un moyen de gagner des récompenses. Il détermine aussi qui a du poids quand le système doit sortir d’un état anormal.
À mon avis, le test le plus important pour Dusk n’est pas une journée où le réseau fonctionne parfaitement. C’est plutôt au moment où la congestion augmente, où quelques nœuds décrochent et où les comités changent continuellement : le réseau doit pouvoir se rétablir sans laisser le pouvoir de décision s’accumuler trop fortement au sein d’un groupe de stake important ou non.
Un mécanisme de recovery peut être très robuste techniquement.
Mais si le pouvoir de sauver le réseau se concentre de plus en plus selon le stake, alors c’est la décentralisation qui doit être mesurée avec le plus grand soin.
@Dusk $DUSK #dusk
$ONDO $BTC
En lisant la partie consensus de Dusk, je vois que le fonctionnement normal n’est pas l’endroit le plus inquiétant. Le plus intéressant, c’est le moment où le réseau n’arrive pas à atteindre le quorum de façon continue.
Après 16 itérations échouées, Succinct Attestation passe en mode d’urgence. Le timeout de chaque étape est supprimé, et plusieurs itérations peuvent être ouvertes en parallèle pour augmenter la probabilité de trouver un bloc valide. Si plusieurs candidats atteignent le consensus, le bloc correspondant à l’itération la plus basse est prioritaire.
Cette conception aide le réseau à ne pas rester bloqué uniquement à cause de quelques provisioners lents ou déconnectés. Mais elle m’amène aussi à m’attarder sur une autre limite : lorsque la qualité du réseau se dégrade, la capacité de récupération dépend de manière plus nette de la répartition du stake.
Dans le scénario final, le bloc d’urgence n’est créé que lorsque le groupe de provisioners le demande et qu’il contrôle la majorité du stake total du réseau. Alors que pour participer directement au consensus, un provisioner doit aujourd’hui disposer d’un stake minimum de 1.000 DUSK.
Ainsi, je ne vois pas seulement le staking comme un moyen de gagner des récompenses. Il détermine aussi qui a du poids quand le système doit sortir d’un état anormal.
À mon avis, le test le plus important pour Dusk n’est pas une journée où le réseau fonctionne parfaitement. C’est plutôt au moment où la congestion augmente, où quelques nœuds décrochent et où les comités changent continuellement : le réseau doit pouvoir se rétablir sans laisser le pouvoir de décision s’accumuler trop fortement au sein d’un groupe de stake important ou non.
Un mécanisme de recovery peut être très robuste techniquement.
Mais si le pouvoir de sauver le réseau se concentre de plus en plus selon le stake, alors c’est la décentralisation qui doit être mesurée avec le plus grand soin.
@Dusk $DUSK #dusk
$ONDO $BTC