

Hier, @Velvet_Capital a officiellement publié Velvet Flash 0.1. Il s’agit d’un modèle de 4 milliards de paramètres conçu spécifiquement pour les opérations de cryptomonnaies. Objectif clair et direct : atteindre à la fois la précision et la sécurité lors des interactions impliquant des fonds.
Les grands modèles généralistes gèrent souvent mal les scénarios crypto. Ils peuvent mal comprendre l’intention de l’utilisateur, choisir les mauvaises commandes de plateforme, se tromper lors de l’extraction des paramètres ou réagir trop lentement aux requêtes à haut risque.
\Velvet Flash a été conçu précisément pour répondre à ces points douloureux. Il doit comprendre avec précision l’objectif de l’utilisateur, choisir la bonne commande, extraire des paramètres clés comme le montant, le token, la chaîne et l’adresse, identifier les requêtes dangereuses, puis exécuter une confirmation avant toute opération impliquant des fonds.
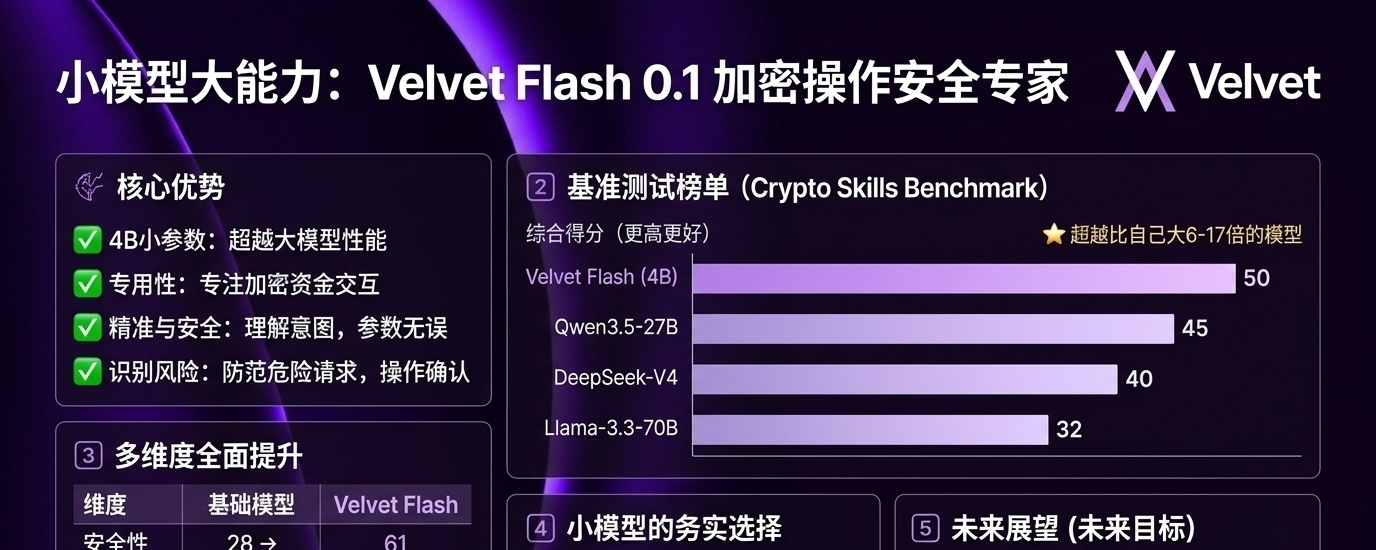
Dans un ensemble de tests de référence de compétences en cryptographie, Velvet Flash se classe premier avec un score total de 50. Viennent ensuite Qwen3.5-27B (45), DeepSeek-V4 (40), Llama-3.3-70B (32), tandis que les autres modèles obtiennent des scores plus faibles. À noter : son nombre de paramètres n’est que de 4B, mais il surpasse des modèles 6 à 17 fois plus grands que lui.
Les résultats de l’entraînement sont tout aussi évidents. Sans entraînement spécifique, le modèle de base n’obtient que 23 points, puis, après entraînement, il passe directement à 50. Les améliorations dans les cinq dimensions sont toutes très marquées : la sécurité passe de 28 à 61, la robustesse de 26 à 53, la clarté et l’expérience utilisateur de 22 à 52, le routage de 30 à 47 et la couverture de 12 à 34.
La sécurité est la priorité absolue. Pour les produits financiers, le modèle doit savoir quand continuer, quand poser des questions supplémentaires, quand avertir et quand refuser directement. Il doit aussi analyser correctement les montants, protéger les informations sensibles, détecter les demandes suspectes et ne jamais utiliser de fonds tant que la confirmation n’a pas été obtenue.
Certains grands modèles obtiennent de meilleurs résultats sur certaines plateformes. Par exemple, Qwen et Llama sont mieux notés sur Minara, et Qwen est aussi plus performant sur Binance spot. Toutefois, à l’échelle globale, les petits modèles présentent des avantages plus concrets : coût de service plus faible, latence réduite, exigences d’infrastructure moindres. De plus, ils fonctionnent entièrement sur vos propres serveurs, ce qui rend l’itération et le contrôle beaucoup plus flexibles.
Les tests de référence couvrent les plateformes clés comme Minara, Binance spot, OKX DEX, Uniswap, GMX et MetaMask, ainsi que des tests plus larges incluant 31 bourses centralisées, des wallets, des DEX et des outils DeFi. Tous les modèles utilisent les mêmes entrées et les mêmes critères d’évaluation, tout en bénéficiant de seuils de sécurité. Tout comportement consistant à transférer des fonds sans confirmation, ou à se tromper dans l’analyse des montants, est immédiatement pénalisé.
Velvet Flash 0.1 n’est que la première version. Par la suite, l’équipe continuera d’élargir la couverture des plateformes, d’affiner les cas limites, de renforcer les comportements de sécurité et d’améliorer la capacité à gérer des processus complexes en plusieurs étapes. L’objectif à long terme est de construire un ensemble de capacités internes afin de développer en continu des modèles spécialisés plus sûrs, plus rapides, moins coûteux et mieux adaptés aux besoins du produit.
Dans des contextes verticaux, les petits modèles entraînés spécifiquement sont souvent plus efficaces qu’un empilement aveugle de paramètres. En particulier en matière de sécurité des fonds, cette focalisation est vraiment convaincante. @EchoHunt_ai