
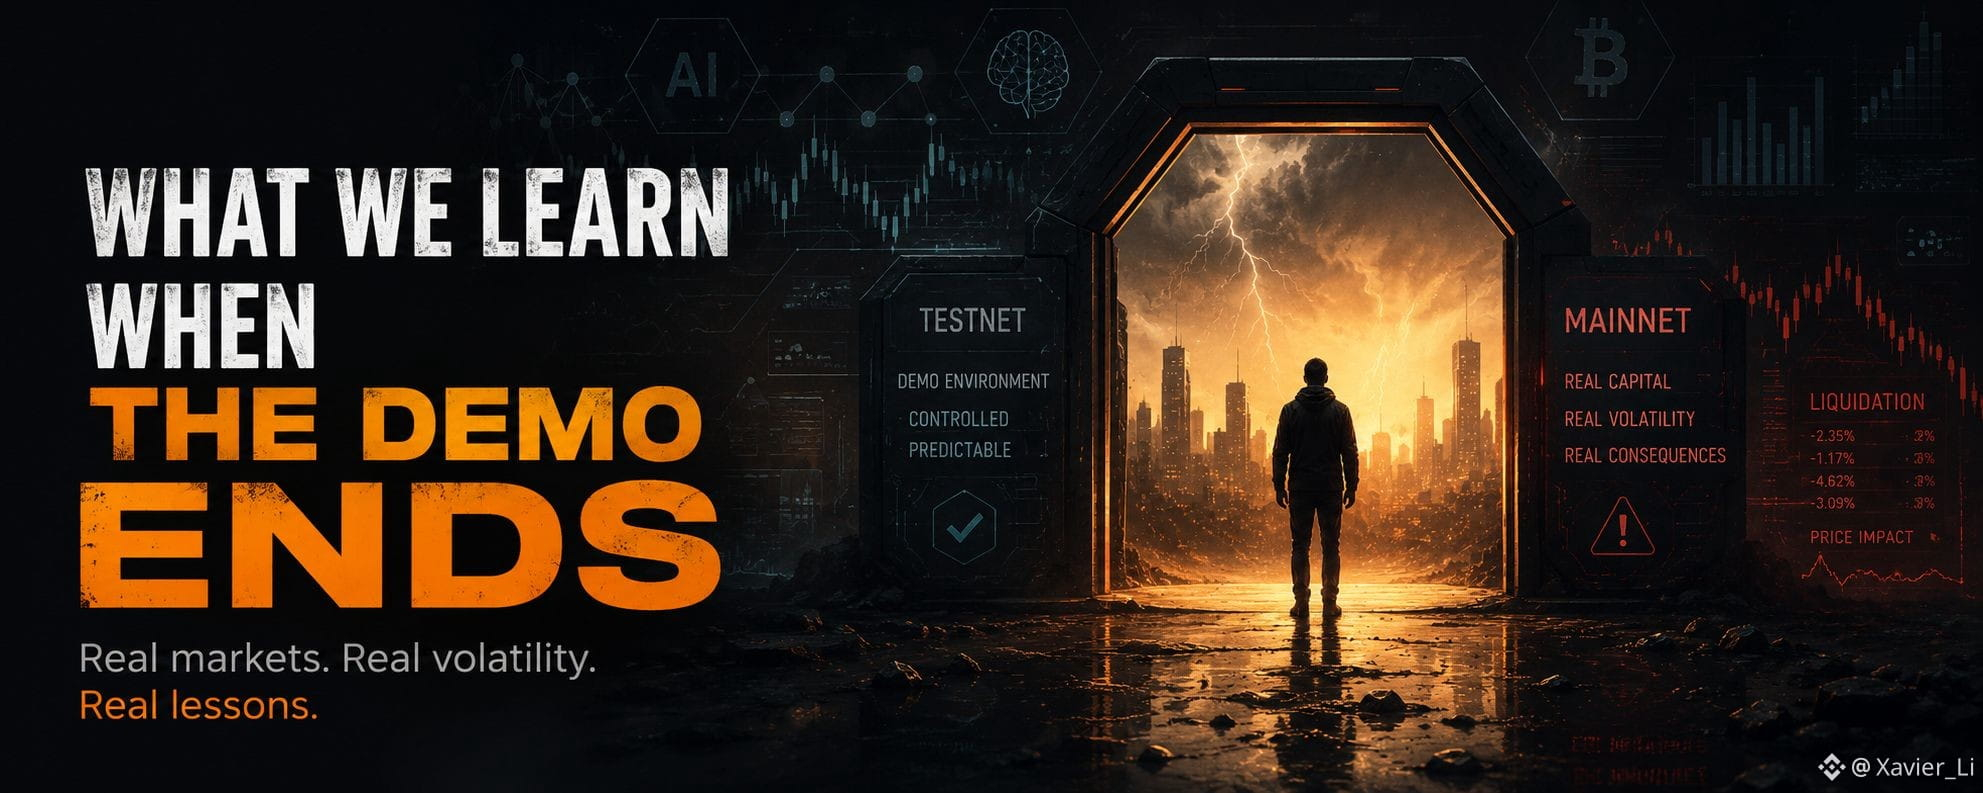
Je ne fais pas confiance aux choses qui fonctionnent parfaitement dès la première fois. Ce n’est pas exactement du cynisme. C’est plutôt de la reconnaissance de formes après avoir observé suffisamment de systèmes passer du testnet au mainnet et constater que certaines hypothèses ne survivent pas au contact avec la réalité.
Il y a un moment, généralement calme, qui survient juste après le lancement. La démo est terminée. L’environnement contrôlé a disparu. Le vrai capital commence à bouger. La vraie volatilité apparaît sans prévenir. Et, soudain, chaque décision architecturale qui semblait prudente pendant le développement est reconsidérée dans des conditions que personne n’a choisies. Ce moment arrive pour beaucoup de projets IA-crypto en ce moment, et je ne suis pas sûr que combien d’entre eux y soient réellement prêts.
J'ai réfléchi à tout cela dans le contexte des environnements d'exécution. Pas à la partie « tape-à-l'œil » : les modèles, les stratégies, les tableaux de bord affichant des rendements issus de backtests. Tout cela est facile à démontrer. Ça a belle allure dans des captures d'écran. Mais personne ne perd de l'argent pendant une capture d'écran. On le perd quand l'infrastructure en dessous ne peut pas gérer ce que le modèle essaie de faire, ou le gère d'une manière qui semblait correcte pendant les tests, mais s'effondre sous contrainte.
Le problème avec l'infrastructure d'exécution, c'est qu'elle est presque invisible quand elle fonctionne. C'est le but. Personne ne se réveille en étant reconnaissant parce que ses ordres ont bien été exécutés. Personne n'applaudit la couche de règlement. Mais quand elle tombe en panne—quand une transaction est devancée (frontrun), quand une liquidation se produit à un prix moins favorable que prévu, quand une cascade d'événements déclenche quelque chose que personne n'avait anticipé—alors, tout à coup, l'infrastructure est l'unique sujet dont tout le monde veut parler. Et à ce moment-là, il est souvent déjà trop tard.
C'est là que je me retrouve à prêter attention à ce que le protocole Newton essaie d'accomplir avec son rollup. Pas parce que je suis convaincu qu'il résout tout, mais parce que l'accent mis sur l'environnement d'exécution plutôt que sur la couche d'intelligence laisse penser que quelqu'un impliqué comprend que la partie « ennuyeuse » est en réalité là où se situe l'essentiel du risque. Une couche de règlement dédiée pour des stratégies pilotées par l'IA signifie que l'exécution se fait dans un espace défini avec des règles définies, plutôt que d'être « relâchée » sur une chaîne à usage général où n'importe quoi peut interagir avec n'importe quoi d'une manière imprévisible.
Est-ce que cela élimine le risque ? Bien sûr que non. Les stratégies peuvent toujours être mauvaises. Les agents peuvent toujours prendre de mauvaises décisions. Un comportement corrélé entre plusieurs agents peut toujours amplifier la volatilité. Mais au moins, l'infrastructure n'ajoute pas une incertitude supplémentaire par-dessus tout le reste.
Je pense aussi à la composante « place de marché », parce que c'est là que les choses deviennent vraiment compliquées. Quand les développeurs peuvent déployer des agents que n'importe qui peut utiliser, la question de la responsabilité devient presque impossible à démêler. Si j'exécute ton agent et que je perds de l'argent, est-ce ta faute pour avoir construit une stratégie défectueuse, la mienne pour avoir déployé quelque chose que je n'avais pas compris, ou la faute de l'infrastructure qui permet de le faire ? La réponse implique probablement les trois, dans des proportions que personne n'a encore déterminées. Et en l'absence d'une responsabilité claire, la couche d'infrastructure devient la seule chose qui puisse fixer des limites significatives : des limites de position, des paramètres de risque, des périmètres d'autorisations qui ne peuvent pas être élargis discrètement après le déploiement.
Ce n'est pas une solution complète au problème de la responsabilité. Mais c'est au moins un point de départ qui reconnaît que le problème existe, ce que font plus que la plupart des projets.
Ce qui me rend honnêtement méfiant, c'est que les vrais tests n'ont pas encore eu lieu. Le marché n'a pas encore lancé quoi que ce soit à ces systèmes qu'ils n'avaient pas prévu. La volatilité n'a pas encore révélé les hypothèses erronées intégrées dans l'architecture. Quand cela arrivera—et cela arrivera, parce que les marchés finissent toujours par se comporter mal—nous apprendrons des choses sur ces environnements d'exécution que personne ne peut prédire à partir d'un livre blanc ou d'une démonstration contrôlée.
Ce n'est pas une critique d'un projet en particulier. C'est simplement ainsi que fonctionne l'infrastructure. Elle gagne la confiance lentement, à force d'expositions répétées à des conditions défavorables, et pas grâce à des annonces ou des partenariats ou à de belles pages d'accueil bien conçues. La question n'est pas de savoir si un système paraît fiable le jour un. C'est de savoir s'il paraît encore fiable le jour cent, après qu'un événement inattendu soit déjà survenu.
Je n'ai pas encore la réponse pour Newton, ni pour qui que ce soit d'autre dans ce domaine. Je pense que toute personne qui prétend savoir est probablement en train de ne pas être honnête au sujet de l'incertitude que cela implique.
Ce à quoi je reviens sans cesse, c'est que ce moment—la transition silencieuse des tests contrôlés à une exploitation en conditions réelles et exposée—est celui qui compte réellement. Tout ce qui précède n'est qu'une répétition. Les performances réelles n'ont pas encore commencé.

