
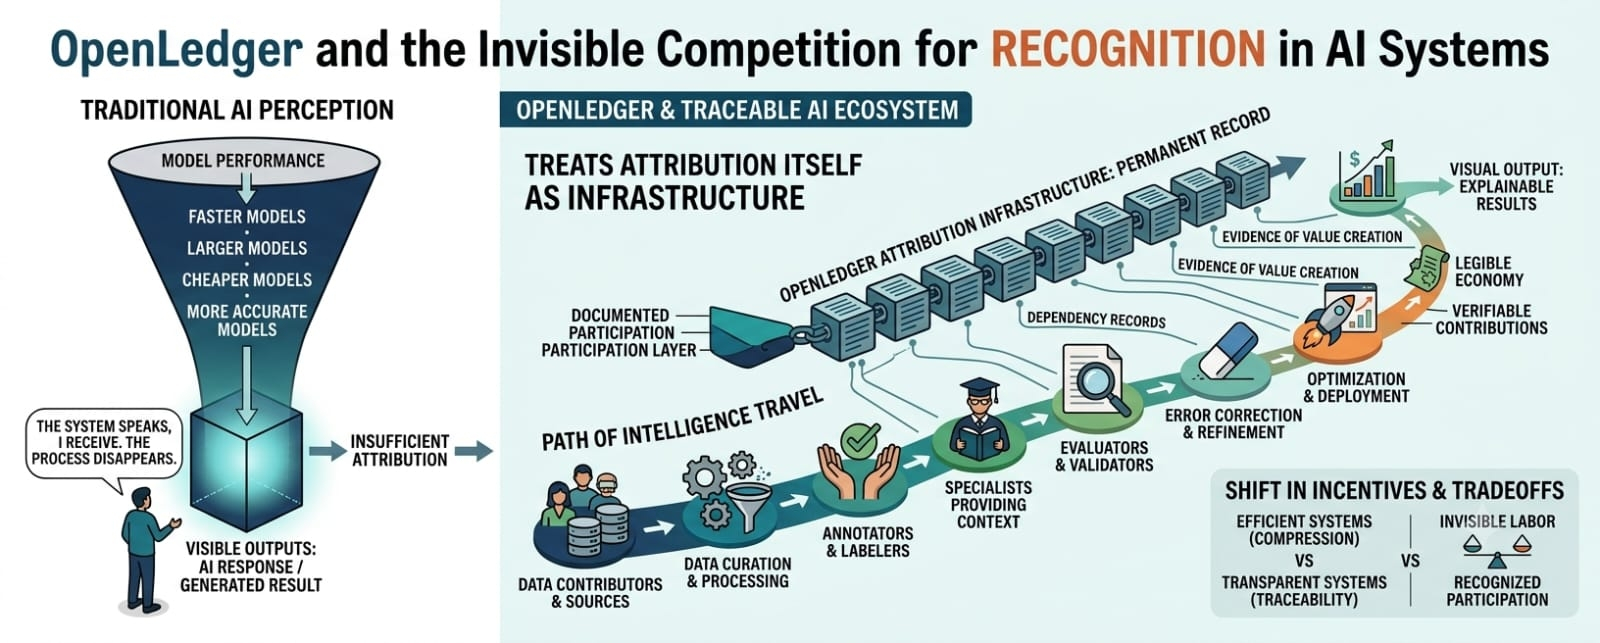
Je pensais autrefois que la plus grande compétition en IA se jouerait entre les modèles. Des modèles plus rapides, plus grands, moins chers, plus précis. Chaque conversation semblait aller dans ce sens. Chaque titre se concentrait sur la performance. Chaque benchmark célébrait une nouvelle amélioration. Mais plus je regarde cette industrie évoluer, plus je sens qu'il se passe quelque chose de bien plus important sous la surface. Je me surprends à prêter moins attention à l'intelligence produite et davantage aux conditions qui déterminent qui est reconnu pour l'avoir produite.
Je pense que l’IA a un problème de visibilité que la plupart des gens sous-estiment encore. On parle constamment des sorties, car les sorties sont faciles à observer. On voit une réponse. On voit une image. On voit une prédiction. On voit un résultat généré. Ce que l’on voit rarement, en revanche, c’est la longue chaîne de contributeurs, de décisions, d’évaluations, de validations, de corrections et de sources de données qui existaient avant que cette sortie devienne possible. La réponse finale est visible. L’historique qui l’a produite ne l’est pas.
Je trouve intéressant que la plupart des industries finissent par devenir obsédées par la traçabilité. L’industrie manufacturière veut savoir d’où proviennent les matières premières. La finance veut savoir d’où proviennent les transactions. Les systèmes alimentaires veulent savoir d’où viennent les ingrédients. La santé veut savoir comment les décisions ont été prises. Pourtant, l’IA se comporte souvent comme si la sortie finale suffisait à prouver la création de valeur. Le système parle. L’utilisateur reçoit. Le processus disparaît.
Je me demande sans cesse si cette hypothèse peut survivre à la prochaine étape du développement de l’IA. Plus l’activité économique à laquelle l’IA influence augmente, plus les gens poseront des questions sur les origines. D’où vient cette information ? Qui a contribué à sa création ? Qui a vérifié son exactitude ? Qui devrait recevoir le crédit si la sortie devient précieuse ? Ces questions semblent simples jusqu’au moment où l’on réalise que les systèmes d’IA modernes reposent sur d’immenses couches de participation cachée.
Je pense que OpenLedger devient intéressant précisément parce qu’il déplace l’attention vers cette couche de participation cachée. Pas parce que cela résout magiquement l’attribution. Pas parce que cela garantit l’équité. Pas parce que cela supprime la complexité. Ce qui attire mon attention, c’est que cela traite l’attribution elle-même comme une infrastructure. Cela ressemble à une perspective fondamentalement différente de nombreux projets d’IA qui se concentrent presque entièrement sur les performances du modèle.
Je remarque qu’à partir du moment où l’attribution devient importante, toute la conversation change. Le défi n’est plus simplement de générer de l’intelligence. Le défi devient de documenter le parcours que l’intelligence a suivi avant d’atteindre un utilisateur. Chaque contributeur fait alors partie d’une chaîne plus vaste. Chaque ensemble de données devient une dépendance. Chaque processus de validation devient une preuve. Chaque correction devient une partie d’un registre historique qui peut influencer de futures récompenses.
Je pense que cela crée un changement d’incitations inhabituel. Les gens supposent souvent que la création de valeur et la reconnaissance de la valeur sont la même chose. Ce n’est pas le cas. Une personne peut créer une valeur immense tout en restant invisible. Une autre peut créer moins de valeur, mais occuper une position plus facile à vérifier. La visibilité et la contribution évoluent souvent dans des directions différentes. Cette réalité existe dans presque toutes les industries, mais l’IA peut l’amplifier, car une grande partie du processus de production se déroule dans l’ombre.
Je me surprends à penser à combien de contributions utiles disparaissent avant même que des systèmes de reconnaissance ne les rencontrent. Des chercheurs abandonnent des idées prometteuses. Des annotateurs améliorent des ensembles de données par petites touches, mais de manière significative. Des membres de la communauté identifient des faiblesses. Des spécialistes apportent du contexte. Des évaluateurs détectent des erreurs. La plupart de ces contributions ne deviennent que rarement visibles pour les utilisateurs finaux. Pourtant, sans elles, beaucoup de systèmes d’IA fonctionneraient dramatiquement moins bien. Leur importance existe même lorsque leur reconnaissance n’existe pas.
Je pense que c’est là que l’idée de chaînes d’approvisionnement en IA devient de plus en plus pertinente. L’intelligence ne jaillit pas du néant. Elle traverse plusieurs couches avant d’atteindre quelqu’un. La collecte des données, la vérification, l’organisation, le traitement, l’évaluation, l’optimisation, le déploiement, la surveillance et le retour d’information influencent tous le résultat final. Ce que vivent les utilisateurs est souvent le point d’aboutissement d’un voyage bien plus vaste.
Je remarque que les chaînes d’approvisionnement créent une étrange illusion psychologique. Les gens se concentrent naturellement sur l’objet qu’ils peuvent voir. Un consommateur voit un produit en rayon. Il ne voit pas toutes les usines, tous les fournisseurs, toutes les routes de transport, tous les processus d’inspection, ni toutes les dépendances logistiques qui ont rendu ce produit possible. L’IA semble développer une structure similaire. Les utilisateurs interagissent avec des réponses tout en restant déconnectés du réseau de participants qui ont produit ces réponses.
Je pense que OpenLedger explore un avenir où ce décalage devient plus difficile à ignorer. Si l’attribution devient économiquement significative, alors les participants auront de plus en plus intérêt à se concurrencer pour s’assurer que leurs contributions restent visibles tout au long du processus de production. La reconnaissance devient une partie de l’infrastructure. La lisibilité devient une partie de l’économie. La documentation devient une partie de la création de valeur elle-même.
Je reviens sans cesse à une question qui met mal à l’aise. Que se passe-t-il lorsque des systèmes ne peuvent récompenser que ce qu’ils peuvent vérifier ? À un premier niveau, cela paraît raisonnable. La vérification crée la confiance. Les preuves créent la responsabilité. Les registres créent la cohérence. Mais la vérification crée aussi des frontières. Tout ce qui se trouve en dehors de ces frontières devient difficile à reconnaître. Des contributions précieuses peuvent exister au-delà des limites de ce que le système peut observer.
Je pense que chaque système d’infrastructure fait face à cette tension. La simplicité exige une compression. Les registres exigent une standardisation. Les preuves exigent une structure. Or, la réalité est rarement suffisamment structurée pour s’insérer proprement dans ces exigences. Le moment où un système décide ce qui compte comme preuve, il décide aussi ce qui restera invisible. Ce compromis semble inévitable.
Je remarque que beaucoup de discussions sur la décentralisation portent sur la propriété. Moins de discussions portent sur la reconnaissance. La propriété compte, mais la reconnaissance pourrait devenir tout aussi importante dans les écosystèmes d’IA. Un participant ne peut pas tirer bénéfice d’une contribution que personne ne peut identifier. Une contribution ne peut pas entrer dans un système économique si le système ne dispose pas de mécanismes pour l’observer. La visibilité devient alors une condition préalable à la participation.
Je pense que c’est pour cela que l’attribution semble plus grande qu’un simple problème technique. C’est aussi un problème économique, un problème de gouvernance et un problème social. Chaque système d’attribution répond implicitement à des questions du type : dont le travail compte, quelles preuves pèsent, et quelles contributions méritent de persister dans des registres historiques. Ces choix façonnent les incitations bien avant que les récompenses ne soient distribuées.
Je trouve fascinant que l’IA puisse, à terme, forcer la société à réfléchir plus attentivement au travail invisible. Pendant des années, une grande partie du débat a porté sur l’automatisation remplaçant le travail humain. Mais un autre défi émerge. Les contributions humaines existent de plus en plus à l’intérieur de systèmes qui en masquent l’origine. La question n’est peut-être pas seulement de savoir si les personnes sont remplacées. La question pourrait aussi être de savoir si les personnes restent visibles.
Je pense que l’avenir de l’infrastructure IA impliquera une lutte croissante entre efficacité et transparence. Les systèmes efficaces veulent de la compression. Les systèmes transparents veulent de la traçabilité. Les systèmes efficaces veulent de l’abstraction. Les systèmes transparents veulent du détail. Aucun de ces objectifs n’est mauvais. Le défi consiste à déterminer jusqu’à quel point la visibilité peut être préservée sans sacrifier l’utilisabilité.
Je remarque que la confiance dépend souvent moins de l’intelligence que les gens ne le pensent. Un système très intelligent peut encore générer du scepticisme si personne ne comprend d’où proviennent ses conclusions. Pendant ce temps, un système moins performant peut inspirer confiance si son processus reste observable. Les humains se sont toujours intéressés aux explications, à la responsabilité et à la provenance. L’IA n’élimine pas ces préoccupations. À bien des égards, elle les amplifie.
Je pense que OpenLedger mérite d’être surveillé car il encourage une conversation différente au sujet de l’IA. Au lieu de demander uniquement comment l’intelligence est produite, il demande comment la participation est enregistrée. Au lieu de se concentrer exclusivement sur les sorties, il se concentre sur la chaîne de dépendances derrière ces sorties. Au lieu de considérer l’attribution comme une simple réflexion après coup, il explore ce qui se passe lorsque l’attribution fait partie de la base.
Je continue de penser que la transformation la plus importante en IA ne concerne peut-être pas l’intelligence elle-même. L’intelligence continuera de s’améliorer. Les modèles continueront de progresser. Les capacités continueront de s’étendre. Mais la question plus profonde pourrait tourner autour de la visibilité. Qui est reconnu ? Qui est mémorisé ? Qui devient partie du registre permanent dont les systèmes futurs dépendront ?
Je pense que la prochaine étape de l’IA pourrait être définie par cette question plus que beaucoup de gens ne le réalisent. Pas parce que l’intelligence cesse d’avoir de l’importance, mais parce que l’intelligence seule ne peut pas expliquer d’où provient la valeur. À mesure que les systèmes d’IA deviennent plus influents, la capacité de retracer les contributions pourrait devenir aussi importante que la capacité de générer des sorties. L’avenir n’appartiendra peut-être pas seulement aux systèmes qui créent l’intelligence, mais aussi à ceux qui révèlent comment l’intelligence a été créée, tout d’abord.
