
Hier soir, en tweakant un ancien projet de pipeline d'entraînement, j'ai coupé le mode surlignage de l'IDE, ne laissant que les logs qui dansaient sur l'écran et les courbes d'appels du testnet. Ce moment de calme, légèrement fatigué, rend plus facile la compréhension de l'écosystème AI actuel. Le modèle des grandes entreprises ressemble de plus en plus à une usine centralisée hautement intégrée : d'innombrables développeurs envoient discrètement leur puissance de calcul, leurs données annotées et leurs itérations d'expérimentation, mais les bénéfices des modèles finaux sont fermement contrôlés par quelques acteurs. Cela me rappelle les débuts de l'écosystème Ethereum, où certaines applications précoces appelaient de manière invisible la liquidité et la contribution des données des utilisateurs, cette sensation de boucle familière resurgit encore une fois.
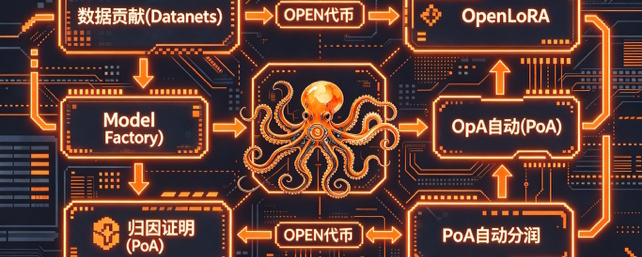
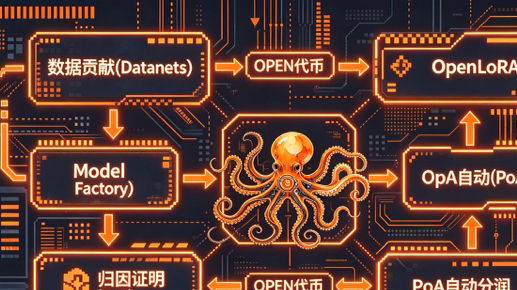
Récemment, le mécanisme de preuve d'attribution qu'OpenLedger essaie de construire, @OpenLedger m'a donné, en tant que personne qui a longtemps évolué dans le domaine de la décentralisation, quelques raisons de m'y intéresser. Ils utilisent des modèles mathématiques pour quantifier la véritable contribution de chaque donnée d'entraînement à la sortie finale du modèle, et tentent de transformer ces contributions en actifs vérifiables et liquides sur la chaîne. Cette approche de véritable assetisation des données a une sincérité technique, surtout lorsqu'elle est associée à OpenLoRA, un design modulaire soutenant le partage de matériel entre plusieurs modèles, permettant aux développeurs de ne pas avoir à reconstruire l'ensemble de l'environnement à chaque fois, réduisant ainsi considérablement les barrières d'entrée.
Cependant, mon expérience au fil des ans m'a appris que même les architectures les plus avant-gardistes ne peuvent échapper à la cohérence du cycle économique. $OPEN La pression d'offre résultant de la libération progressive des parts initiales est objectivement présente. Si l'écosystème ne dispose pas de suffisamment de scénarios d'affaires réels incitant les développeurs à consommer ou à staker des tokens pour se couvrir, il est difficile qu'un simple engouement conceptuel soutienne la liquidité sur le long terme. J'ai moi-même trébuché dans plusieurs projets similaires dans le passé, donc maintenant, ma première réaction face à tout est de vérifier ses données d'appels réels et la profondeur de l'attachement des tokens, plutôt que de simplement écouter les nouvelles de partenariat en surface. $BTC
Au cours des deux dernières semaines, j'ai effectué plusieurs expériences sur le réseau de test, et la sensation réelle de l'architecture modulaire est vraiment agréable. Tu peux décomposer la contribution des données, l'affinage des modèles et les services d'inférence en blocs Lego relativement indépendants, à assembler au besoin, sans être freiné par des conflits de mémoire ou la gestion des versions comme auparavant. Cette flexibilité d'OpenLedger me permet de concentrer plus d'énergie sur l'efficacité des modèles eux-mêmes, plutôt que sur la maintenance fastidieuse de l'infrastructure. Bien sûr, une baisse des barrières d'entrée signifie aussi qu'il faut un mécanisme économique plus robuste pour filtrer le bruit de faible qualité, sinon à long terme cela pourrait diluer l'intensité du signal de l'écosystème, et je suis encore en train d'observer cela.
Je prends maintenant le temps chaque jour de jeter un œil à la courbe de staking et à la fréquence d'appels du réseau de test, tout comme je surveillais autrefois les indicateurs de latence de mes services, c'est devenu une habitude. #OpenLedger Ce système, sur le plan technique, m'a laissé une impression solide. Il a effectivement saisi les deux vieux points sensibles que sont la certification des données et le partage du matériel, et l'approche modulaire semble offrir un potentiel d'évolutivité. Mais mon attitude à son égard reste prudente et optimiste, après avoir essuyé quelques pertes. Une fois le mainnet lancé, la véritable clé du succès dépendra de la volonté des développeurs à continuer à dépenser des tokens pour des ensembles de données et des appels de modèles de haute qualité, et non pas à rester uniquement dans la phase d'incitation initiale.
Dans l'ensemble, la direction d'OpenLedger est louable, et l'expérience pratique du projet a dépassé mes attentes initiales plutôt conservatrices. Mais pour savoir si le projet pourra vraiment fonctionner, il faudra du temps et un véritable volume d'affaires pour le valider. À ce stade, j'ai choisi de continuer des tests à petite échelle, de rester lucide et d'éviter l'imprudence. C'est probablement la manière la plus instinctive de me protéger, en tant que développeur éduqué par le marché.