

24 mai 2026
Il y a quelques mois, j'ai remarqué quelque chose de bizarre en testant différents agents IA connectés à des outils crypto. Les agents eux-mêmes n'étaient pas le problème principal. La plupart pouvaient résumer des données, déclencher des transactions ou coordonner des flux de travail simples assez bien. Le véritable problème se situait un niveau plus profond. Personne ne pouvait expliquer pourquoi un utilisateur devrait faire confiance aux résultats une fois que les incitations devenaient adversariales. La conversation autour de l'infrastructure IA semble encore fortement axée sur les capacités tout en ignorant la vérification. En termes crypto, ça me rappelle la période DeFi initiale où tout le monde optimisait la composabilité avant de comprendre à quel point les systèmes d'incitations peuvent devenir fragiles sous pression.
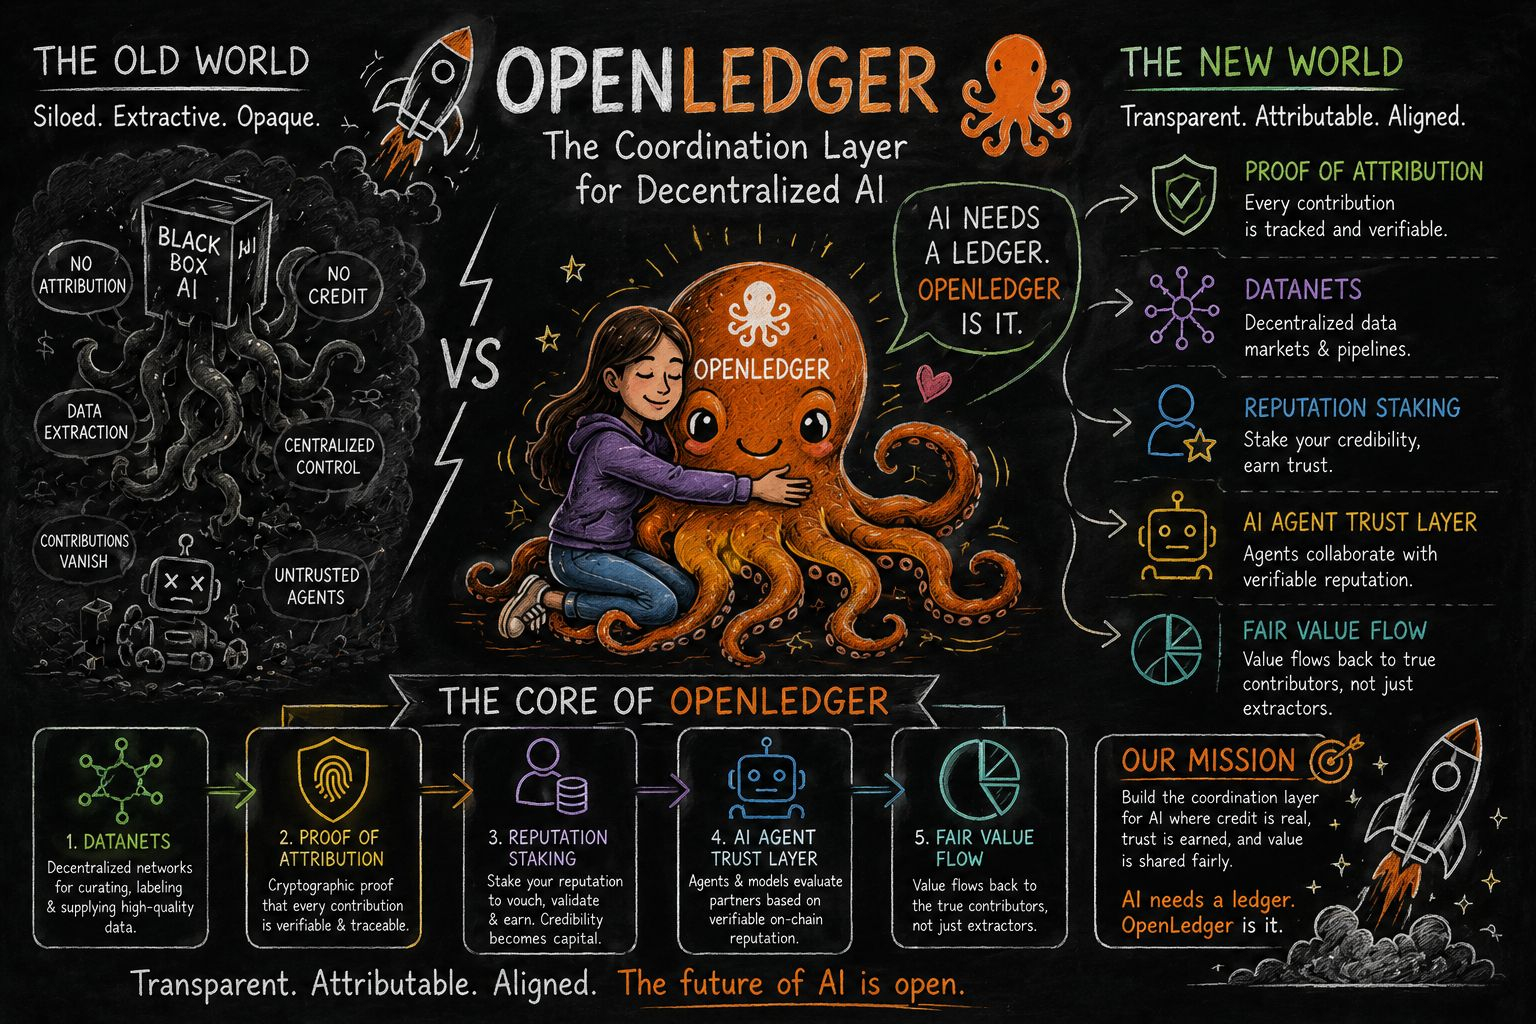
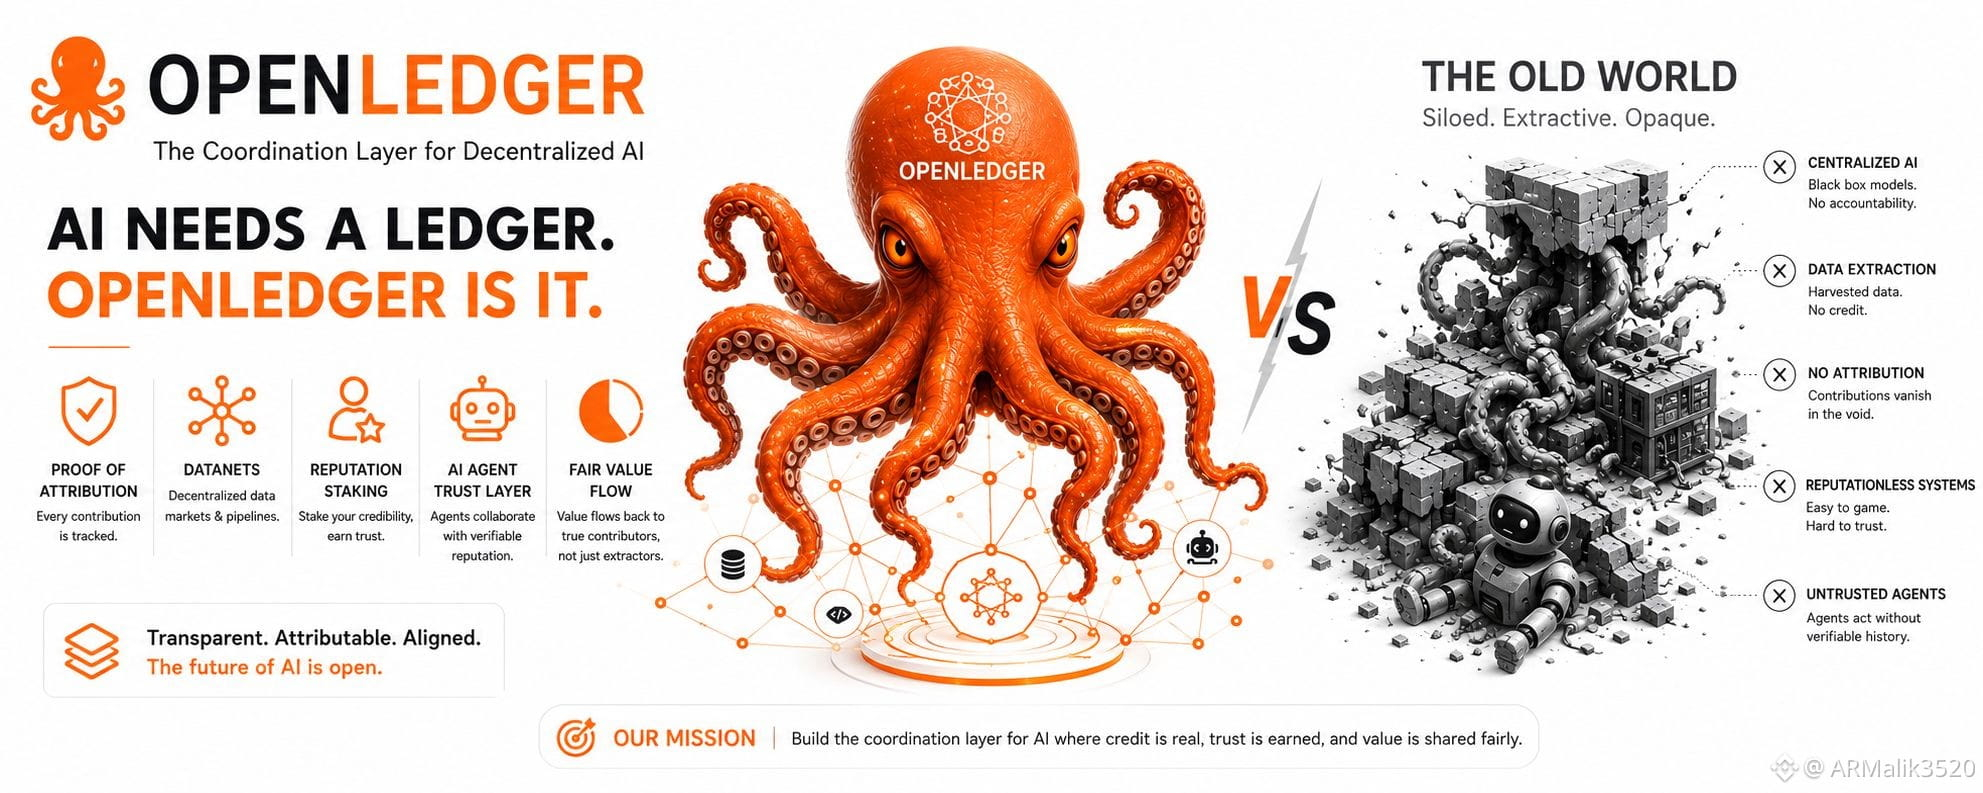
C’est en partie pour cela qu’OpenLedger est devenu plus intéressant à suivre récemment. Non pas parce qu’il promet un futur parfait d’IA décentralisée, mais parce qu’il semble aborder l’IA comme un problème de coordination plutôt que comme un simple problème de calcul. Je pense que cette distinction compte davantage que ce que les gens réalisent. La plupart des systèmes d’IA dépendent aujourd’hui de travail invisible et de pipelines de données invérifiables. Les modèles absorbent de l’information provenant de contributeurs, d’API, de forums, de jeux de données et de boucles de rétroaction humaines, pourtant l’attribution disparaît souvent quelque part entre l’ingestion et la génération de sorties. Économiquement, cela crée un déséquilibre étrange. Les entités qui extraient le plus de valeur sont souvent celles qui sont le moins redevables de l’origine réelle de l’intelligence.
Historiquement, l’infrastructure crypto essaie de résoudre la confiance par la transparence et l’alignement économique. Mais l’IA introduit une version plus difficile du problème, car l’intelligence elle-même est probabiliste. Vous ne faites plus que vérifier un solde ou confirmer un hash de bloc. Vous évaluez si la sortie d’un modèle mérite d’être considérée comme crédible. C’est beaucoup plus difficile à tarifer. Les expérimentations d’OpenLedger autour des datanets et de la Proof of Attribution semblent viser directement cette tension. L’idée sous-jacente paraît simple en surface : suivre les flux de contribution afin que la valeur et la réputation puissent être reliées aux participants qui ont façonné le système. Mais, structurellement, cela crée des implications de second ordre qui vont bien au-delà de la distribution des récompenses.
Si l’attribution devient fiable, alors l’infrastructure IA cesse de se comporter comme une boîte noire et commence à se comporter davantage comme un réseau économique. Soudain, les fournisseurs de données, les concepteurs de modèles, les validateurs et les agents fonctionnent tous au sein de boucles d’incitations visibles. Cela change le comportement des participants. Les contributeurs deviennent plus sélectifs quant à la qualité, parce que la réputation devient « cessible » sous forme d’enjeu. Les développeurs deviennent plus prudents face à la manipulation des sorties, car les traces d’attribution créent une pression de responsabilité. Même la gouvernance change, car le système peut théoriquement distinguer les contributeurs réellement significatifs des spéculateurs passifs.
Au moins en théorie.
La partie difficile, c’est que les systèmes d’attribution eux-mêmes peuvent devenir des cibles de manipulation. Une fois que la réputation a une valeur économique, les gens vont inévitablement optimiser pour les indicateurs plutôt que pour la vérité. La crypto a déjà des années d’expérience avec cette dynamique. Le liquidity mining a produit du capital mercenaire. L’agriculture d’engagement social a faussé les marchés de l’attention. Les systèmes de gouvernance sont souvent devenus dominés par la concentration du capital plutôt que par l’expertise. Les réseaux d’IA hériteront probablement de distorsions similaires, sauf que la manipulation se fait désormais via la qualité des données, des interactions synthétiques, l’empoisonnement coordonné des modèles ou le « reputation gaming ».
C’est, je pense, là que beaucoup de discussions optimistes sur l’infrastructure IA deviennent trop simplistes. Mettre à l’échelle des systèmes de coordination ne concerne pas seulement le débit ou la décentralisation. Il s’agit de maintenir la qualité du signal pendant que les incitations deviennent de plus en plus « financières ». Sous la pression, la plupart des systèmes dérivent vers des comportements d’extraction à faible coût, sauf s’il existe des pénalités significatives pour dégrader la confiance. Le défi d’OpenLedger n’est pas seulement d’attirer des contributeurs. Il s’agit de créer des conditions où une participation honnête reste rationnelle d’un point de vue économique, même lorsque des stratégies adverses deviennent rentables à court terme.
Le point intéressant, c’est que les agents d’IA peuvent amplifier ce problème de façon spectaculaire. Une fois que des agents commencent à interagir de manière autonome entre les marchés, les API et les systèmes décentralisés, la confiance ne peut plus reposer uniquement sur la reconnaissance de marque ou la réputation institutionnelle. Les agents auront besoin de couches de crédibilité lisibles par machine. Ils auront besoin de moyens d’évaluer si un ensemble de données a été manipulé, si un contributeur a historiquement produit des sorties fiables, ou si un autre agent est incité économiquement à les tromper. Dans cet environnement, l’attribution cesse d’être une fonctionnalité sociale et devient une infrastructure.
Mais les expérimentations d’infrastructure n’évoluent presque jamais de façon propre. L’histoire de la crypto est pleine de systèmes qui fonctionnaient avec élégance à petite échelle avant de s’effondrer sous une pression économique réelle. Les échecs de coordination apparaissent généralement graduellement, puis d’un coup. Je soupçonne que les réseaux d’IA connaîtront des cycles similaires. Certains marchés de contribution deviendront bruyants. Certains systèmes de réputation seront sybilés. Certaines couches de gouvernance dériveront vers la plutocratie malgré de bonnes intentions. OpenLedger finira peut-être par rencontrer toutes ces pressions.
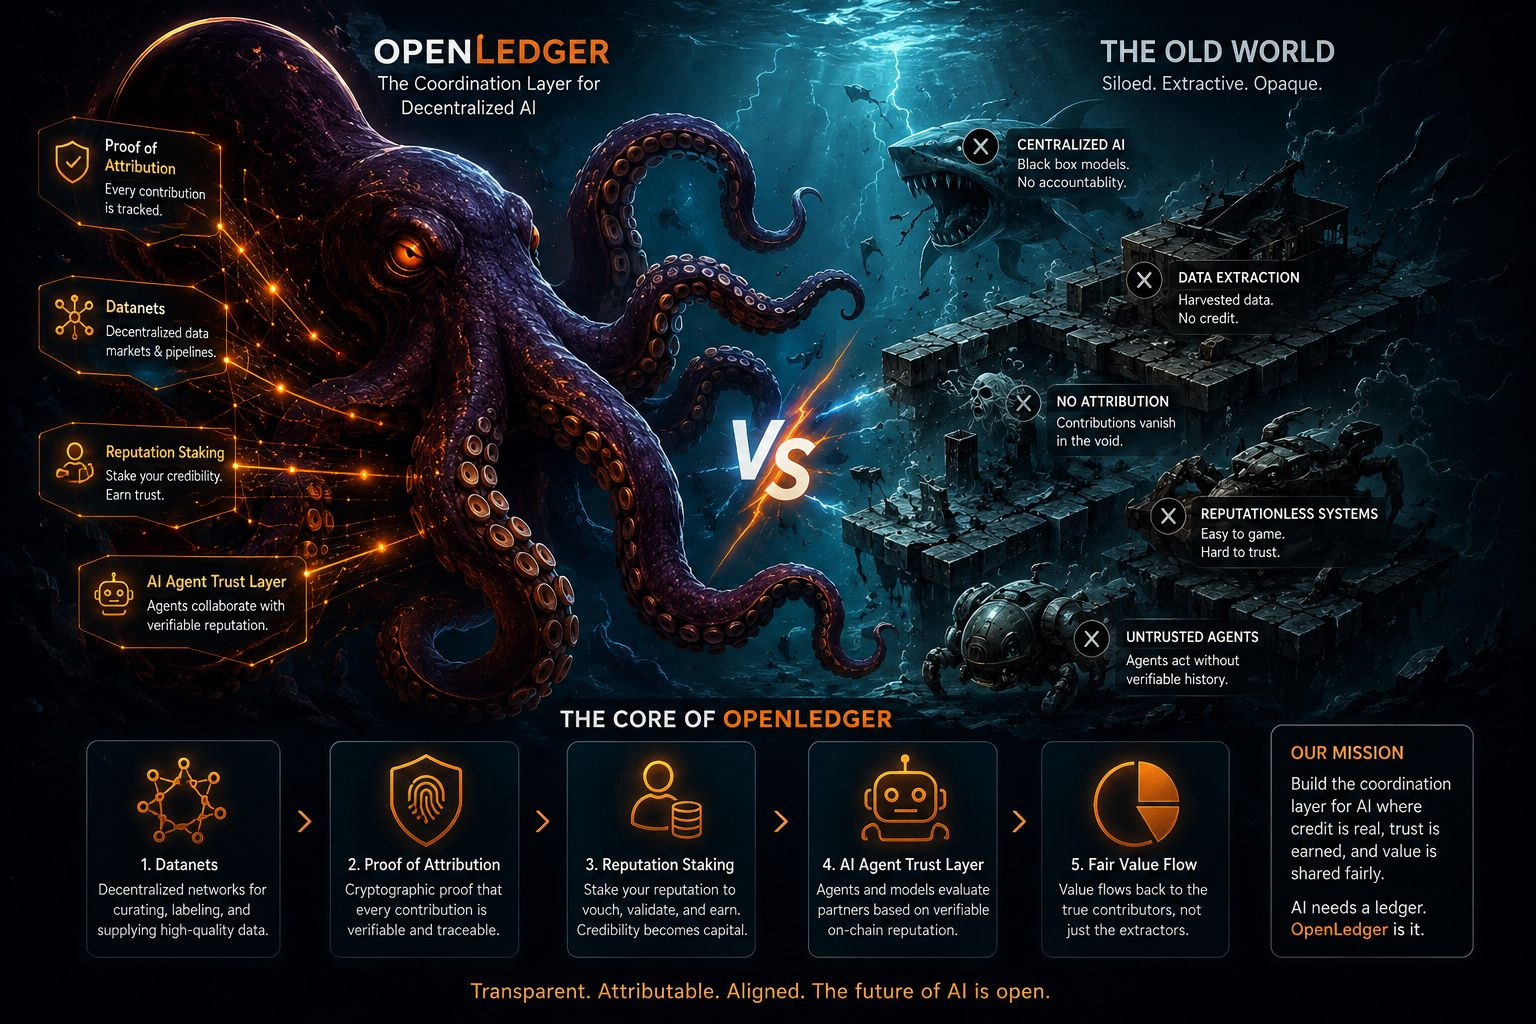
Pour autant, je pense que la direction plus large vaut la peine qu’on s’y attarde, car elle reframe l’IA, non plus comme une simple course à l’intelligence, mais comme un problème d’architecture de confiance. Les gagnants à long terme de l’infrastructure IA ne seront peut-être pas les systèmes dotés des modèles les plus puissants. Ils pourraient plutôt être ceux qui alignent le plus efficacement les incitations entre contributeurs, agents et utilisateurs, sans sombrer dans l’extraction ou la manipulation. C’est un problème bien plus ardu que de générer des sorties, et probablement un problème plus important.
La prise de conscience la plus profonde, pour moi, c’est que l’IA décentralisée dépendra peut-être finalement moins de qui possède les modèles que de qui peut maintenir une coordination crédible à grande échelle. Je ne suis pas sûr que l’industrie comprenne déjà pleinement cette distinction.$OPEN $ONDO
