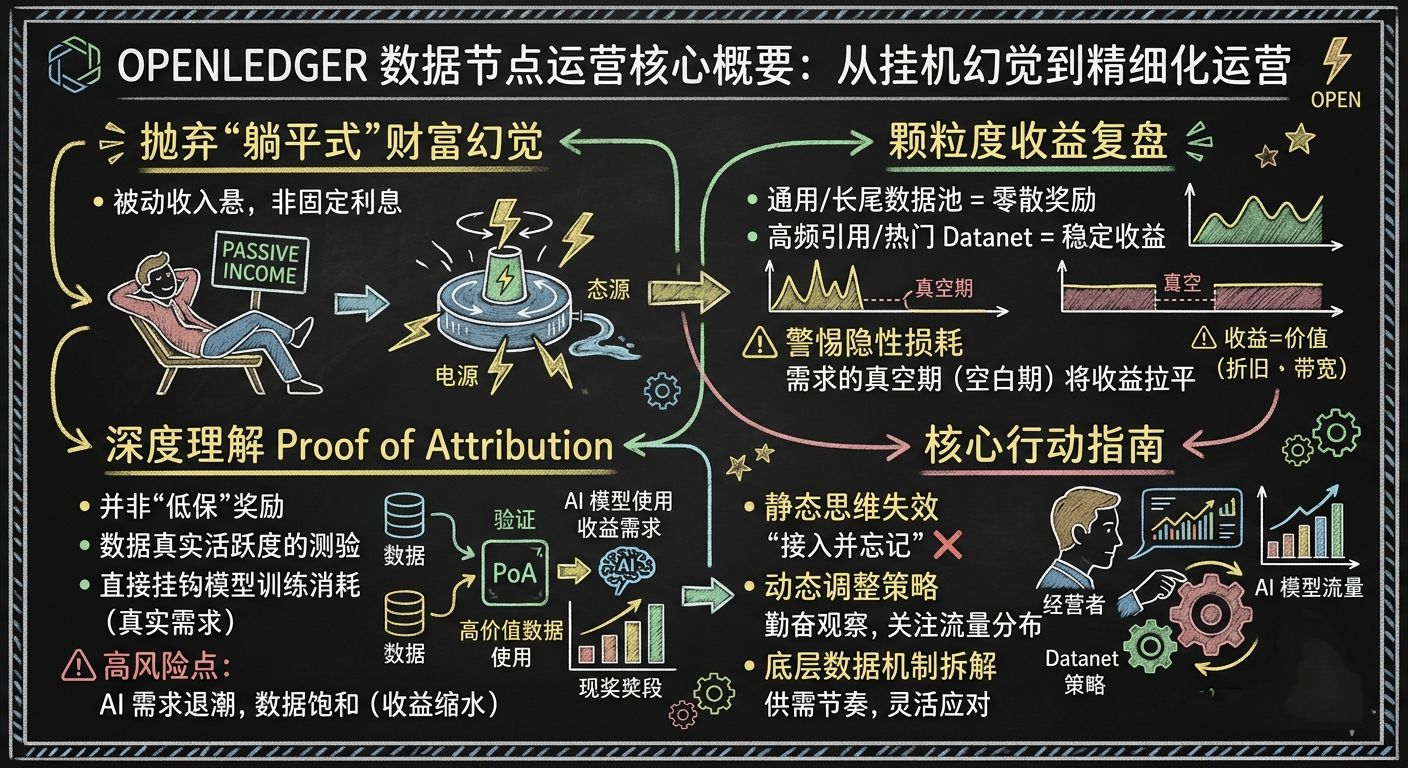
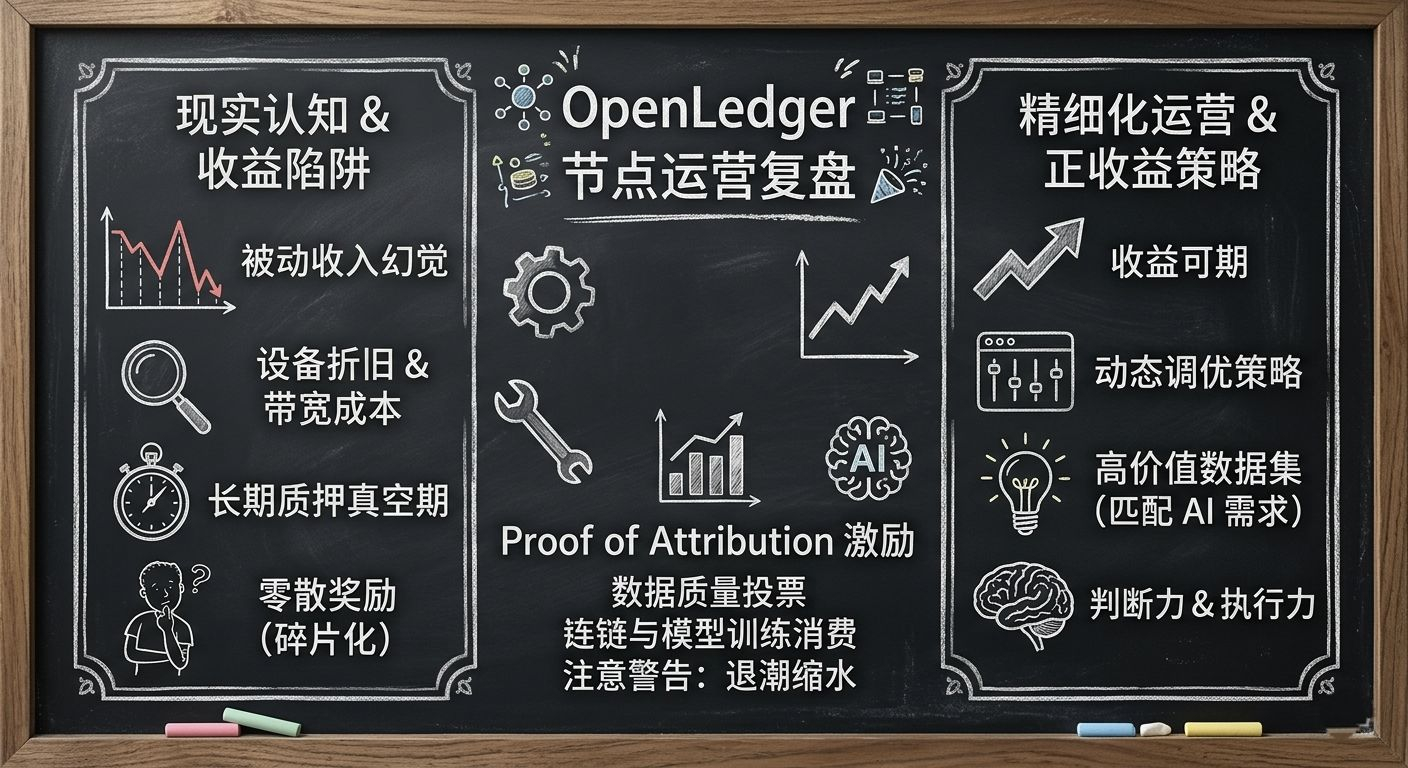
Récemment, j'ai encore ajouté quelques machines dans l'écosystème de @OpenLedger et j'ai fait une revue approfondie des rendements granulaire de Datanet durant cette période. Mon état d'esprit est devenu beaucoup plus stable par rapport à mes débuts. Beaucoup de gens simplifient à l'extrême les nœuds de données AI, pensant qu'il suffit de brancher la machine et que le $OPEN dans le compte va croître automatiquement. Cette illusion de richesse passive est en réalité un rêve éveillé pour de nombreux nouveaux entrants.
En feuilletant les anciens enregistrements d'interaction, j'ai réalisé qu'en cherchant simplement à augmenter le temps de fonctionnement, beaucoup se connectent à ces pools de données de longue traîne et peu populaires. Les récompenses fragmentées qu'ils génèrent, une fois les coûts d'électricité et de réseau déduits, montrent un ROI presque choquant. Beaucoup ont été emportés par les attentes de l'airdrop, négligeant que ces données de faible qualité n'ont en réalité aucun pouvoir de négociation dans le contexte de l'entraînement AI. Au mieux, elles contribuent à une charge inutile pour le protocole. Pour établir un modèle de profit durable dans OpenLedger, la clé réside dans la compréhension de l'actif de données. Vous devez réaliser que les nœuds ne sont pas seulement des terminaux physiques, mais aussi des portails de données nécessitant des ajustements dynamiques. J'ai constaté que les nœuds qui génèrent des revenus de manière stable correspondent tous, sans exception, aux besoins d'entraînement des modèles dominants actuels de Datanet. Il existe un énorme fossé cognitif : la plupart des gens ne regardent que l'APY actuel, ignorant que la demande de puissance de calcul pour l'entraînement AI fluctue par paliers. Si vous n'avez pas prévu une mise en cache des données avant les pics de demande, alors votre bande passante et votre capacité de stockage sont en réalité en rotation inutile la plupart du temps.
Parlons maintenant du mécanisme d'incitation très en vue #OpenLedger . Après une longue période d'observation, j'ai pris conscience que la distribution des revenus est essentiellement le prix instantané que l'écosystème attribue aux ensembles de données à forte valeur. Si vos données ne touchent pas directement les chemins clés de l'ajustement des gros modèles ou de l'amélioration des recherches génératives, peu importe combien de temps votre nœud est en ligne, le mécanisme de récompense filtrera cela par le poids algorithmique.
Pour être clair, dans la course de $OPEN , les stratégies de configuration statiques sont complètement obsolètes. L'espace de profit futur n'appartient qu'à ceux qui considèrent vraiment les nœuds comme des usines de données à gérer de manière précise. N'oubliez pas, ce que récompense OpenLedger, ce n'est jamais le temps de fonctionnement de votre équipement, mais votre discernement et votre capacité d'exécution en tant que fournisseur de données face à cette vague de transformation AI.
En feuilletant les anciens enregistrements d'interaction, j'ai réalisé qu'en cherchant simplement à augmenter le temps de fonctionnement, beaucoup se connectent à ces pools de données de longue traîne et peu populaires. Les récompenses fragmentées qu'ils génèrent, une fois les coûts d'électricité et de réseau déduits, montrent un ROI presque choquant. Beaucoup ont été emportés par les attentes de l'airdrop, négligeant que ces données de faible qualité n'ont en réalité aucun pouvoir de négociation dans le contexte de l'entraînement AI. Au mieux, elles contribuent à une charge inutile pour le protocole. Pour établir un modèle de profit durable dans OpenLedger, la clé réside dans la compréhension de l'actif de données. Vous devez réaliser que les nœuds ne sont pas seulement des terminaux physiques, mais aussi des portails de données nécessitant des ajustements dynamiques. J'ai constaté que les nœuds qui génèrent des revenus de manière stable correspondent tous, sans exception, aux besoins d'entraînement des modèles dominants actuels de Datanet. Il existe un énorme fossé cognitif : la plupart des gens ne regardent que l'APY actuel, ignorant que la demande de puissance de calcul pour l'entraînement AI fluctue par paliers. Si vous n'avez pas prévu une mise en cache des données avant les pics de demande, alors votre bande passante et votre capacité de stockage sont en réalité en rotation inutile la plupart du temps.
Parlons maintenant du mécanisme d'incitation très en vue #OpenLedger . Après une longue période d'observation, j'ai pris conscience que la distribution des revenus est essentiellement le prix instantané que l'écosystème attribue aux ensembles de données à forte valeur. Si vos données ne touchent pas directement les chemins clés de l'ajustement des gros modèles ou de l'amélioration des recherches génératives, peu importe combien de temps votre nœud est en ligne, le mécanisme de récompense filtrera cela par le poids algorithmique.
Pour être clair, dans la course de $OPEN , les stratégies de configuration statiques sont complètement obsolètes. L'espace de profit futur n'appartient qu'à ceux qui considèrent vraiment les nœuds comme des usines de données à gérer de manière précise. N'oubliez pas, ce que récompense OpenLedger, ce n'est jamais le temps de fonctionnement de votre équipement, mais votre discernement et votre capacité d'exécution en tant que fournisseur de données face à cette vague de transformation AI.