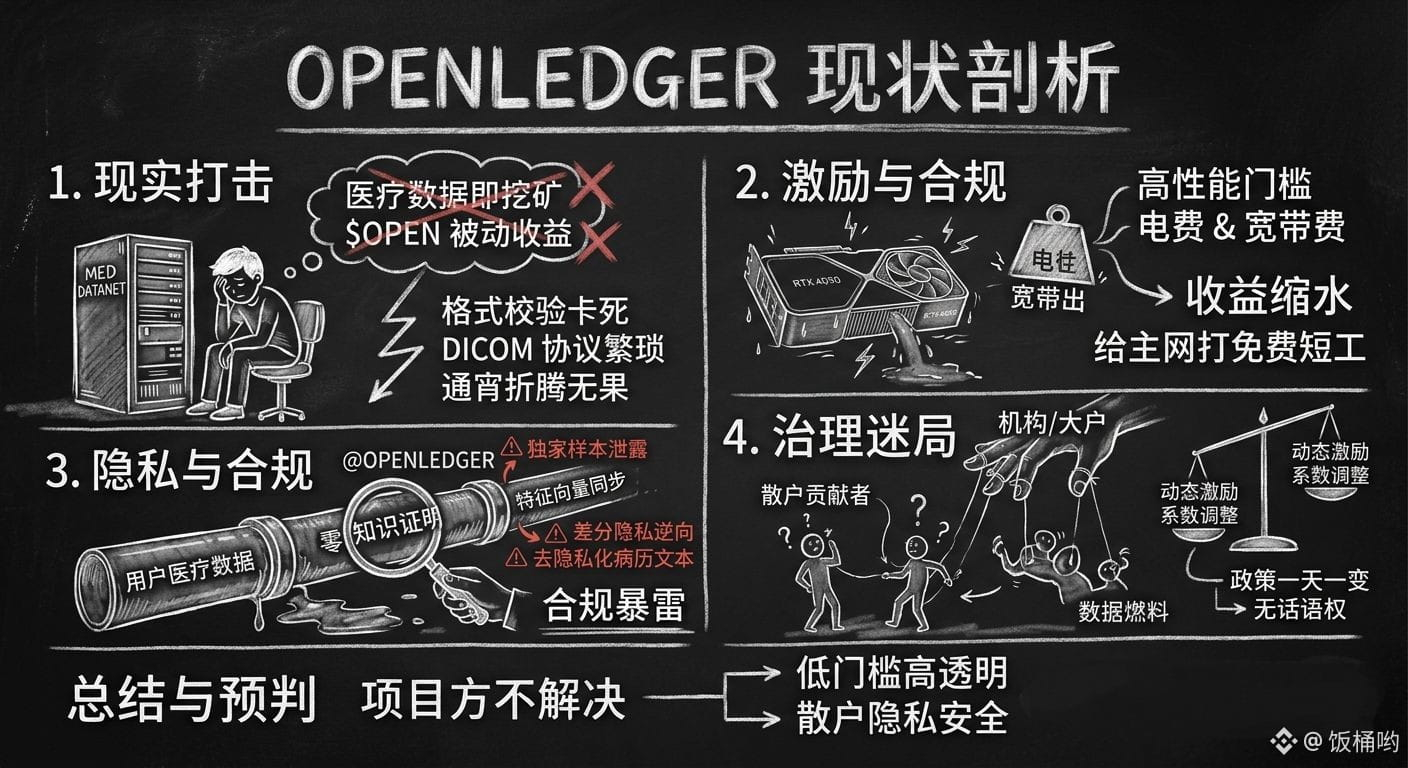
Il y a deux jours, j'ai vu tout le monde parler de la plateforme d'annotation d'images médicales AI @OpenLedger sur la place. Sur un coup de tête, j'ai transféré le jeu de données de coupes de pathologie cutanée que mon studio avait accumulé sur Med DataNet. Au final, j'ai passé toute la nuit à essayer de régler le problème de validation de format, coincé par cette suite d'accords DICOM compliqués et la logique d'alignement des étiquettes, presque au bord de la dépression.
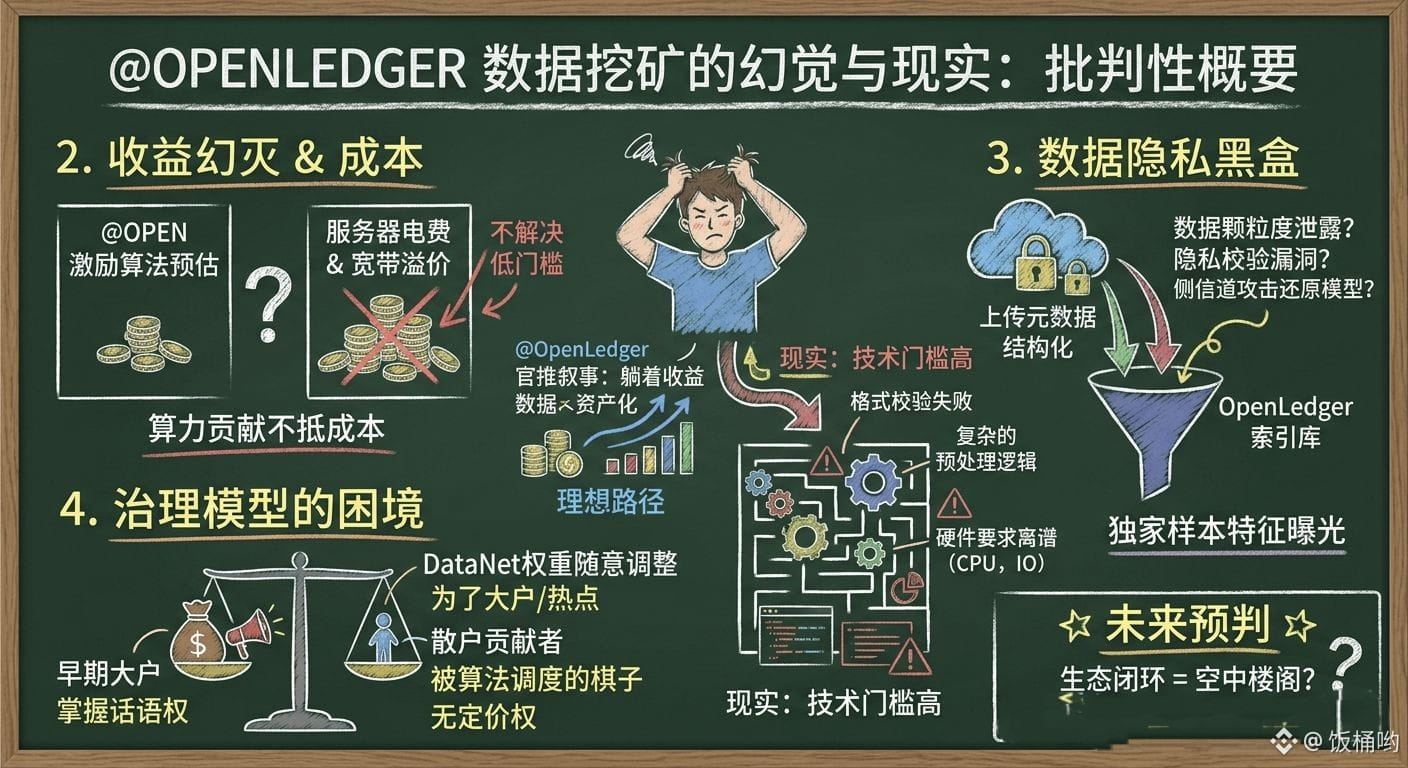
Je l'admets, j'étais enflammé par leur narration grandiose sur les données médicales et le minage, rêvant que je pouvais simplement transférer mes actifs dormant et récolter des revenus passifs de $OPEN . Mais quand est venu le moment de déployer un nœud de validation, la réalité m'a donné une claque. Dans leur documentation officielle, ils appellent cela une construction à faible seuil, mais en réalité, les exigences en matière de mémoire vidéo et de bande passante réseau sont effrayantes. J'ai fait tourner ma station de travail haut de gamme 4090 pendant trois jours, et en suivant leur dernière formule d'incitation dynamique, après avoir déduit les frais d'électricité en continu et les frais de large bande commerciale, ce que j'ai touché en $OPEN ne suffisait même pas à acheter un café, je travaillais gratuitement pour le mainnet.
Ce qui est encore plus effrayant que la réduction des revenus, c'est le gouffre sans fond des droits de propriété des données sous-jacentes et de la conformité. @OpenLedger ne fait que vanter leur preuve à zéro connaissance et leur technologie de cryptographie homomorphe, prétendant pouvoir rendre les données utilisables mais invisibles. Mais en pratique, pour obtenir un poids d'incitation élevé, tu dois empaqueter et synchroniser les vecteurs de caractéristiques des données et les textes des dossiers médicalisés dé-privés. Bien que les données médicales soient censées être stockées de manière décentralisée et anonyme, qui peut garantir que les nœuds de routage au niveau de la recherche ne seront pas piratés par des hackers via l'ingénierie inverse de la confidentialité différentielle ? Une fois qu'un échantillon exclusif est divulgué, ce ne sont pas nous, les mineurs de données qui avons fourni les données, qui serons tenus responsables ? #OpenLedger
Ce qui est encore plus désolant, c'est l'atmosphère de gouvernance communautaire autour de $OPEN en ce moment, les politiques changent tous les jours, nous, petits investisseurs, n'avons même pas de droit à l'information, sans parler du droit de parole. Pour le dire simplement, nous sommes juste le carburant que les algorithmes des baleines utilisent pour récolter. Je suis désormais complètement désillusionné, @OpenLedger est-il vraiment en train de révolutionner la manière dont les ressources de production AI sont distribuées, ou bien utilise-t-il le prétexte de l'AI décentralisée pour créer une nouvelle bulle de trafic ? Il n'y a même pas besoin de débattre. Je le dis clairement, si les porteurs de projet ne prennent pas en compte la sécurité de la vie privée et la transparence des revenus des petits investisseurs, s'appuyant uniquement sur quelques gros pour faire des transferts à gauche et à droite dans la communauté, cette soi-disant narration Web3+AI ne sera qu'une illusion.
Je l'admets, j'étais enflammé par leur narration grandiose sur les données médicales et le minage, rêvant que je pouvais simplement transférer mes actifs dormant et récolter des revenus passifs de $OPEN . Mais quand est venu le moment de déployer un nœud de validation, la réalité m'a donné une claque. Dans leur documentation officielle, ils appellent cela une construction à faible seuil, mais en réalité, les exigences en matière de mémoire vidéo et de bande passante réseau sont effrayantes. J'ai fait tourner ma station de travail haut de gamme 4090 pendant trois jours, et en suivant leur dernière formule d'incitation dynamique, après avoir déduit les frais d'électricité en continu et les frais de large bande commerciale, ce que j'ai touché en $OPEN ne suffisait même pas à acheter un café, je travaillais gratuitement pour le mainnet.
Ce qui est encore plus effrayant que la réduction des revenus, c'est le gouffre sans fond des droits de propriété des données sous-jacentes et de la conformité. @OpenLedger ne fait que vanter leur preuve à zéro connaissance et leur technologie de cryptographie homomorphe, prétendant pouvoir rendre les données utilisables mais invisibles. Mais en pratique, pour obtenir un poids d'incitation élevé, tu dois empaqueter et synchroniser les vecteurs de caractéristiques des données et les textes des dossiers médicalisés dé-privés. Bien que les données médicales soient censées être stockées de manière décentralisée et anonyme, qui peut garantir que les nœuds de routage au niveau de la recherche ne seront pas piratés par des hackers via l'ingénierie inverse de la confidentialité différentielle ? Une fois qu'un échantillon exclusif est divulgué, ce ne sont pas nous, les mineurs de données qui avons fourni les données, qui serons tenus responsables ? #OpenLedger
Ce qui est encore plus désolant, c'est l'atmosphère de gouvernance communautaire autour de $OPEN en ce moment, les politiques changent tous les jours, nous, petits investisseurs, n'avons même pas de droit à l'information, sans parler du droit de parole. Pour le dire simplement, nous sommes juste le carburant que les algorithmes des baleines utilisent pour récolter. Je suis désormais complètement désillusionné, @OpenLedger est-il vraiment en train de révolutionner la manière dont les ressources de production AI sont distribuées, ou bien utilise-t-il le prétexte de l'AI décentralisée pour créer une nouvelle bulle de trafic ? Il n'y a même pas besoin de débattre. Je le dis clairement, si les porteurs de projet ne prennent pas en compte la sécurité de la vie privée et la transparence des revenus des petits investisseurs, s'appuyant uniquement sur quelques gros pour faire des transferts à gauche et à droite dans la communauté, cette soi-disant narration Web3+AI ne sera qu'une illusion.