

À l’heure de l’explosion massive de l’intelligence artificielle (IA), vous êtes-vous déjà demandé une chose : nourrissons-nous un avenir technologique au service de toute l’humanité, ou assistons-nous à un super-monopole technologique entre les mains d’une poignée de géants ?
Aujourd’hui, le développement de l’IA dépend fortement de trois éléments clés : la puissance de calcul, les algorithmes et les données. Cependant, des données de haute qualité sont progressivement enfermées derrière des murs construits par de grands acteurs centralisés, qui s’en accaparent le contrôle. Pour les développeurs, obtenir des données d’entraînement propres, de qualité et conformes devient de plus en plus difficile.
C’est précisément pour briser cette « solitude des données » et cette impasse de monopoles que OpenLedger (registre ouvert) a vu le jour. Ce n’est pas seulement une architecture technique, mais une révolution disruptive portant sur la souveraineté des données à l’ère de l’IA et la collaboration décentralisée.$OPEN
Qu’est-ce qu’OpenLedger ?
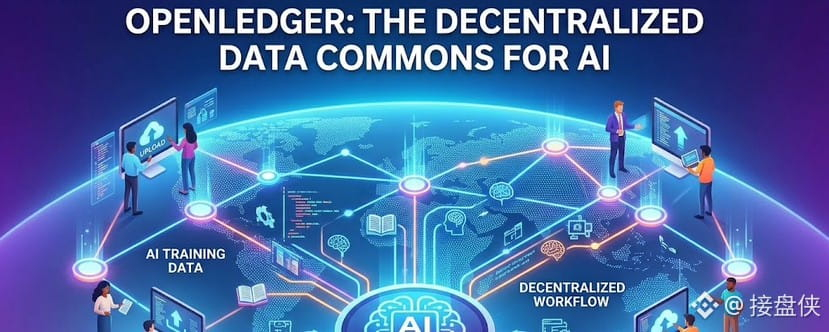
En termes simples, OpenLedger est un réseau décentralisé de « données commons (Data Commons) » conçu spécialement pour l’intelligence artificielle.#openledger
Il utilise l’immutabilité de la blockchain, le mécanisme d’incitation par jetons et le calcul de protection de la vie privée pour construire une infrastructure décentralisée de données sécurisée, transparente et extensible (DePIN). Dans l’écosystème d’OpenLedger, les données ne sont plus un actif privé enfermé dans les serveurs de grands acteurs : elles deviennent un actif numérique construit et partagé collectivement par des contributeurs du monde entier, générant des retours partagés.#OpenLedger
Sa mission centrale est très claire : faire circuler des données d’IA de haute qualité tout en garantissant que les droits des fournisseurs de données sont respectés de manière absolue.
Avantage clé : avec quoi OpenLedger change-t-il l’écosystème de l’IA ?
Si OpenLedger attire autant l’attention des milieux technologiques et du secteur Web3, c’est parce qu’il résout les problèmes clés de la chaîne d’approvisionnement traditionnelle des données pour l’IA :
Un pipeline de données décentralisées de haute qualité (Data Pipeline) : La collecte traditionnelle de données est pleine de bruit et peu efficace. OpenLedger, grâce à des workflows décentralisés, confie la collecte, le nettoyage, l’étiquetage et la distribution de vérification des données à des utilisateurs et à des nœuds automatisés à l’échelle mondiale. Ce modèle « crowdsourcing + IA » permet de produire, à très faible coût et à très grande vitesse, des ensembles de données de haute qualité adaptés à l’entraînement des grands modèles de langage (LLM).
Une titularité absolue des données et la traçabilité : Sur OpenLedger, chaque contribution, modification et utilisation des données est enregistrée en permanence dans un grand livre blockchain. Cela signifie que chaque élément de données que vous contribuez dispose d’une « carte d’identité » numérique. Lors de l’entraînement, il devient évident de quelles données l’IA a été nourrie, ce qui résout fondamentalement les litiges relatifs aux droits de propriété intellectuelle et à la conformité.
La « reconquête de la souveraineté » des contributeurs de données et les incitations : Par le passé, les données de comportement que nous avons générées sur les réseaux sociaux et sur Internet ont été utilisées gratuitement par de grands acteurs pour entraîner l’IA, tandis que nous ne recevions rien. Dans OpenLedger, « les données sont un actif ». Les utilisateurs qui contribuent des données, participent à leur étiquetage ou exécutent des nœuds de validation peuvent recevoir des incitations sous forme de jetons de l’écosystème. Vous devenez ainsi le véritable propriétaire de vos propres données.
L’équilibre parfait entre confidentialité et sécurité : En introduisant des technologies cryptographiques de pointe comme les preuves à divulgation nulle de connaissance (ZKP), OpenLedger permet aux modèles d’IA de s’entraîner sans entrer directement en contact avec les données originales confidentielles des utilisateurs. Cela ouvre la voie à l’implémentation de l’IA dans des secteurs extrêmement sensibles à la confidentialité, comme la santé et la finance.
Comment cela fonctionne-t-il ?
La logique de fonctionnement de l’écosystème d’OpenLedger peut être simplifiée en trois étapes :
Contribution et nettoyage (Supply) : Les fournisseurs de données (individus ou organisations) téléchargent des données brutes ; les nœuds décentralisés nettoient les données et en retirent le bruit.
Vérification et stockage (Validate & Store) : Les nœuds de vérification contrôlent la qualité des données afin de s’assurer qu’elles sont réelles et conformes, puis les distribuent en toute sécurité et les stockent dans un réseau de stockage décentralisé.
Consommation et entraînement (Consume) : Les développeurs d’IA et les organismes de recherche, en payant des jetons, accèdent à ces ensembles de données de haute qualité pour entraîner et affiner leurs modèles.
C’est un écosystème en boucle fermée parfaite. Plus les données sont riches, plus les développeurs d’IA attirés sont nombreux ; plus il y a de développeurs, plus la valeur produite par l’écosystème augmente, ce qui incite davantage de personnes à contribuer des données de haute qualité.
Pourquoi dit-on que c’est maintenant le meilleur moment pour se concentrer sur OpenLedger ?
En 2026, l’IA passe de la phase des « grands modèles généralistes » à la profondeur de l’ère des applications dans des domaines verticaux. Les données générales de l’Internet ont déjà été en grande partie « consommées » par les grands modèles. La compétition de l’IA de demain se jouera donc sur des données uniques, de haute qualité et conformes, spécialisées.
OpenLedger se trouve exactement à l’avant-garde de cette période. Il injecte non seulement de véritables scénarios d’application dans le Web3, mais fournit aussi à toute l’industrie de l’IA une voie de développement entièrement open source et décentralisée, qui ne dépend pas des grands acteurs centralisés.@OpenLedger
L’IA de demain ne devrait pas être définie par quelques personnes, mais façonnée ensemble par des contributeurs de données du monde entier. Ce que construit OpenLedger, c’est justement une nouvelle ère de souveraineté de l’IA, transparente, équitable et ouverte.