$OPEN as une couche de coordination : pourquoi le marché a besoin d’une blockchain native pour l’IA ?
La plupart des développeurs essaient d’exécuter des modèles d’IA sur des blockchains à usage général (L1/L2).
Je pense que c’est une tentative de faire entrer une cheville ronde dans un trou carré.
Les réseaux conventionnels sont conçus pour des transactions simples : transferts, frappes et mise en jeu. Ils ne sont absolument pas adaptés aux spécificités de l’intelligence artificielle, qui nécessite de traiter des gigaoctets de données chaque seconde, un suivi précis des contributions des auteurs et une coordination complexe de la puissance GPU.
C’est pourquoi le marché a besoin d’une blockchain native pour l’IA. Et c’est exactement le problème que OpenLedger résout.
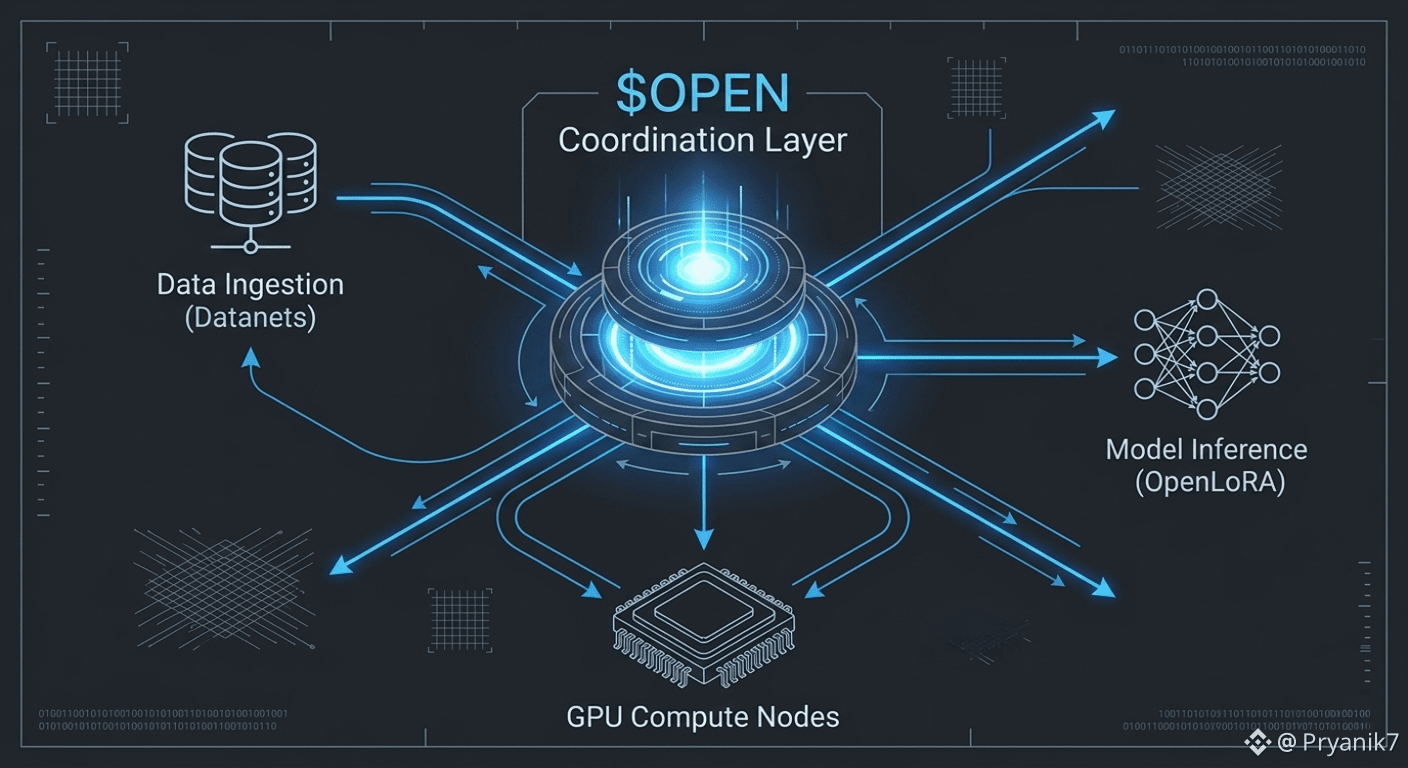
La documentation officielle du projet montre que le token ne fonctionne pas uniquement comme un moyen de paiement. Il agit comme une couche de coordination, reliant trois mondes distincts :
Datanets, développeurs de modèles et exploitants de matériel.
Lorsque vous exécutez une requête sur un modèle d’IA sur le réseau OpenLedger, l’ensemble de la chaîne est coordonné instantanément :
Il paie l’inférence (requête) -> active la technologie OpenLoRA pour l’optimisation GPU -> et, via Proof of Attribution, prélève automatiquement des redevances auprès de ceux dont les données ont servi à entraîner le modèle.
Sans une blockchain native pour l’IA, ce processus se transforme en chaos : frais élevés et retards.
Par conséquent, la puissance de $OPEN ne réside pas dans un utilitarisme abstrait.
Elle réside dans l’équilibre architectural :
le token supprime la friction entre données brutes et puissance de calcul, transformant des technologies disparates en une seule “roue libre” économique auto-régénérante.
Pour l’écosystème de l’IA, c’est une étape qui fait passer d’une application Web3 spéculative à une infrastructure souveraine à part entière.
@OpenLedger #OpenLedger $OPEN
La plupart des développeurs essaient d’exécuter des modèles d’IA sur des blockchains à usage général (L1/L2).
Je pense que c’est une tentative de faire entrer une cheville ronde dans un trou carré.
Les réseaux conventionnels sont conçus pour des transactions simples : transferts, frappes et mise en jeu. Ils ne sont absolument pas adaptés aux spécificités de l’intelligence artificielle, qui nécessite de traiter des gigaoctets de données chaque seconde, un suivi précis des contributions des auteurs et une coordination complexe de la puissance GPU.
C’est pourquoi le marché a besoin d’une blockchain native pour l’IA. Et c’est exactement le problème que OpenLedger résout.
La documentation officielle du projet montre que le token ne fonctionne pas uniquement comme un moyen de paiement. Il agit comme une couche de coordination, reliant trois mondes distincts :
Datanets, développeurs de modèles et exploitants de matériel.
Lorsque vous exécutez une requête sur un modèle d’IA sur le réseau OpenLedger, l’ensemble de la chaîne est coordonné instantanément :
Il paie l’inférence (requête) -> active la technologie OpenLoRA pour l’optimisation GPU -> et, via Proof of Attribution, prélève automatiquement des redevances auprès de ceux dont les données ont servi à entraîner le modèle.
Sans une blockchain native pour l’IA, ce processus se transforme en chaos : frais élevés et retards.
Par conséquent, la puissance de $OPEN ne réside pas dans un utilitarisme abstrait.
Elle réside dans l’équilibre architectural :
le token supprime la friction entre données brutes et puissance de calcul, transformant des technologies disparates en une seule “roue libre” économique auto-régénérante.
Pour l’écosystème de l’IA, c’est une étape qui fait passer d’une application Web3 spéculative à une infrastructure souveraine à part entière.
@OpenLedger #OpenLedger $OPEN