
Lavender⁰⁰¹
3.1k Publications

Lavender⁰⁰¹
Signaler
Bloquer l’utilisateur
Learning | Crypto Content Creator | Web3 believer 💛 💎 📈
Ouvert au trading
Trade fréquemment
4.8 mois
221 Suivis
2.5K+ Abonnés
1.9K+ J’aime
Publications
Portefeuille
·
--
#dusk $DUSK @Dusk_Foundation Une petite table dans les notes de sécurité du portefeuille de Dusk a rendu le mot de passe trompeur : l’extension de navigateur utilise PBKDF2-SHA-256 avec 900 000 itérations, tandis que la voie native est décrite comme étant basée sur Stronghold plus un stockage chiffré au niveau du système d’exploitation.
Donc, le même mot de passe n’achète pas nécessairement la même résistance au déchiffrement. Pourtant, la documentation publique de DUSK ne divulgue pas assez de détails natifs sur Argon2 (coût mémoire, nombre d’itérations et parallélisme) pour calculer à quel point une attaque hors ligne est réellement plus difficile. « Memory-hard » est une étiquette de conception, pas un avantage mesuré.
Il y a un autre problème. Le chiffrement au repos protège un coffre verrouillé. Après déverrouillage, l’extension conserve le mnémonique dans le tas JavaScript, le purge lors du verrouillage ou après un délai, mais ne peut pas garantir une mise à zéro (zéroisation). Un mot de passe faible peut réduire la première défense ; une extension malveillante, ou une extension hostile ou un appareil compromis peuvent la contourner entièrement.
Cela change la façon dont je juge la conservation en autonomie de DUSK : la force du mot de passe versus la surface d’attaque réelle, et non Argon2 versus PBKDF2 comme noms de marque.
J’aimerais que DUSK publie les paramètres complets du KDF natif, fasse des tests comparatifs avec des mots de passe identiques sur différents appareils, et indique pendant combien de temps le matériel de clé reste exposé. D’ici là, dire que DUSK utilise Argon2 répond à quelle technologie existe, mais pas au niveau de protection réel que les utilisateurs reçoivent.
{future}(DUSKUSDT)
#dusk $DUSK @Dusk Une petite table dans les notes de sécurité du portefeuille de Dusk a rendu le mot de passe trompeur : l’extension de navigateur utilise PBKDF2-SHA-256 avec 900 000 itérations, tandis que la voie native est décrite comme étant basée sur Stronghold plus un stockage chiffré au niveau du système d’exploitation.
Donc, le même mot de passe n’achète pas nécessairement la même résistance au déchiffrement. Pourtant, la documentation publique de DUSK ne divulgue pas assez de détails natifs sur Argon2 (coût mémoire, nombre d’itérations et parallélisme) pour calculer à quel point une attaque hors ligne est réellement plus difficile. « Memory-hard » est une étiquette de conception, pas un avantage mesuré.
Il y a un autre problème. Le chiffrement au repos protège un coffre verrouillé. Après déverrouillage, l’extension conserve le mnémonique dans le tas JavaScript, le purge lors du verrouillage ou après un délai, mais ne peut pas garantir une mise à zéro (zéroisation). Un mot de passe faible peut réduire la première défense ; une extension malveillante, ou une extension hostile ou un appareil compromis peuvent la contourner entièrement.
Cela change la façon dont je juge la conservation en autonomie de DUSK : la force du mot de passe versus la surface d’attaque réelle, et non Argon2 versus PBKDF2 comme noms de marque.
J’aimerais que DUSK publie les paramètres complets du KDF natif, fasse des tests comparatifs avec des mots de passe identiques sur différents appareils, et indique pendant combien de temps le matériel de clé reste exposé. D’ici là, dire que DUSK utilise Argon2 répond à quelle technologie existe, mais pas au niveau de protection réel que les utilisateurs reçoivent.
Donc, le même mot de passe n’achète pas nécessairement la même résistance au déchiffrement. Pourtant, la documentation publique de DUSK ne divulgue pas assez de détails natifs sur Argon2 (coût mémoire, nombre d’itérations et parallélisme) pour calculer à quel point une attaque hors ligne est réellement plus difficile. « Memory-hard » est une étiquette de conception, pas un avantage mesuré.
Il y a un autre problème. Le chiffrement au repos protège un coffre verrouillé. Après déverrouillage, l’extension conserve le mnémonique dans le tas JavaScript, le purge lors du verrouillage ou après un délai, mais ne peut pas garantir une mise à zéro (zéroisation). Un mot de passe faible peut réduire la première défense ; une extension malveillante, ou une extension hostile ou un appareil compromis peuvent la contourner entièrement.
Cela change la façon dont je juge la conservation en autonomie de DUSK : la force du mot de passe versus la surface d’attaque réelle, et non Argon2 versus PBKDF2 comme noms de marque.
J’aimerais que DUSK publie les paramètres complets du KDF natif, fasse des tests comparatifs avec des mots de passe identiques sur différents appareils, et indique pendant combien de temps le matériel de clé reste exposé. D’ici là, dire que DUSK utilise Argon2 répond à quelle technologie existe, mais pas au niveau de protection réel que les utilisateurs reçoivent.
8
10
10.9k
·
--
#dusk $DUSK @Dusk_Foundation Je me suis retrouvé bloqué à comparer deux comptes Dusk financés en quelques minutes. L’un a transféré immédiatement, l’autre est resté sans être touché et n’est jamais réapparu.
Cet écart peut révéler plus que la croissance des comptes. Des cohortes utiles sont les portefeuilles qui effectuent une première action, reviennent dans les sept jours et font plus que de simples transferts circulaires entre des clusters liés.
Pour DUSK, je distinguerais les utilisateurs qui ne font que transférer des utilisateurs qui interagissent avec des contrats, puis je suivrais le temps d’activation, les soldes bloqués, la rétention, les flux vers le top décile et la dispersion des soldes publics. La distribution peut paraître plus saine alors que le même capital continue de tourner. C’est un peu maladroit, mais c’est important.
Les provisionneurs méritent la même volatilité de récompense selon la taille de la mise : la part qui ne gagne rien sur 24 heures, les taux de vote manqué, la couverture de disponibilité à 99 %, le seau de 1 000 à 2 000 DUSK et le HHI de la mise. Ensuite, retirez les trois meilleurs provisionneurs des simulations du comité. La finalité tient-elle toujours ?
Ce que la plupart des gens ratent, c’est que le nombre n’est pas de la résilience. Une hausse de la mise après des récompenses au-dessus de la moyenne peut n’être qu’une chasse au rendement, tandis qu’une implémentation Rusk dominante laisse chaque opérateur exposé à la même défaillance côté client.
DUSK peut récompenser l’activité visible tout en dépendant d’un noyau plus étroit d’utilisateurs réels et d’une mise fiable. Si les deux groupes paraissent plus larges qu’ils ne le sont, la décentralisation devient une couche de présentation.
Je regarde les distributions, pas les totaux.
{future}(DUSKUSDT)
#dusk $DUSK @Dusk Je me suis retrouvé bloqué à comparer deux comptes Dusk financés en quelques minutes. L’un a transféré immédiatement, l’autre est resté sans être touché et n’est jamais réapparu.
Cet écart peut révéler plus que la croissance des comptes. Des cohortes utiles sont les portefeuilles qui effectuent une première action, reviennent dans les sept jours et font plus que de simples transferts circulaires entre des clusters liés.
Pour DUSK, je distinguerais les utilisateurs qui ne font que transférer des utilisateurs qui interagissent avec des contrats, puis je suivrais le temps d’activation, les soldes bloqués, la rétention, les flux vers le top décile et la dispersion des soldes publics. La distribution peut paraître plus saine alors que le même capital continue de tourner. C’est un peu maladroit, mais c’est important.
Les provisionneurs méritent la même volatilité de récompense selon la taille de la mise : la part qui ne gagne rien sur 24 heures, les taux de vote manqué, la couverture de disponibilité à 99 %, le seau de 1 000 à 2 000 DUSK et le HHI de la mise. Ensuite, retirez les trois meilleurs provisionneurs des simulations du comité. La finalité tient-elle toujours ?
Ce que la plupart des gens ratent, c’est que le nombre n’est pas de la résilience. Une hausse de la mise après des récompenses au-dessus de la moyenne peut n’être qu’une chasse au rendement, tandis qu’une implémentation Rusk dominante laisse chaque opérateur exposé à la même défaillance côté client.
DUSK peut récompenser l’activité visible tout en dépendant d’un noyau plus étroit d’utilisateurs réels et d’une mise fiable. Si les deux groupes paraissent plus larges qu’ils ne le sont, la décentralisation devient une couche de présentation.
Je regarde les distributions, pas les totaux.
Cet écart peut révéler plus que la croissance des comptes. Des cohortes utiles sont les portefeuilles qui effectuent une première action, reviennent dans les sept jours et font plus que de simples transferts circulaires entre des clusters liés.
Pour DUSK, je distinguerais les utilisateurs qui ne font que transférer des utilisateurs qui interagissent avec des contrats, puis je suivrais le temps d’activation, les soldes bloqués, la rétention, les flux vers le top décile et la dispersion des soldes publics. La distribution peut paraître plus saine alors que le même capital continue de tourner. C’est un peu maladroit, mais c’est important.
Les provisionneurs méritent la même volatilité de récompense selon la taille de la mise : la part qui ne gagne rien sur 24 heures, les taux de vote manqué, la couverture de disponibilité à 99 %, le seau de 1 000 à 2 000 DUSK et le HHI de la mise. Ensuite, retirez les trois meilleurs provisionneurs des simulations du comité. La finalité tient-elle toujours ?
Ce que la plupart des gens ratent, c’est que le nombre n’est pas de la résilience. Une hausse de la mise après des récompenses au-dessus de la moyenne peut n’être qu’une chasse au rendement, tandis qu’une implémentation Rusk dominante laisse chaque opérateur exposé à la même défaillance côté client.
DUSK peut récompenser l’activité visible tout en dépendant d’un noyau plus étroit d’utilisateurs réels et d’une mise fiable. Si les deux groupes paraissent plus larges qu’ils ne le sont, la décentralisation devient une couche de présentation.
Je regarde les distributions, pas les totaux.
6
11
6.5k
·
--
Vérifié
#dusk $DUSK @Dusk_Foundation Je vérifiais les calculs de pont (bridge) de DUSK et un nombre m’a dérangé plus que le volume annoncé : quelle quantité de l’offre est encore réellement conservée sur ERC20 et BEP20 après la migration mainnet ?
C’est le test de maturité qui m’importe.
Si 10 M€ sortent et 10 M€ reviennent, le pont peut annoncer 20 M€ d’activité brute alors que la migration nette est nulle. Le mouvement n’est pas une migration. Le volume n’est pas l’aboutissement.
Je préférerais suivre chaque semaine la vélocité de migration, le pourcentage de DUSK historique encore hors mainnet et le « dust ratio » (ratio de poussière) restant après que les utilisateurs ont demandé une migration. Ces chiffres montreraient si le réseau se consolide ou s’il ne fait que circuler.
Les frais fixes du pont révèlent aussi une autre subtilité. Des frais de 1 DUSK sur 10 tokens représentent 10 %. Sur 10 000 tokens, c’est 0,01 %. Même infrastructure, mais des économies utilisateur totalement différentes.
Et même après qu’un transfert via un pont mainnet est finalisé, la livraison à destination peut encore dépendre d’une étape de traitement externe. Cela compte plus que ce que cela paraît.
La question plus profonde est la même pour les RWA : 300 M€ enveloppés on-chain ne sont pas équivalents à 300 M€ émis nativement on-chain. L’un reflète une infrastructure historique ; l’autre en remplace une partie.
Je surveille DUSK pour la complétion de la migration, pas pour le mouvement du pont.
{future}(DUSKUSDT)
#dusk $DUSK @Dusk Je vérifiais les calculs de pont (bridge) de DUSK et un nombre m’a dérangé plus que le volume annoncé : quelle quantité de l’offre est encore réellement conservée sur ERC20 et BEP20 après la migration mainnet ?
C’est le test de maturité qui m’importe.
Si 10 M€ sortent et 10 M€ reviennent, le pont peut annoncer 20 M€ d’activité brute alors que la migration nette est nulle. Le mouvement n’est pas une migration. Le volume n’est pas l’aboutissement.
Je préférerais suivre chaque semaine la vélocité de migration, le pourcentage de DUSK historique encore hors mainnet et le « dust ratio » (ratio de poussière) restant après que les utilisateurs ont demandé une migration. Ces chiffres montreraient si le réseau se consolide ou s’il ne fait que circuler.
Les frais fixes du pont révèlent aussi une autre subtilité. Des frais de 1 DUSK sur 10 tokens représentent 10 %. Sur 10 000 tokens, c’est 0,01 %. Même infrastructure, mais des économies utilisateur totalement différentes.
Et même après qu’un transfert via un pont mainnet est finalisé, la livraison à destination peut encore dépendre d’une étape de traitement externe. Cela compte plus que ce que cela paraît.
La question plus profonde est la même pour les RWA : 300 M€ enveloppés on-chain ne sont pas équivalents à 300 M€ émis nativement on-chain. L’un reflète une infrastructure historique ; l’autre en remplace une partie.
Je surveille DUSK pour la complétion de la migration, pas pour le mouvement du pont.
C’est le test de maturité qui m’importe.
Si 10 M€ sortent et 10 M€ reviennent, le pont peut annoncer 20 M€ d’activité brute alors que la migration nette est nulle. Le mouvement n’est pas une migration. Le volume n’est pas l’aboutissement.
Je préférerais suivre chaque semaine la vélocité de migration, le pourcentage de DUSK historique encore hors mainnet et le « dust ratio » (ratio de poussière) restant après que les utilisateurs ont demandé une migration. Ces chiffres montreraient si le réseau se consolide ou s’il ne fait que circuler.
Les frais fixes du pont révèlent aussi une autre subtilité. Des frais de 1 DUSK sur 10 tokens représentent 10 %. Sur 10 000 tokens, c’est 0,01 %. Même infrastructure, mais des économies utilisateur totalement différentes.
Et même après qu’un transfert via un pont mainnet est finalisé, la livraison à destination peut encore dépendre d’une étape de traitement externe. Cela compte plus que ce que cela paraît.
La question plus profonde est la même pour les RWA : 300 M€ enveloppés on-chain ne sont pas équivalents à 300 M€ émis nativement on-chain. L’un reflète une infrastructure historique ; l’autre en remplace une partie.
Je surveille DUSK pour la complétion de la migration, pas pour le mouvement du pont.
15
20
17.6k
·
--
#dusk $DUSK @Dusk_Foundation Le marché évoluait latéralement ce soir-là, et je faisais à moitié la lecture de la documentation de DUSK lorsque je me suis surpris à fixer la même question trop longtemps : quelle part de l’activité de DUSK se déroule réellement via sa couche de confidentialité ?
Il est facile de considérer Moonlight et Phoenix comme deux modèles de transaction et s’en tenir là. Mais cela passe à côté de la partie intéressante. Si la confidentialité est vraiment utile, je m’attendrais à voir les utilisateurs la choisir, pas seulement le protocole la prendre en charge.
Alors je suivrais la répartition sur 24h, 7j, 30j et 90j : part de Moonlight, part de Phoenix, utilisateurs actifs, transactions par utilisateur, puis je suivrais les mêmes comptes depuis leur première transaction Moonlight jusqu’à leur première transaction Phoenix.
Cela change complètement la question.
L’adoption de la confidentialité n’est pas prouvée par le fait d’avoir un modèle de transaction privée..
Elle est prouvée quand les utilisateurs y migrent volontairement et y restent.
Je mesurerais aussi le temps médian de migration ainsi que la rétention Phoenix à J7/J30/J90. Un pic de transactions sur Phoenix pourrait indiquer une expérimentation. Une utilisation répétée et durable signifierait quelque chose de plus solide.
Il y a une deuxième couche que je surveillerais : les appels de contrat versus les transferts de base. Si les interactions d’application et l’activité de confidentialité augmentent toutes les deux, DUSK pourrait montrer une utilisation plus profonde plutôt qu’une simple croissance du volume de transactions.
Je ne sais pas encore quelles seraient les conclusions des chiffres. C’est précisément pour cela que je préfère mesurer le comportement plutôt que de répéter le récit sur la confidentialité.
Et l’onglet de documentation est toujours ouvert......
{future}(DUSKUSDT)
#dusk $DUSK @Dusk Le marché évoluait latéralement ce soir-là, et je faisais à moitié la lecture de la documentation de DUSK lorsque je me suis surpris à fixer la même question trop longtemps : quelle part de l’activité de DUSK se déroule réellement via sa couche de confidentialité ?
Il est facile de considérer Moonlight et Phoenix comme deux modèles de transaction et s’en tenir là. Mais cela passe à côté de la partie intéressante. Si la confidentialité est vraiment utile, je m’attendrais à voir les utilisateurs la choisir, pas seulement le protocole la prendre en charge.
Alors je suivrais la répartition sur 24h, 7j, 30j et 90j : part de Moonlight, part de Phoenix, utilisateurs actifs, transactions par utilisateur, puis je suivrais les mêmes comptes depuis leur première transaction Moonlight jusqu’à leur première transaction Phoenix.
Cela change complètement la question.
L’adoption de la confidentialité n’est pas prouvée par le fait d’avoir un modèle de transaction privée..
Elle est prouvée quand les utilisateurs y migrent volontairement et y restent.
Je mesurerais aussi le temps médian de migration ainsi que la rétention Phoenix à J7/J30/J90. Un pic de transactions sur Phoenix pourrait indiquer une expérimentation. Une utilisation répétée et durable signifierait quelque chose de plus solide.
Il y a une deuxième couche que je surveillerais : les appels de contrat versus les transferts de base. Si les interactions d’application et l’activité de confidentialité augmentent toutes les deux, DUSK pourrait montrer une utilisation plus profonde plutôt qu’une simple croissance du volume de transactions.
Je ne sais pas encore quelles seraient les conclusions des chiffres. C’est précisément pour cela que je préfère mesurer le comportement plutôt que de répéter le récit sur la confidentialité.
Et l’onglet de documentation est toujours ouvert......
Il est facile de considérer Moonlight et Phoenix comme deux modèles de transaction et s’en tenir là. Mais cela passe à côté de la partie intéressante. Si la confidentialité est vraiment utile, je m’attendrais à voir les utilisateurs la choisir, pas seulement le protocole la prendre en charge.
Alors je suivrais la répartition sur 24h, 7j, 30j et 90j : part de Moonlight, part de Phoenix, utilisateurs actifs, transactions par utilisateur, puis je suivrais les mêmes comptes depuis leur première transaction Moonlight jusqu’à leur première transaction Phoenix.
Cela change complètement la question.
L’adoption de la confidentialité n’est pas prouvée par le fait d’avoir un modèle de transaction privée..
Elle est prouvée quand les utilisateurs y migrent volontairement et y restent.
Je mesurerais aussi le temps médian de migration ainsi que la rétention Phoenix à J7/J30/J90. Un pic de transactions sur Phoenix pourrait indiquer une expérimentation. Une utilisation répétée et durable signifierait quelque chose de plus solide.
Il y a une deuxième couche que je surveillerais : les appels de contrat versus les transferts de base. Si les interactions d’application et l’activité de confidentialité augmentent toutes les deux, DUSK pourrait montrer une utilisation plus profonde plutôt qu’une simple croissance du volume de transactions.
Je ne sais pas encore quelles seraient les conclusions des chiffres. C’est précisément pour cela que je préfère mesurer le comportement plutôt que de répéter le récit sur la confidentialité.
Et l’onglet de documentation est toujours ouvert......
7
16
11.9k
·
--
Partiellement vrai
#dusk $DUSK @Dusk_Foundation DUSK Réseau Dérive de la concentration du staking : de combien la part du Top-10 évolue-t-elle tous les 100 epochs ?
Le marché bougeait à peine ce soir-là, alors j’ai fini par fixer le tableau des validateurs de DUSK plutôt que le graphique. Je voyais sans cesse « 200+ validateurs actifs » et je l’ai d’abord interprété comme un signal de décentralisation.
Puis quelque chose ne collait pas.
Un nombre de validateurs me dit combien de participants existent. Il ne me dit pas quel poids de consensus les plus importants contrôlent. Les récompenses de staking de Dusk sont probabilistes et dépendent en partie du capital investi actif, tandis que le protocole ne fixe aucun plafond de stake. Cela rend la dérive de la concentration intéressante à mesurer, plutôt qu’à présumer.
L’instantané actuel de l’explorateur communautaire montre qu’environ 25,8 % du stake actif se trouvent entre les dix plus grands validateurs. Mais un seul instantané ne me permet pas de savoir si DUSK se décentralise ou s’il se regroupe lentement.
C’est la distinction : le nombre de nœuds mesure la participation ; la dérive du stake mesure le pouvoir.
Je suivrais la part du stake actif du Top-10 tous les 100 epochs, puis je comparerais le changement avec le nouveau stake, le retrait, la croissance des pools, le slashing et la capitalisation des récompenses.
Peut-être que la distribution reste saine. Je ne peux pas encore répondre à cela, sincèrement.
Le graphique reste calme. Le tableau des validateurs devient désormais beaucoup plus intéressant.
{future}(DUSKUSDT)
#dusk $DUSK @Dusk DUSK Réseau Dérive de la concentration du staking : de combien la part du Top-10 évolue-t-elle tous les 100 epochs ?
Le marché bougeait à peine ce soir-là, alors j’ai fini par fixer le tableau des validateurs de DUSK plutôt que le graphique. Je voyais sans cesse « 200+ validateurs actifs » et je l’ai d’abord interprété comme un signal de décentralisation.
Puis quelque chose ne collait pas.
Un nombre de validateurs me dit combien de participants existent. Il ne me dit pas quel poids de consensus les plus importants contrôlent. Les récompenses de staking de Dusk sont probabilistes et dépendent en partie du capital investi actif, tandis que le protocole ne fixe aucun plafond de stake. Cela rend la dérive de la concentration intéressante à mesurer, plutôt qu’à présumer.
L’instantané actuel de l’explorateur communautaire montre qu’environ 25,8 % du stake actif se trouvent entre les dix plus grands validateurs. Mais un seul instantané ne me permet pas de savoir si DUSK se décentralise ou s’il se regroupe lentement.
C’est la distinction : le nombre de nœuds mesure la participation ; la dérive du stake mesure le pouvoir.
Je suivrais la part du stake actif du Top-10 tous les 100 epochs, puis je comparerais le changement avec le nouveau stake, le retrait, la croissance des pools, le slashing et la capitalisation des récompenses.
Peut-être que la distribution reste saine. Je ne peux pas encore répondre à cela, sincèrement.
Le graphique reste calme. Le tableau des validateurs devient désormais beaucoup plus intéressant.
Le marché bougeait à peine ce soir-là, alors j’ai fini par fixer le tableau des validateurs de DUSK plutôt que le graphique. Je voyais sans cesse « 200+ validateurs actifs » et je l’ai d’abord interprété comme un signal de décentralisation.
Puis quelque chose ne collait pas.
Un nombre de validateurs me dit combien de participants existent. Il ne me dit pas quel poids de consensus les plus importants contrôlent. Les récompenses de staking de Dusk sont probabilistes et dépendent en partie du capital investi actif, tandis que le protocole ne fixe aucun plafond de stake. Cela rend la dérive de la concentration intéressante à mesurer, plutôt qu’à présumer.
L’instantané actuel de l’explorateur communautaire montre qu’environ 25,8 % du stake actif se trouvent entre les dix plus grands validateurs. Mais un seul instantané ne me permet pas de savoir si DUSK se décentralise ou s’il se regroupe lentement.
C’est la distinction : le nombre de nœuds mesure la participation ; la dérive du stake mesure le pouvoir.
Je suivrais la part du stake actif du Top-10 tous les 100 epochs, puis je comparerais le changement avec le nouveau stake, le retrait, la croissance des pools, le slashing et la capitalisation des récompenses.
Peut-être que la distribution reste saine. Je ne peux pas encore répondre à cela, sincèrement.
Le graphique reste calme. Le tableau des validateurs devient désormais beaucoup plus intéressant.
15
20
10k
·
--
#dusk $DUSK @Dusk_Foundation La nuit dernière, je comparais des données de combustion DUSK et j’ai remarqué quelque chose de légèrement agaçant : le ratio changeait selon l’endroit où je commençais la fenêtre de 24 heures.
Ça ressemble à un petit détail de comptabilité. Ce n’est pas le cas.
Un jour calendaire de minuit à minuit peut raconter une histoire de combustion, tandis qu’une fenêtre glissante de 24 heures commençant six heures plus tard peut en raconter une autre. Si une courte pointe de combustion DUSK se trouve juste près du seuil, décaler la fenêtre peut soit en capturer l’essentiel, soit la diviser en deux périodes.
Donc, le ratio de combustion au pic seul me dit moins que ce que je pensais au départ.
Ce qui compte davantage, c’est si le taux de combustion tient dans le temps. Je regarderais combien de temps DUSK reste au-dessus d’un niveau utile de combustion par rapport à la récompense, à quel point le ratio varie entre des fenêtres glissantes, et si les périodes de combustion les plus importantes continuent d’apparaître. Une pointe de 30 % pendant une heure n’est pas la même chose qu’un 16 % réparti sur la majeure partie de la journée.
En gros, il s’agit de l’activité maximale versus la pression durable du système.
Je surveillerais aussi l’écart-type sur plusieurs fenêtres glissantes. Si 24 heures de départ différentes produisent des ratios très différents, la combustion de DUSK pourrait encore être pilotée par un événement plutôt que structurellement stable.
La question inconfortable est simple : mesure-t-on une véritable pression de destruction de jetons, ou bien choisit-on une fenêtre qui rend l’événement de combustion le plus récent important ?
{future}(DUSKUSDT)
#dusk $DUSK @Dusk La nuit dernière, je comparais des données de combustion DUSK et j’ai remarqué quelque chose de légèrement agaçant : le ratio changeait selon l’endroit où je commençais la fenêtre de 24 heures.
Ça ressemble à un petit détail de comptabilité. Ce n’est pas le cas.
Un jour calendaire de minuit à minuit peut raconter une histoire de combustion, tandis qu’une fenêtre glissante de 24 heures commençant six heures plus tard peut en raconter une autre. Si une courte pointe de combustion DUSK se trouve juste près du seuil, décaler la fenêtre peut soit en capturer l’essentiel, soit la diviser en deux périodes.
Donc, le ratio de combustion au pic seul me dit moins que ce que je pensais au départ.
Ce qui compte davantage, c’est si le taux de combustion tient dans le temps. Je regarderais combien de temps DUSK reste au-dessus d’un niveau utile de combustion par rapport à la récompense, à quel point le ratio varie entre des fenêtres glissantes, et si les périodes de combustion les plus importantes continuent d’apparaître. Une pointe de 30 % pendant une heure n’est pas la même chose qu’un 16 % réparti sur la majeure partie de la journée.
En gros, il s’agit de l’activité maximale versus la pression durable du système.
Je surveillerais aussi l’écart-type sur plusieurs fenêtres glissantes. Si 24 heures de départ différentes produisent des ratios très différents, la combustion de DUSK pourrait encore être pilotée par un événement plutôt que structurellement stable.
La question inconfortable est simple : mesure-t-on une véritable pression de destruction de jetons, ou bien choisit-on une fenêtre qui rend l’événement de combustion le plus récent important ?
Ça ressemble à un petit détail de comptabilité. Ce n’est pas le cas.
Un jour calendaire de minuit à minuit peut raconter une histoire de combustion, tandis qu’une fenêtre glissante de 24 heures commençant six heures plus tard peut en raconter une autre. Si une courte pointe de combustion DUSK se trouve juste près du seuil, décaler la fenêtre peut soit en capturer l’essentiel, soit la diviser en deux périodes.
Donc, le ratio de combustion au pic seul me dit moins que ce que je pensais au départ.
Ce qui compte davantage, c’est si le taux de combustion tient dans le temps. Je regarderais combien de temps DUSK reste au-dessus d’un niveau utile de combustion par rapport à la récompense, à quel point le ratio varie entre des fenêtres glissantes, et si les périodes de combustion les plus importantes continuent d’apparaître. Une pointe de 30 % pendant une heure n’est pas la même chose qu’un 16 % réparti sur la majeure partie de la journée.
En gros, il s’agit de l’activité maximale versus la pression durable du système.
Je surveillerais aussi l’écart-type sur plusieurs fenêtres glissantes. Si 24 heures de départ différentes produisent des ratios très différents, la combustion de DUSK pourrait encore être pilotée par un événement plutôt que structurellement stable.
La question inconfortable est simple : mesure-t-on une véritable pression de destruction de jetons, ou bien choisit-on une fenêtre qui rend l’événement de combustion le plus récent important ?
30
24
10.2k
·
--
#dusk $DUSK @Dusk_Foundation En consultant l’historique des récompenses d’un détenteur/« provisioner » DUSK, j’ai remarqué quelque chose que j’avais traité trop légèrement : le stake engagé et le stake de consensus utile ne correspondent pas au même nombre.
Cet écart compte, car la qualité du staking peut modifier le résultat économique même lorsque le calendrier d’émission semble prévisible. Si du capital est hors ligne, bloqué, concentré ou en mouvement constant, la participation en première ligne peut surestimer la quantité de sécurité que DUSK achète réellement.
Je préférerais suivre l’efficacité du capital : le stake actif divisé par le total de DUSK engagé. Ensuite, je le mettrais en regard avec le churn, c’est‑à‑dire les entrées et sorties par rapport au stake actif moyen, ainsi que la rétention après 30, 90 et 365 jours.
La comparaison est simple : l’activité indique combien de capital est entré dans le staking ; la qualité indique combien est resté productif.
La concentration de la propriété n’est qu’une moitié de l’image. L’HHI de l’infrastructure pourrait rester élevé même avec beaucoup de portefeuilles, si les mêmes fournisseurs d’hébergement se trouvent derrière.
Le flottant sur les exchanges versus le stake actif compte aussi : quelle part du capital de consensus pourrait devenir liquide en cas de stress ?
Ce qui me laisse encore dans le doute, c’est la durée. Dix pour cent hors ligne pendant dix minutes, ce n’est pas la même chose que dix pour cent hors ligne pendant dix heures.
Pour la rareté de DUSK et la qualité du staking, l’une ne s’améliore pas toujours avec l’autre. C’est cette tension que je surveillerais.
{future}(DUSKUSDT)
#dusk $DUSK @Dusk En consultant l’historique des récompenses d’un détenteur/« provisioner » DUSK, j’ai remarqué quelque chose que j’avais traité trop légèrement : le stake engagé et le stake de consensus utile ne correspondent pas au même nombre.
Cet écart compte, car la qualité du staking peut modifier le résultat économique même lorsque le calendrier d’émission semble prévisible. Si du capital est hors ligne, bloqué, concentré ou en mouvement constant, la participation en première ligne peut surestimer la quantité de sécurité que DUSK achète réellement.
Je préférerais suivre l’efficacité du capital : le stake actif divisé par le total de DUSK engagé. Ensuite, je le mettrais en regard avec le churn, c’est‑à‑dire les entrées et sorties par rapport au stake actif moyen, ainsi que la rétention après 30, 90 et 365 jours.
La comparaison est simple : l’activité indique combien de capital est entré dans le staking ; la qualité indique combien est resté productif.
La concentration de la propriété n’est qu’une moitié de l’image. L’HHI de l’infrastructure pourrait rester élevé même avec beaucoup de portefeuilles, si les mêmes fournisseurs d’hébergement se trouvent derrière.
Le flottant sur les exchanges versus le stake actif compte aussi : quelle part du capital de consensus pourrait devenir liquide en cas de stress ?
Ce qui me laisse encore dans le doute, c’est la durée. Dix pour cent hors ligne pendant dix minutes, ce n’est pas la même chose que dix pour cent hors ligne pendant dix heures.
Pour la rareté de DUSK et la qualité du staking, l’une ne s’améliore pas toujours avec l’autre. C’est cette tension que je surveillerais.
Cet écart compte, car la qualité du staking peut modifier le résultat économique même lorsque le calendrier d’émission semble prévisible. Si du capital est hors ligne, bloqué, concentré ou en mouvement constant, la participation en première ligne peut surestimer la quantité de sécurité que DUSK achète réellement.
Je préférerais suivre l’efficacité du capital : le stake actif divisé par le total de DUSK engagé. Ensuite, je le mettrais en regard avec le churn, c’est‑à‑dire les entrées et sorties par rapport au stake actif moyen, ainsi que la rétention après 30, 90 et 365 jours.
La comparaison est simple : l’activité indique combien de capital est entré dans le staking ; la qualité indique combien est resté productif.
La concentration de la propriété n’est qu’une moitié de l’image. L’HHI de l’infrastructure pourrait rester élevé même avec beaucoup de portefeuilles, si les mêmes fournisseurs d’hébergement se trouvent derrière.
Le flottant sur les exchanges versus le stake actif compte aussi : quelle part du capital de consensus pourrait devenir liquide en cas de stress ?
Ce qui me laisse encore dans le doute, c’est la durée. Dix pour cent hors ligne pendant dix minutes, ce n’est pas la même chose que dix pour cent hors ligne pendant dix heures.
Pour la rareté de DUSK et la qualité du staking, l’une ne s’améliore pas toujours avec l’autre. C’est cette tension que je surveillerais.
29
23
4k
·
--
#dusk $DUSK @Dusk_Foundation En examinant le modèle de sécurité confidentiel de DUSK, je me suis constamment heurté à un nombre ennuyeux : une sécurité sur 20 ans pourrait survivre à environ dix grands cycles logiciels si la pile change matériellement tous les deux ans.
Ce n’est pas seulement un problème de migration. C’est un problème de continuité de la propriété.
Imaginez 50 000 positions privées passant par un split d’actions. La revendication facile, c’est que chaque solde a été mis à jour. La norme plus exigeante est la suivante : la propriété totale avant doit être égale à la propriété totale après, en conservant chaque détenteur, sans divulguer qui possède quoi.
La même pression se retrouve dans les dividendes. 20 000 détenteurs payés chaque trimestre, cela fait 80 000 événements d’ayants droit par an. DUSK ne peut pas s’appuyer sur la visibilité publique comme peut le faire un registre transparent. Il lui faut une exactitude globale sans divulgation au niveau des détenteurs.
Cette distinction compte pour DUSK, car la confidentialité déplace la confiance de « tout le monde peut l’inspecter » vers « tout le monde peut vérifier la preuve ».
Et je pense que les gens sous-estiment la deuxième couche : le token peut fonctionner parfaitement alors que la sécurité sous-jacente ou le MMF échoue encore économiquement. Le taux d’échec en chaîne et le taux d’échec des actifs ne correspondent pas au même risque.
Mon inquiétude principale est simple : après la cinquième migration, est-ce que DUSK pourra encore prouver la continuité aussi proprement qu’au premier jour ?
{future}(DUSKUSDT)
#dusk $DUSK @Dusk En examinant le modèle de sécurité confidentiel de DUSK, je me suis constamment heurté à un nombre ennuyeux : une sécurité sur 20 ans pourrait survivre à environ dix grands cycles logiciels si la pile change matériellement tous les deux ans.
Ce n’est pas seulement un problème de migration. C’est un problème de continuité de la propriété.
Imaginez 50 000 positions privées passant par un split d’actions. La revendication facile, c’est que chaque solde a été mis à jour. La norme plus exigeante est la suivante : la propriété totale avant doit être égale à la propriété totale après, en conservant chaque détenteur, sans divulguer qui possède quoi.
La même pression se retrouve dans les dividendes. 20 000 détenteurs payés chaque trimestre, cela fait 80 000 événements d’ayants droit par an. DUSK ne peut pas s’appuyer sur la visibilité publique comme peut le faire un registre transparent. Il lui faut une exactitude globale sans divulgation au niveau des détenteurs.
Cette distinction compte pour DUSK, car la confidentialité déplace la confiance de « tout le monde peut l’inspecter » vers « tout le monde peut vérifier la preuve ».
Et je pense que les gens sous-estiment la deuxième couche : le token peut fonctionner parfaitement alors que la sécurité sous-jacente ou le MMF échoue encore économiquement. Le taux d’échec en chaîne et le taux d’échec des actifs ne correspondent pas au même risque.
Mon inquiétude principale est simple : après la cinquième migration, est-ce que DUSK pourra encore prouver la continuité aussi proprement qu’au premier jour ?
Ce n’est pas seulement un problème de migration. C’est un problème de continuité de la propriété.
Imaginez 50 000 positions privées passant par un split d’actions. La revendication facile, c’est que chaque solde a été mis à jour. La norme plus exigeante est la suivante : la propriété totale avant doit être égale à la propriété totale après, en conservant chaque détenteur, sans divulguer qui possède quoi.
La même pression se retrouve dans les dividendes. 20 000 détenteurs payés chaque trimestre, cela fait 80 000 événements d’ayants droit par an. DUSK ne peut pas s’appuyer sur la visibilité publique comme peut le faire un registre transparent. Il lui faut une exactitude globale sans divulgation au niveau des détenteurs.
Cette distinction compte pour DUSK, car la confidentialité déplace la confiance de « tout le monde peut l’inspecter » vers « tout le monde peut vérifier la preuve ».
Et je pense que les gens sous-estiment la deuxième couche : le token peut fonctionner parfaitement alors que la sécurité sous-jacente ou le MMF échoue encore économiquement. Le taux d’échec en chaîne et le taux d’échec des actifs ne correspondent pas au même risque.
Mon inquiétude principale est simple : après la cinquième migration, est-ce que DUSK pourra encore prouver la continuité aussi proprement qu’au premier jour ?
30
24
4.2k
·
--
#dusk $DUSK @Dusk_Foundation En vérifiant où se situe réellement DUSK au sein d’un règlement sécurisé tokenisé, je revenais sans cesse à un découpage gênant : l’actif peut être natif, tandis que la branche “cash” peut encore dépendre d’un autre système.
Cela compte davantage qu’il n’y paraît au premier abord.
Mettre le titre sur DUSK peut simplifier la propriété, l’historique des transferts et l’état de conformité. Mais si le paiement continue de se régler via une banque ou un registre existant, quelqu’un doit encore rapprocher deux enregistrements, deux horodatages et potentiellement deux définitions du terme « final ».
La finalité de l’actif n’est pas la même chose que la finalité du règlement.
Le cas le plus difficile concerne la séquence. Le cash peut-il devenir irrévocable alors que le contrôle final de transfert-restriction n’est pas encore résolu ? Ou faut-il que la certitude de conformité passe d’abord, quitte à laisser la branche de paiement en attente ?
Pour DUSK, l’émission native d’actifs résout un problème d’enregistrement. Le cash natif ou tokenisé pourrait résoudre le second en plaçant les deux branches dans le même environnement de règlement, réduisant ainsi l’écart temporel entre la livraison et le paiement.
Mais le fait d’être « on-chain » à lui seul ne supprime pas tous les risques. L’exécution atomique dépend encore de la logique de conformité, de la qualité du cash et de la certitude quant au remboursement.
Je surveille si DUSK réduit le rapprochement lui-même, ou s’il déplace simplement la partie “actif” en avance pendant que la partie “paiement” reste ancienne.
{future}(DUSKUSDT)
#dusk $DUSK @Dusk En vérifiant où se situe réellement DUSK au sein d’un règlement sécurisé tokenisé, je revenais sans cesse à un découpage gênant : l’actif peut être natif, tandis que la branche “cash” peut encore dépendre d’un autre système.
Cela compte davantage qu’il n’y paraît au premier abord.
Mettre le titre sur DUSK peut simplifier la propriété, l’historique des transferts et l’état de conformité. Mais si le paiement continue de se régler via une banque ou un registre existant, quelqu’un doit encore rapprocher deux enregistrements, deux horodatages et potentiellement deux définitions du terme « final ».
La finalité de l’actif n’est pas la même chose que la finalité du règlement.
Le cas le plus difficile concerne la séquence. Le cash peut-il devenir irrévocable alors que le contrôle final de transfert-restriction n’est pas encore résolu ? Ou faut-il que la certitude de conformité passe d’abord, quitte à laisser la branche de paiement en attente ?
Pour DUSK, l’émission native d’actifs résout un problème d’enregistrement. Le cash natif ou tokenisé pourrait résoudre le second en plaçant les deux branches dans le même environnement de règlement, réduisant ainsi l’écart temporel entre la livraison et le paiement.
Mais le fait d’être « on-chain » à lui seul ne supprime pas tous les risques. L’exécution atomique dépend encore de la logique de conformité, de la qualité du cash et de la certitude quant au remboursement.
Je surveille si DUSK réduit le rapprochement lui-même, ou s’il déplace simplement la partie “actif” en avance pendant que la partie “paiement” reste ancienne.
Cela compte davantage qu’il n’y paraît au premier abord.
Mettre le titre sur DUSK peut simplifier la propriété, l’historique des transferts et l’état de conformité. Mais si le paiement continue de se régler via une banque ou un registre existant, quelqu’un doit encore rapprocher deux enregistrements, deux horodatages et potentiellement deux définitions du terme « final ».
La finalité de l’actif n’est pas la même chose que la finalité du règlement.
Le cas le plus difficile concerne la séquence. Le cash peut-il devenir irrévocable alors que le contrôle final de transfert-restriction n’est pas encore résolu ? Ou faut-il que la certitude de conformité passe d’abord, quitte à laisser la branche de paiement en attente ?
Pour DUSK, l’émission native d’actifs résout un problème d’enregistrement. Le cash natif ou tokenisé pourrait résoudre le second en plaçant les deux branches dans le même environnement de règlement, réduisant ainsi l’écart temporel entre la livraison et le paiement.
Mais le fait d’être « on-chain » à lui seul ne supprime pas tous les risques. L’exécution atomique dépend encore de la logique de conformité, de la qualité du cash et de la certitude quant au remboursement.
Je surveille si DUSK réduit le rapprochement lui-même, ou s’il déplace simplement la partie “actif” en avance pendant que la partie “paiement” reste ancienne.
81
52
20.1k
·
--
Je ne cessais de rester bloqué sur une seule petite question en retraçant comment une sécurité tokenisée se déplacerait réellement à travers DUSK après que le jeton a changé de portefeuille : quel enregistrement décide légalement qui est propriétaire de l’actif ?
Cela paraît basique, mais la tokenisation par wrapper peut dissimuler beaucoup d’infrastructures en dessous. Vous pouvez avoir un jeton DUSK tandis que les registres de conservation, les registres des actionnaires et les livres de règlement vivent encore dans trois systèmes distincts.
Donc le jeton circule vite. Le flux de travail, peut-être pas.
C’est à cet endroit que je pense que les gens confondent transfert on-chain et transfert de propriété. Une blockchain peut finaliser une transaction en quelques secondes environ, tandis que la réconciliation, les mises à jour de conservation, les vérifications d’éligibilité et le service de l’actif peuvent se poursuivre ailleurs pendant des heures, des jours, voire des années.
Pour DUSK, l’intégration au règlement peut compter davantage que le volume d’émission lui-même.
La comparaison qui m’intéresse est simple : l’offre de jetons versus la qualité du règlement. Dix mille jetons émis ne me disent presque rien si les transactions exigent encore plusieurs réconciliations par la suite. Les échecs de règlement pour 10 000 transactions me diraient bien plus.
La question la plus difficile est de savoir si DUSK devient la véritable source de vérité, ou simplement un autre enregistrement synchronisé à côté des systèmes hérités.
La finalité rapide est utile. Mais réduire le nombre d’enregistrements qui doivent être d’accord… c’est là que se trouve, je pense, le test le plus profond.
@Dusk_Foundation #dusk $DUSK
Je ne cessais de rester bloqué sur une seule petite question en retraçant comment une sécurité tokenisée se déplacerait réellement à travers DUSK après que le jeton a changé de portefeuille : quel enregistrement décide légalement qui est propriétaire de l’actif ?
Cela paraît basique, mais la tokenisation par wrapper peut dissimuler beaucoup d’infrastructures en dessous. Vous pouvez avoir un jeton DUSK tandis que les registres de conservation, les registres des actionnaires et les livres de règlement vivent encore dans trois systèmes distincts.
Donc le jeton circule vite. Le flux de travail, peut-être pas.
C’est à cet endroit que je pense que les gens confondent transfert on-chain et transfert de propriété. Une blockchain peut finaliser une transaction en quelques secondes environ, tandis que la réconciliation, les mises à jour de conservation, les vérifications d’éligibilité et le service de l’actif peuvent se poursuivre ailleurs pendant des heures, des jours, voire des années.
Pour DUSK, l’intégration au règlement peut compter davantage que le volume d’émission lui-même.
La comparaison qui m’intéresse est simple : l’offre de jetons versus la qualité du règlement. Dix mille jetons émis ne me disent presque rien si les transactions exigent encore plusieurs réconciliations par la suite. Les échecs de règlement pour 10 000 transactions me diraient bien plus.
La question la plus difficile est de savoir si DUSK devient la véritable source de vérité, ou simplement un autre enregistrement synchronisé à côté des systèmes hérités.
La finalité rapide est utile. Mais réduire le nombre d’enregistrements qui doivent être d’accord… c’est là que se trouve, je pense, le test le plus profond.
@Dusk #dusk $DUSK
Cela paraît basique, mais la tokenisation par wrapper peut dissimuler beaucoup d’infrastructures en dessous. Vous pouvez avoir un jeton DUSK tandis que les registres de conservation, les registres des actionnaires et les livres de règlement vivent encore dans trois systèmes distincts.
Donc le jeton circule vite. Le flux de travail, peut-être pas.
C’est à cet endroit que je pense que les gens confondent transfert on-chain et transfert de propriété. Une blockchain peut finaliser une transaction en quelques secondes environ, tandis que la réconciliation, les mises à jour de conservation, les vérifications d’éligibilité et le service de l’actif peuvent se poursuivre ailleurs pendant des heures, des jours, voire des années.
Pour DUSK, l’intégration au règlement peut compter davantage que le volume d’émission lui-même.
La comparaison qui m’intéresse est simple : l’offre de jetons versus la qualité du règlement. Dix mille jetons émis ne me disent presque rien si les transactions exigent encore plusieurs réconciliations par la suite. Les échecs de règlement pour 10 000 transactions me diraient bien plus.
La question la plus difficile est de savoir si DUSK devient la véritable source de vérité, ou simplement un autre enregistrement synchronisé à côté des systèmes hérités.
La finalité rapide est utile. Mais réduire le nombre d’enregistrements qui doivent être d’accord… c’est là que se trouve, je pense, le test le plus profond.
@Dusk #dusk $DUSK
34
29
8.3k
·
--
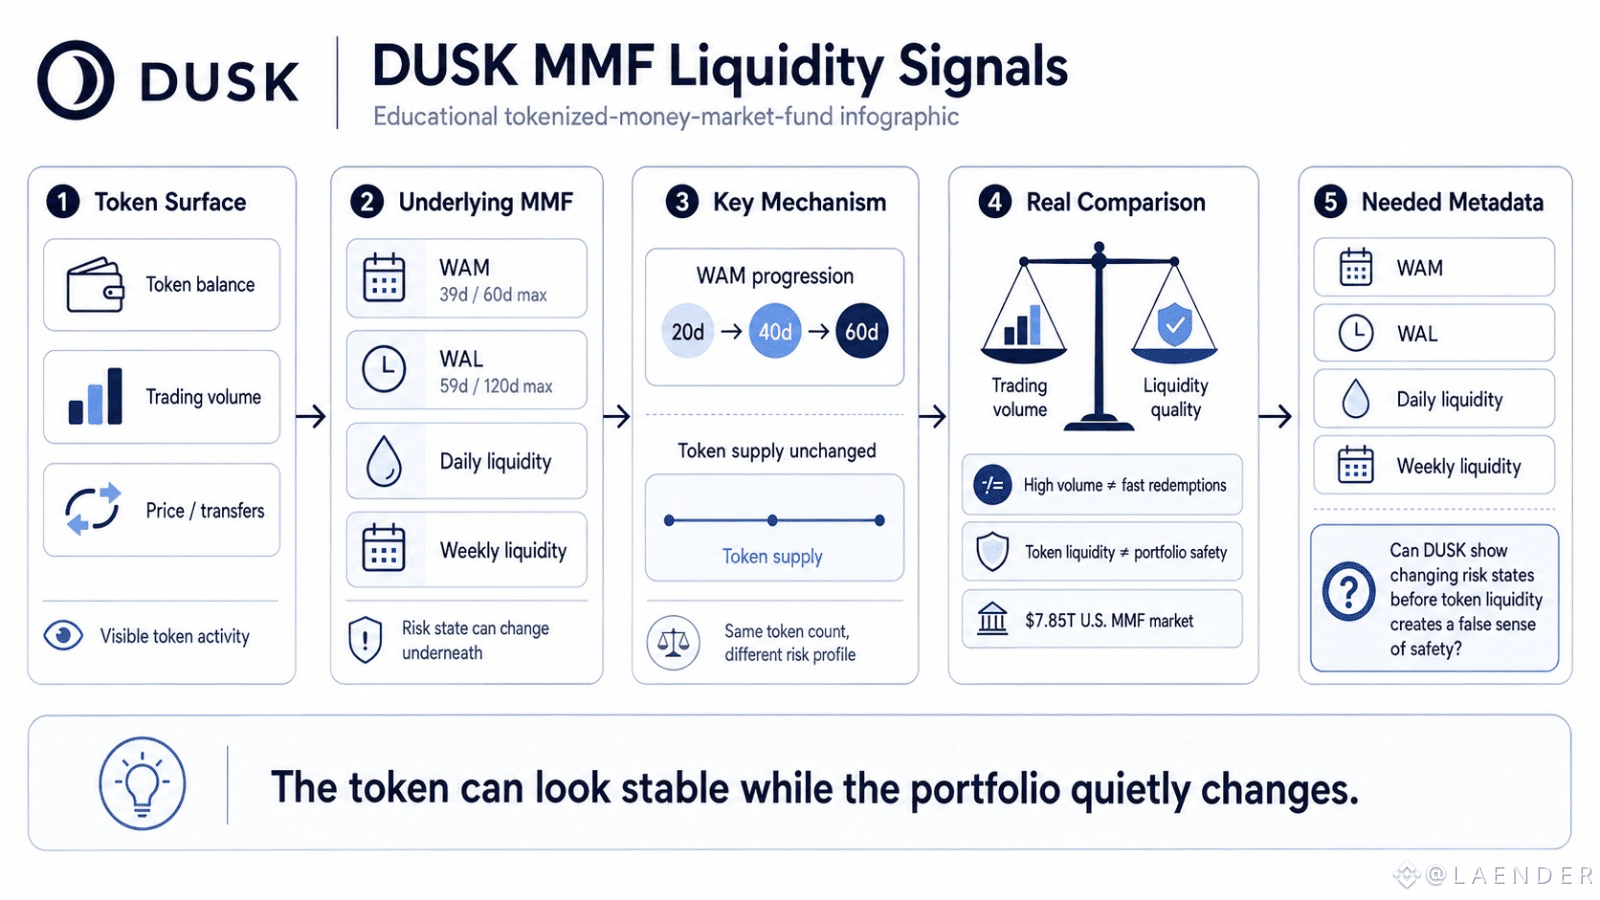
Lors de ma revue des indicateurs de liquidité du MMF avec l’activité de négociation des tokens, j’ai remarqué quelque chose de facile à manquer : le solde du token peut rester stable pendant que le portefeuille, lui, devient discrètement plus risqué.
Un MMF de premier plan peut se situer autour de 39 jours de WAM par rapport à une limite de 60 jours, avec un WAL proche de 59 jours contre un plafond de 120 jours. Si le WAM passe de 20 à 40 puis à 60 jours, la quantité de tokens DUSK ne doit pas forcément changer du tout. C’est l’état de risque qui, lui, change.
C’est pourquoi je pense que la qualité de la liquidité par rapport au volume de négociation est la meilleure comparaison ici.
Pour DUSK, un token de MMF fortement échangé pourrait néanmoins représenter un portefeuille qui se rapproche de ses contraintes de duration ou de liquidité. Un volume secondaire élevé indique que les utilisateurs peuvent échanger le token. Cela dit beaucoup moins de choses sur la rapidité avec laquelle le fonds sous-jacent peut satisfaire les demandes de rachat.
Cela compte dans un marché qui détient environ 7,85 T$ d’actifs de MMF américains. La tokenisation « type cash » n’a pas le même profil de pression que la tokenisation d’obligations classique.
Ce que je voudrais de la part de DUSK, c’est des métadonnées de risque on-chain compactes : WAM, WAL, liquidité quotidienne et liquidité hebdomadaire, sans exposer chaque position du portefeuille.
La question inconfortable est de savoir si DUSK peut rendre visibles ces états de risque changeants avant que la liquidité du token ne donne aux utilisateurs un faux sentiment de sécurité.
{future}(DUSKUSDT)
@Dusk_Foundation #dusk $DUSK
Lors de ma revue des indicateurs de liquidité du MMF avec l’activité de négociation des tokens, j’ai remarqué quelque chose de facile à manquer : le solde du token peut rester stable pendant que le portefeuille, lui, devient discrètement plus risqué.
Un MMF de premier plan peut se situer autour de 39 jours de WAM par rapport à une limite de 60 jours, avec un WAL proche de 59 jours contre un plafond de 120 jours. Si le WAM passe de 20 à 40 puis à 60 jours, la quantité de tokens DUSK ne doit pas forcément changer du tout. C’est l’état de risque qui, lui, change.
C’est pourquoi je pense que la qualité de la liquidité par rapport au volume de négociation est la meilleure comparaison ici.
Pour DUSK, un token de MMF fortement échangé pourrait néanmoins représenter un portefeuille qui se rapproche de ses contraintes de duration ou de liquidité. Un volume secondaire élevé indique que les utilisateurs peuvent échanger le token. Cela dit beaucoup moins de choses sur la rapidité avec laquelle le fonds sous-jacent peut satisfaire les demandes de rachat.
Cela compte dans un marché qui détient environ 7,85 T$ d’actifs de MMF américains. La tokenisation « type cash » n’a pas le même profil de pression que la tokenisation d’obligations classique.
Ce que je voudrais de la part de DUSK, c’est des métadonnées de risque on-chain compactes : WAM, WAL, liquidité quotidienne et liquidité hebdomadaire, sans exposer chaque position du portefeuille.
La question inconfortable est de savoir si DUSK peut rendre visibles ces états de risque changeants avant que la liquidité du token ne donne aux utilisateurs un faux sentiment de sécurité.
@Dusk #dusk $DUSK
Un MMF de premier plan peut se situer autour de 39 jours de WAM par rapport à une limite de 60 jours, avec un WAL proche de 59 jours contre un plafond de 120 jours. Si le WAM passe de 20 à 40 puis à 60 jours, la quantité de tokens DUSK ne doit pas forcément changer du tout. C’est l’état de risque qui, lui, change.
C’est pourquoi je pense que la qualité de la liquidité par rapport au volume de négociation est la meilleure comparaison ici.
Pour DUSK, un token de MMF fortement échangé pourrait néanmoins représenter un portefeuille qui se rapproche de ses contraintes de duration ou de liquidité. Un volume secondaire élevé indique que les utilisateurs peuvent échanger le token. Cela dit beaucoup moins de choses sur la rapidité avec laquelle le fonds sous-jacent peut satisfaire les demandes de rachat.
Cela compte dans un marché qui détient environ 7,85 T$ d’actifs de MMF américains. La tokenisation « type cash » n’a pas le même profil de pression que la tokenisation d’obligations classique.
Ce que je voudrais de la part de DUSK, c’est des métadonnées de risque on-chain compactes : WAM, WAL, liquidité quotidienne et liquidité hebdomadaire, sans exposer chaque position du portefeuille.
La question inconfortable est de savoir si DUSK peut rendre visibles ces états de risque changeants avant que la liquidité du token ne donne aux utilisateurs un faux sentiment de sécurité.
@Dusk #dusk $DUSK
49
31
14.4k
·
--
Vérifié
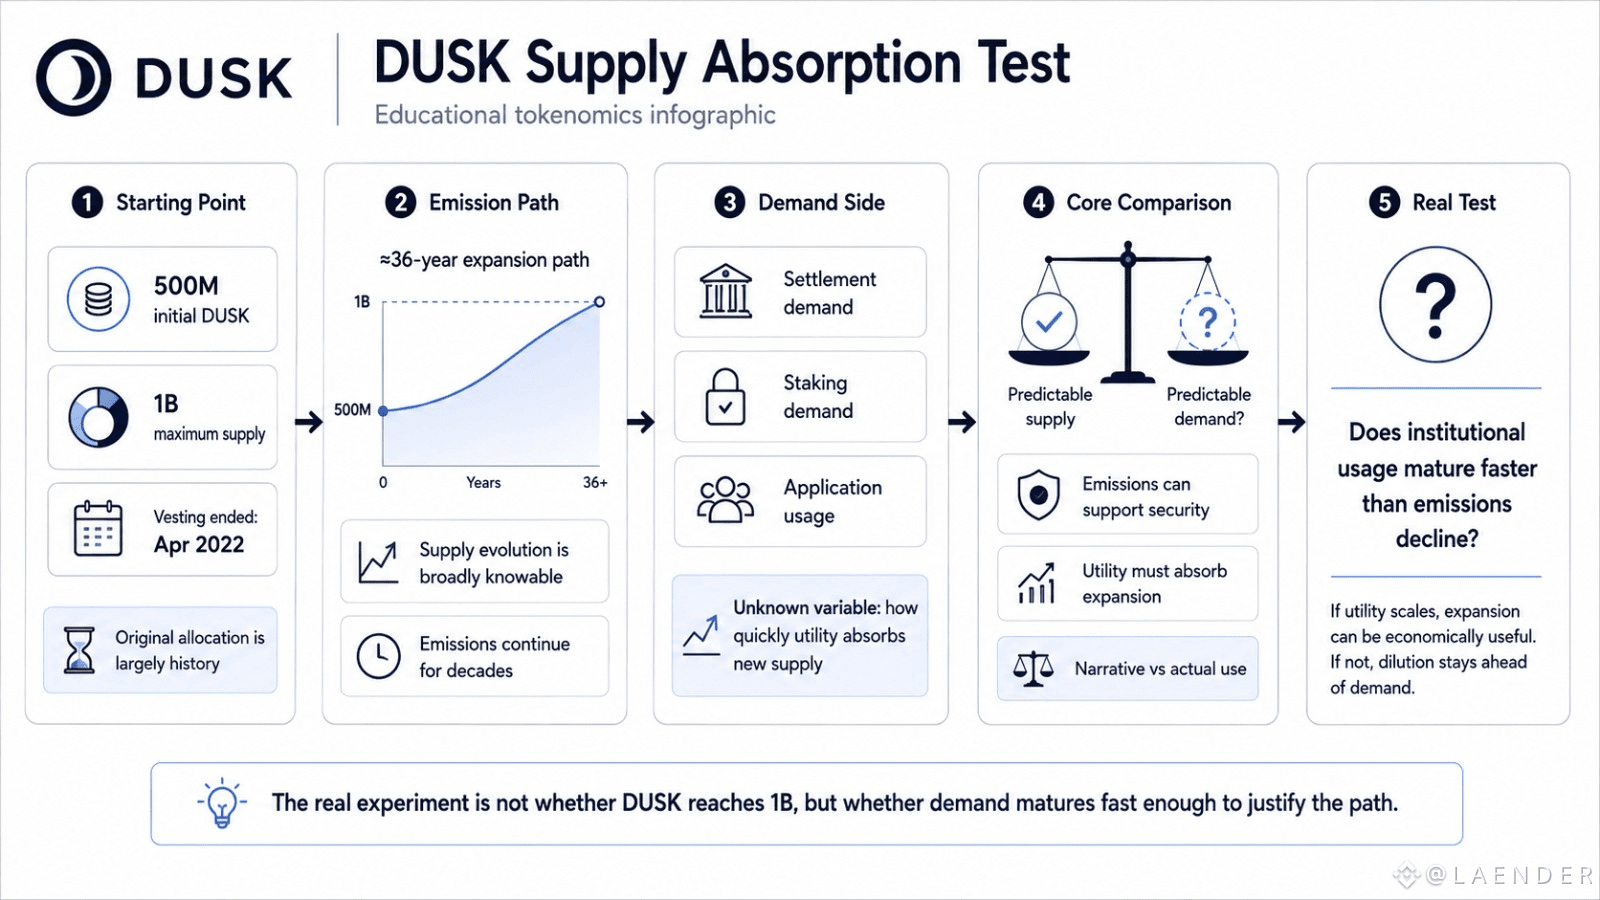
Je suis resté à fixer la courbe d’offre de DUSK et j’ai réalisé l’évidence : le chiffre maximum de 1 milliard d’unités en offre est probablement la partie la moins intéressante.
La partie difficile, c’est la manière dont les deuxièmes 500 millions sont absorbés.
L’allocation initiale relève largement de l’histoire. L’acquisition des droits a pris fin en 2022. Mais les émissions de DUSK continuent d’étendre l’offre sur une période bien plus longue, transformant les quelques décennies à venir en test de la demande plutôt qu’en simple récit d’acquisition des droits.
Cela change ce que j’observe.
De nouveaux jetons sont-ils absorbés parce que DUSK gagne une utilité réelle, ou simplement parce que les détenteurs existants acceptent la dilution ? L’activité institutionnelle progresse-t-elle plus vite que les émissions ne diminuent ? Et si l’usage arrive tôt, la demande de jetons se met-elle réellement à croître avec lui ?
Une partie de l’expansion de l’offre est normale. Les réseaux ont besoin d’incitations pour les validateurs, de budgets de sécurité et de temps pour mûrir. Je ne considérerais pas chaque nouveau jeton comme une faiblesse économique.
Mais une offre prévisible ne signifie pas une demande prévisible.
C’est la partie inconfortable. Les détenteurs de DUSK peuvent, à peu près, modéliser l’évolution de l’offre. Personne ne peut modéliser avec la même confiance la rapidité à laquelle la demande de règlement, la demande de mise en jeu (staking) et l’usage des applications vont croître.
Pour moi, c’est le véritable test sur 36 ans : pas de savoir si DUSK atteint 1 milliard de jetons, mais si l’utilité mûrit assez vite pour rendre cette expansion économiquement utile.
{future}(DUSKUSDT)
@Dusk_Foundation #dusk $DUSK
Je suis resté à fixer la courbe d’offre de DUSK et j’ai réalisé l’évidence : le chiffre maximum de 1 milliard d’unités en offre est probablement la partie la moins intéressante.
La partie difficile, c’est la manière dont les deuxièmes 500 millions sont absorbés.
L’allocation initiale relève largement de l’histoire. L’acquisition des droits a pris fin en 2022. Mais les émissions de DUSK continuent d’étendre l’offre sur une période bien plus longue, transformant les quelques décennies à venir en test de la demande plutôt qu’en simple récit d’acquisition des droits.
Cela change ce que j’observe.
De nouveaux jetons sont-ils absorbés parce que DUSK gagne une utilité réelle, ou simplement parce que les détenteurs existants acceptent la dilution ? L’activité institutionnelle progresse-t-elle plus vite que les émissions ne diminuent ? Et si l’usage arrive tôt, la demande de jetons se met-elle réellement à croître avec lui ?
Une partie de l’expansion de l’offre est normale. Les réseaux ont besoin d’incitations pour les validateurs, de budgets de sécurité et de temps pour mûrir. Je ne considérerais pas chaque nouveau jeton comme une faiblesse économique.
Mais une offre prévisible ne signifie pas une demande prévisible.
C’est la partie inconfortable. Les détenteurs de DUSK peuvent, à peu près, modéliser l’évolution de l’offre. Personne ne peut modéliser avec la même confiance la rapidité à laquelle la demande de règlement, la demande de mise en jeu (staking) et l’usage des applications vont croître.
Pour moi, c’est le véritable test sur 36 ans : pas de savoir si DUSK atteint 1 milliard de jetons, mais si l’utilité mûrit assez vite pour rendre cette expansion économiquement utile.
@Dusk #dusk $DUSK
La partie difficile, c’est la manière dont les deuxièmes 500 millions sont absorbés.
L’allocation initiale relève largement de l’histoire. L’acquisition des droits a pris fin en 2022. Mais les émissions de DUSK continuent d’étendre l’offre sur une période bien plus longue, transformant les quelques décennies à venir en test de la demande plutôt qu’en simple récit d’acquisition des droits.
Cela change ce que j’observe.
De nouveaux jetons sont-ils absorbés parce que DUSK gagne une utilité réelle, ou simplement parce que les détenteurs existants acceptent la dilution ? L’activité institutionnelle progresse-t-elle plus vite que les émissions ne diminuent ? Et si l’usage arrive tôt, la demande de jetons se met-elle réellement à croître avec lui ?
Une partie de l’expansion de l’offre est normale. Les réseaux ont besoin d’incitations pour les validateurs, de budgets de sécurité et de temps pour mûrir. Je ne considérerais pas chaque nouveau jeton comme une faiblesse économique.
Mais une offre prévisible ne signifie pas une demande prévisible.
C’est la partie inconfortable. Les détenteurs de DUSK peuvent, à peu près, modéliser l’évolution de l’offre. Personne ne peut modéliser avec la même confiance la rapidité à laquelle la demande de règlement, la demande de mise en jeu (staking) et l’usage des applications vont croître.
Pour moi, c’est le véritable test sur 36 ans : pas de savoir si DUSK atteint 1 milliard de jetons, mais si l’utilité mûrit assez vite pour rendre cette expansion économiquement utile.
@Dusk #dusk $DUSK
75
34
13k
·
--
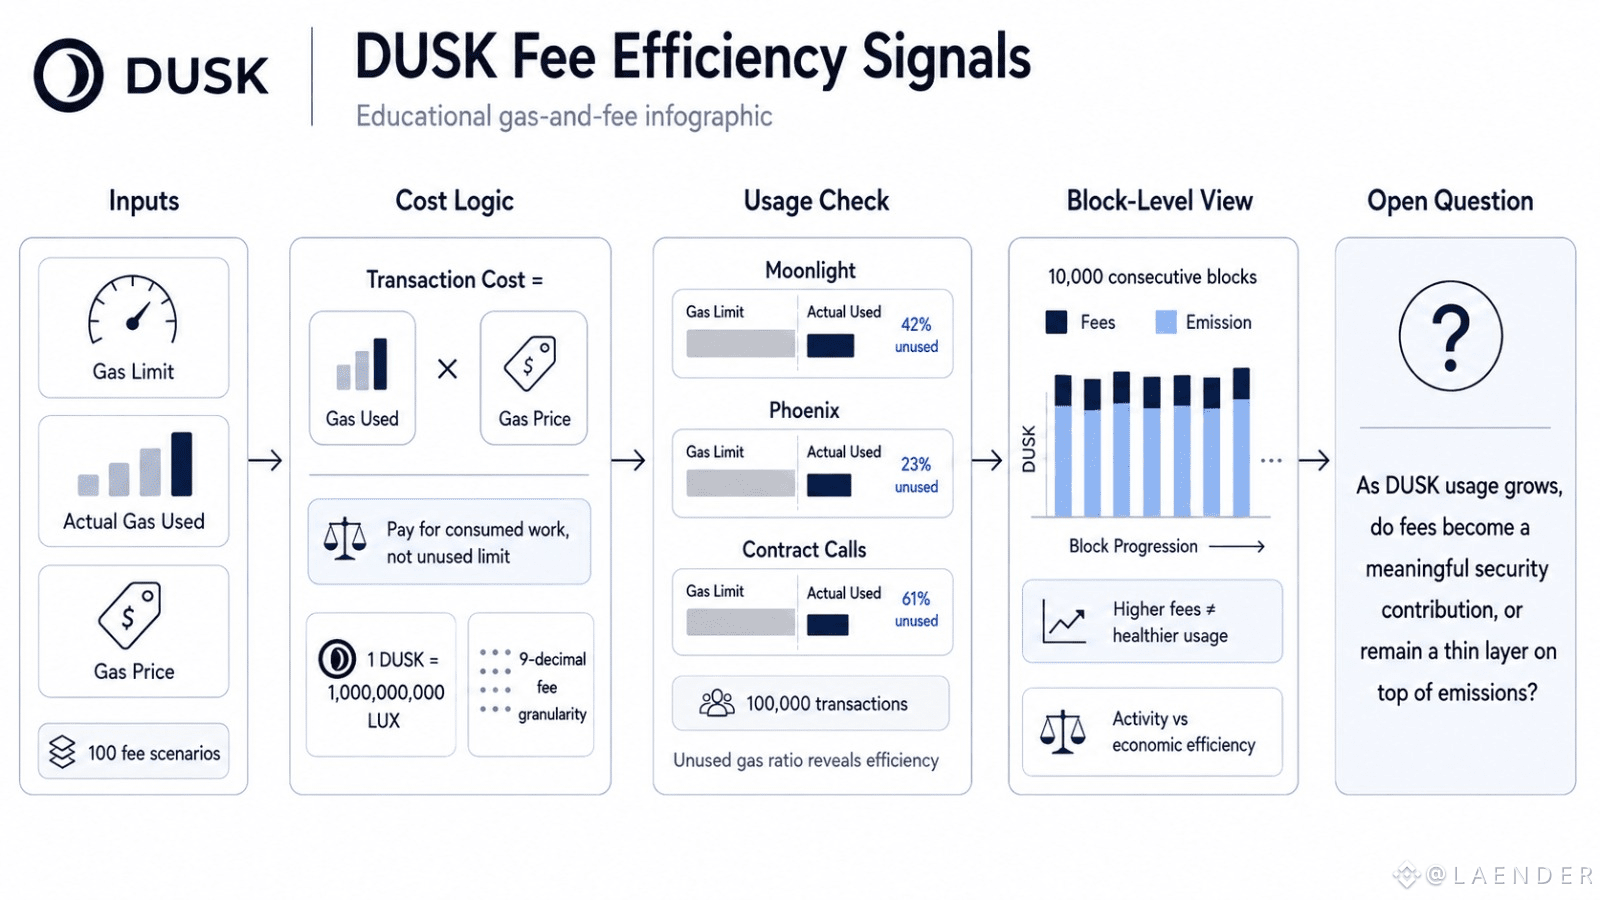
En creusant la comptabilité des frais sur DUSK, j’ai remarqué que le prix du gaz affiché en tête ne me dit presque rien, à moins de le rapprocher du gaz réellement consommé.
Cela devient plus clair sur 100 scénarios de frais. Une transaction peut embarquer une limite de gaz généreuse, mais ne payer que pour le travail qu’elle effectue réellement. Ainsi, la métrique utile n’est pas la limite seule, mais le gaz effectivement consommé × le prix du gaz, puis le ratio de gaz non utilisé autour de cette valeur.
DUSK devient aussi intéressant à la plus petite unité. Avec 1 DUSK divisé en 1 milliard de LUX, les frais peuvent bouger avec une précision à 9 décimales. Cela peut sembler anodin, mais la granularité compte quand des milliers de transactions peu coûteuses commencent à s’empiler.
Ce que je surveillerais, c’est Moonlight vs
Phoenix vs les appels de contrat sur 100,000 transactions. Si un type réserve systématiquement bien plus de gaz qu’il n’en utilise, c’est un signal discret d’efficacité.
On peut aussi mal interpréter les revenus de frais. Un bloc qui génère plus via les frais ne signifie pas automatiquement une utilisation plus saine si la majorité des récompenses provient encore de l’émission.
Pour DUSK, la vraie comparaison est celle entre l’activité du protocole et l’efficacité économique.
Mon doute est simple : à mesure que l’utilisation de DUSK augmente, les frais deviennent-ils une contribution significative à la sécurité, ou bien ne sont-ils qu’une fine couche posée au-dessus des émissions ?
@Dusk_Foundation #dusk $DUSK
{future}(DUSKUSDT)
En creusant la comptabilité des frais sur DUSK, j’ai remarqué que le prix du gaz affiché en tête ne me dit presque rien, à moins de le rapprocher du gaz réellement consommé.
Cela devient plus clair sur 100 scénarios de frais. Une transaction peut embarquer une limite de gaz généreuse, mais ne payer que pour le travail qu’elle effectue réellement. Ainsi, la métrique utile n’est pas la limite seule, mais le gaz effectivement consommé × le prix du gaz, puis le ratio de gaz non utilisé autour de cette valeur.
DUSK devient aussi intéressant à la plus petite unité. Avec 1 DUSK divisé en 1 milliard de LUX, les frais peuvent bouger avec une précision à 9 décimales. Cela peut sembler anodin, mais la granularité compte quand des milliers de transactions peu coûteuses commencent à s’empiler.
Ce que je surveillerais, c’est Moonlight vs
Phoenix vs les appels de contrat sur 100,000 transactions. Si un type réserve systématiquement bien plus de gaz qu’il n’en utilise, c’est un signal discret d’efficacité.
On peut aussi mal interpréter les revenus de frais. Un bloc qui génère plus via les frais ne signifie pas automatiquement une utilisation plus saine si la majorité des récompenses provient encore de l’émission.
Pour DUSK, la vraie comparaison est celle entre l’activité du protocole et l’efficacité économique.
Mon doute est simple : à mesure que l’utilisation de DUSK augmente, les frais deviennent-ils une contribution significative à la sécurité, ou bien ne sont-ils qu’une fine couche posée au-dessus des émissions ?
@Dusk #dusk $DUSK
Cela devient plus clair sur 100 scénarios de frais. Une transaction peut embarquer une limite de gaz généreuse, mais ne payer que pour le travail qu’elle effectue réellement. Ainsi, la métrique utile n’est pas la limite seule, mais le gaz effectivement consommé × le prix du gaz, puis le ratio de gaz non utilisé autour de cette valeur.
DUSK devient aussi intéressant à la plus petite unité. Avec 1 DUSK divisé en 1 milliard de LUX, les frais peuvent bouger avec une précision à 9 décimales. Cela peut sembler anodin, mais la granularité compte quand des milliers de transactions peu coûteuses commencent à s’empiler.
Ce que je surveillerais, c’est Moonlight vs
Phoenix vs les appels de contrat sur 100,000 transactions. Si un type réserve systématiquement bien plus de gaz qu’il n’en utilise, c’est un signal discret d’efficacité.
On peut aussi mal interpréter les revenus de frais. Un bloc qui génère plus via les frais ne signifie pas automatiquement une utilisation plus saine si la majorité des récompenses provient encore de l’émission.
Pour DUSK, la vraie comparaison est celle entre l’activité du protocole et l’efficacité économique.
Mon doute est simple : à mesure que l’utilisation de DUSK augmente, les frais deviennent-ils une contribution significative à la sécurité, ou bien ne sont-ils qu’une fine couche posée au-dessus des émissions ?
@Dusk #dusk $DUSK
23
26
10.7k
·
--
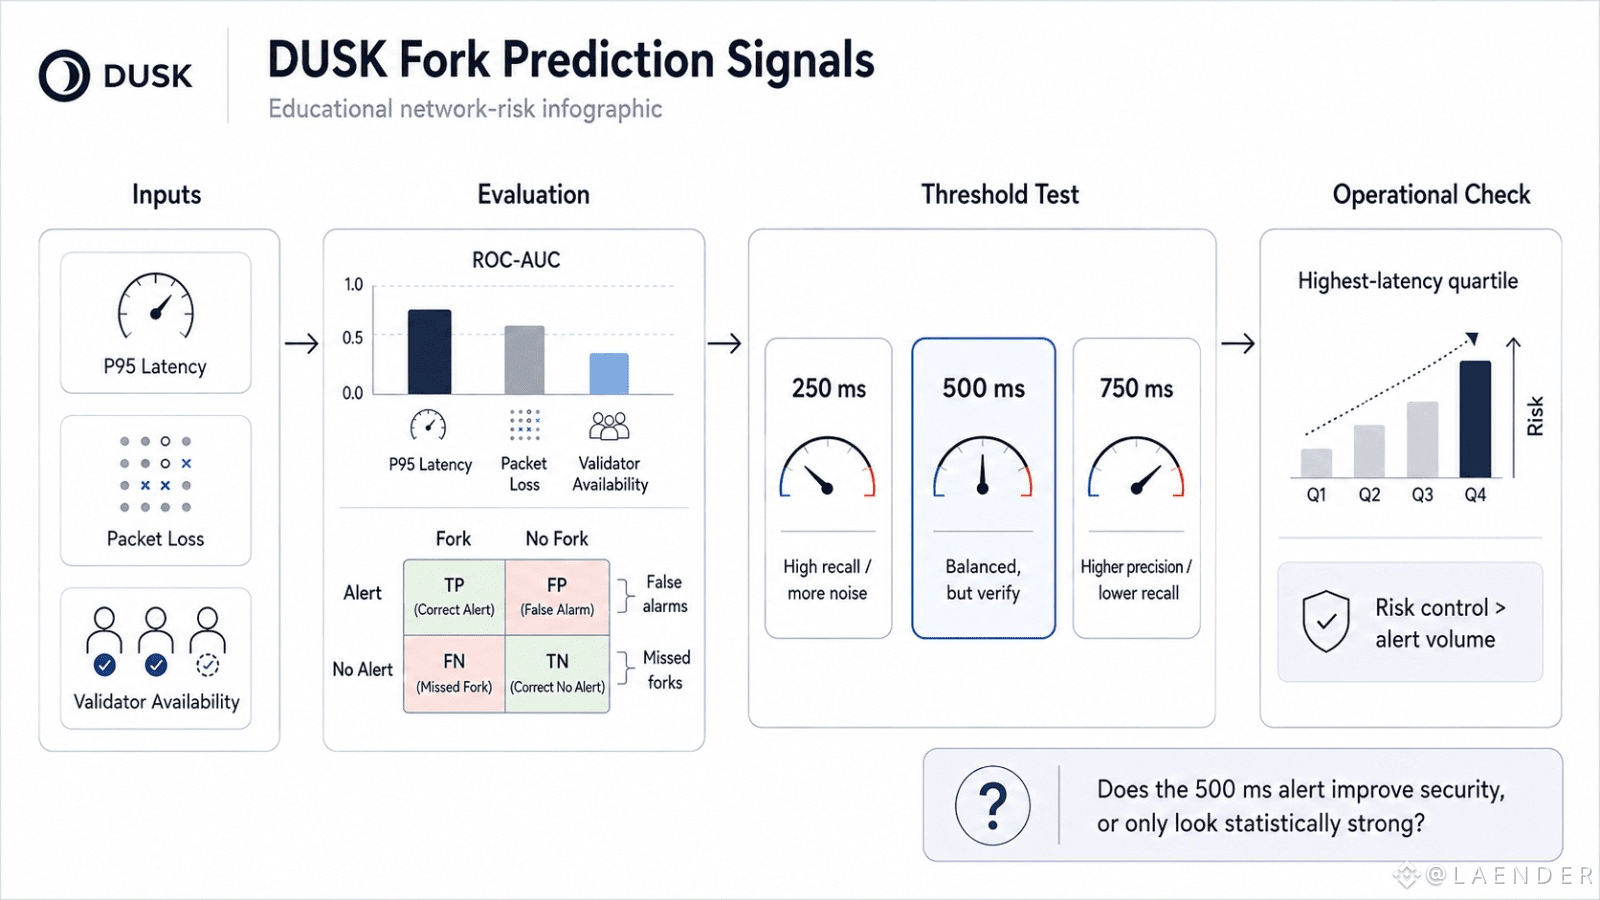
J’ai observé quelque chose en triant les tests de forks DUSK par le délai réseau P95. L’alerte de 500 ms semblait utile jusqu’à ce que je vérifie ce qu’elle détectait réellement.
Un seuil peut sembler précis tout en restant un faible prédicteur.
Pour DUSK Network, je ne jugerais pas uniquement la latence. Le ROC-AUC sur le délai P95, la perte de paquets et la disponibilité des validateurs compte, car chaque signal peut séparer différemment les rounds avec fork et sans fork. Ensuite, la matrice de confusion montre la partie que l’AUC peut masquer : fausses alertes, forks manqués, et à quelle fréquence un round à haut risque s’est en réalité révélé inoffensif.
Le seuil de 250 ms peut capter davantage d’événements de fork, mais inonder le système de bruit. À 750 ms, la précision peut s’améliorer tandis que le rappel s’effondre. La ligne des 500 ms se situe entre les deux, mais « équilibré » n’est pas automatiquement utile.
Ce qui compte pour DUSK, c’est le contrôle du risque par rapport au volume d’alertes, pas la latence contre l’absence de latence.
Je surveillerais aussi la hausse du risque de fork dans le quartile de latence le plus élevé. Si ce groupe ne montre pas une concentration significative de forks, la latence peut être corrélée, mais opérationnellement faible.
Mon doute discret est simple : la sécurité du token DUSK s’améliore-t-elle parce que l’alerte est statistiquement bonne, ou seulement lorsqu’elle détecte les rares événements qui comptent vraiment ?
{future}(DUSKUSDT)
@Dusk_Foundation #dusk $DUSK
J’ai observé quelque chose en triant les tests de forks DUSK par le délai réseau P95. L’alerte de 500 ms semblait utile jusqu’à ce que je vérifie ce qu’elle détectait réellement.
Un seuil peut sembler précis tout en restant un faible prédicteur.
Pour DUSK Network, je ne jugerais pas uniquement la latence. Le ROC-AUC sur le délai P95, la perte de paquets et la disponibilité des validateurs compte, car chaque signal peut séparer différemment les rounds avec fork et sans fork. Ensuite, la matrice de confusion montre la partie que l’AUC peut masquer : fausses alertes, forks manqués, et à quelle fréquence un round à haut risque s’est en réalité révélé inoffensif.
Le seuil de 250 ms peut capter davantage d’événements de fork, mais inonder le système de bruit. À 750 ms, la précision peut s’améliorer tandis que le rappel s’effondre. La ligne des 500 ms se situe entre les deux, mais « équilibré » n’est pas automatiquement utile.
Ce qui compte pour DUSK, c’est le contrôle du risque par rapport au volume d’alertes, pas la latence contre l’absence de latence.
Je surveillerais aussi la hausse du risque de fork dans le quartile de latence le plus élevé. Si ce groupe ne montre pas une concentration significative de forks, la latence peut être corrélée, mais opérationnellement faible.
Mon doute discret est simple : la sécurité du token DUSK s’améliore-t-elle parce que l’alerte est statistiquement bonne, ou seulement lorsqu’elle détecte les rares événements qui comptent vraiment ?
@Dusk #dusk $DUSK
Un seuil peut sembler précis tout en restant un faible prédicteur.
Pour DUSK Network, je ne jugerais pas uniquement la latence. Le ROC-AUC sur le délai P95, la perte de paquets et la disponibilité des validateurs compte, car chaque signal peut séparer différemment les rounds avec fork et sans fork. Ensuite, la matrice de confusion montre la partie que l’AUC peut masquer : fausses alertes, forks manqués, et à quelle fréquence un round à haut risque s’est en réalité révélé inoffensif.
Le seuil de 250 ms peut capter davantage d’événements de fork, mais inonder le système de bruit. À 750 ms, la précision peut s’améliorer tandis que le rappel s’effondre. La ligne des 500 ms se situe entre les deux, mais « équilibré » n’est pas automatiquement utile.
Ce qui compte pour DUSK, c’est le contrôle du risque par rapport au volume d’alertes, pas la latence contre l’absence de latence.
Je surveillerais aussi la hausse du risque de fork dans le quartile de latence le plus élevé. Si ce groupe ne montre pas une concentration significative de forks, la latence peut être corrélée, mais opérationnellement faible.
Mon doute discret est simple : la sécurité du token DUSK s’améliore-t-elle parce que l’alerte est statistiquement bonne, ou seulement lorsqu’elle détecte les rares événements qui comptent vraiment ?
@Dusk #dusk $DUSK
26
17
1k
·
--
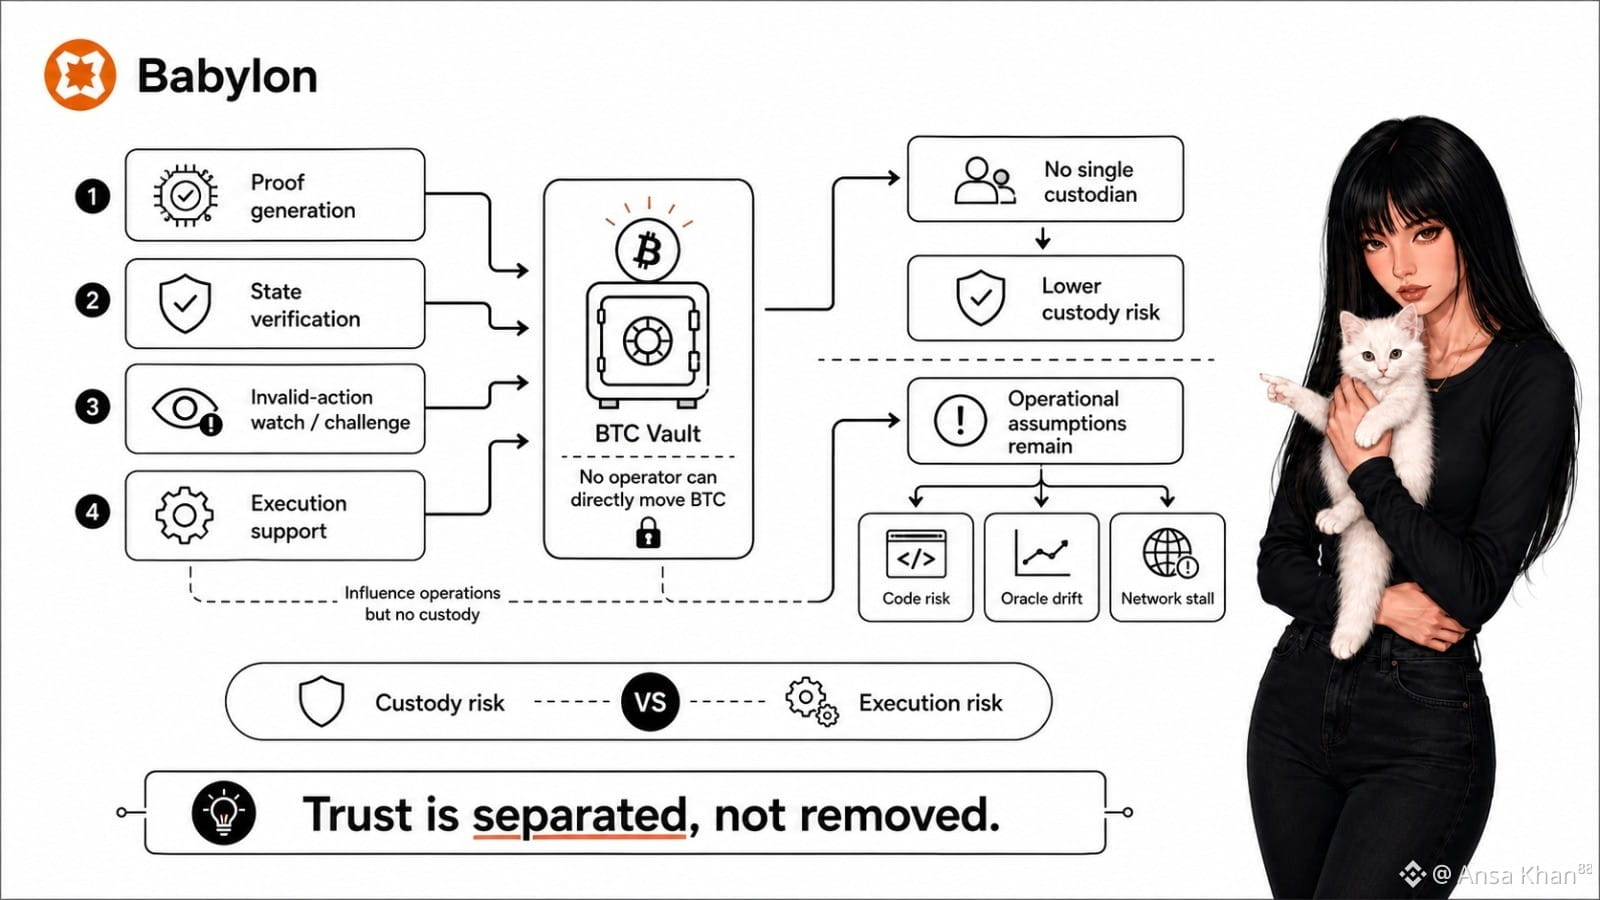
J’ai d’abord remarqué le modèle de confiance de Babylon à partir de la question de la garde : quel opérateur peut réellement déplacer le BTC ?
La réponse évidente est qu’aucun des quatre groupes. Mais ce n’est que la surface.
Le comportement caché, c’est la manière dont Babylon divise l’influence. Un groupe génère des preuves, un autre vérifie l’état, un autre surveille les actions invalides, et un autre prend en charge l’exécution. Aucun des quatre groupes ne possède l’actif, pourtant ils comptent tous sur le plan opérationnel. La confiance n’a pas disparu. Elle est réduite, cloisonnée et rendue plus facile à contester.
Cette distinction compte pour BABY, car le risque de garde et le risque d’exécution ne sont pas les mêmes. Remplacer un gardien puissant par quatre rôles contraints réduit la probabilité qu’une approbation humaine se transforme en événement de perte. Pourtant, le code peut échouer.
Les oracles peuvent dériver. Les réseaux peuvent se bloquer.
Une certaine dépendance est normale. Un système en production a besoin d’acteurs, d’infrastructures et de coordination.
Le vrai test, c’est la promesse technique face à la résilience opérationnelle. Une preuve incorrecte peut-elle être contestée avant de modifier la réalité économique ?
Babylon peut-elle rester sûre quand un groupe d’opérateurs est retardé, mal configuré ou hors ligne ? Et qui s’en aperçoit en premier lorsque les hypothèses commencent à s’empiler ?
Je vois la force de conception. Je continue de surveiller si BABY limite le pouvoir des acteurs sous contrainte, pas seulement sur le papier.
{future}(BABYUSDT)
@babylonlabs_io #baby $BABY
J’ai d’abord remarqué le modèle de confiance de Babylon à partir de la question de la garde : quel opérateur peut réellement déplacer le BTC ?
La réponse évidente est qu’aucun des quatre groupes. Mais ce n’est que la surface.
Le comportement caché, c’est la manière dont Babylon divise l’influence. Un groupe génère des preuves, un autre vérifie l’état, un autre surveille les actions invalides, et un autre prend en charge l’exécution. Aucun des quatre groupes ne possède l’actif, pourtant ils comptent tous sur le plan opérationnel. La confiance n’a pas disparu. Elle est réduite, cloisonnée et rendue plus facile à contester.
Cette distinction compte pour BABY, car le risque de garde et le risque d’exécution ne sont pas les mêmes. Remplacer un gardien puissant par quatre rôles contraints réduit la probabilité qu’une approbation humaine se transforme en événement de perte. Pourtant, le code peut échouer.
Les oracles peuvent dériver. Les réseaux peuvent se bloquer.
Une certaine dépendance est normale. Un système en production a besoin d’acteurs, d’infrastructures et de coordination.
Le vrai test, c’est la promesse technique face à la résilience opérationnelle. Une preuve incorrecte peut-elle être contestée avant de modifier la réalité économique ?
Babylon peut-elle rester sûre quand un groupe d’opérateurs est retardé, mal configuré ou hors ligne ? Et qui s’en aperçoit en premier lorsque les hypothèses commencent à s’empiler ?
Je vois la force de conception. Je continue de surveiller si BABY limite le pouvoir des acteurs sous contrainte, pas seulement sur le papier.
@BabylonLabs_io #baby $BABY
La réponse évidente est qu’aucun des quatre groupes. Mais ce n’est que la surface.
Le comportement caché, c’est la manière dont Babylon divise l’influence. Un groupe génère des preuves, un autre vérifie l’état, un autre surveille les actions invalides, et un autre prend en charge l’exécution. Aucun des quatre groupes ne possède l’actif, pourtant ils comptent tous sur le plan opérationnel. La confiance n’a pas disparu. Elle est réduite, cloisonnée et rendue plus facile à contester.
Cette distinction compte pour BABY, car le risque de garde et le risque d’exécution ne sont pas les mêmes. Remplacer un gardien puissant par quatre rôles contraints réduit la probabilité qu’une approbation humaine se transforme en événement de perte. Pourtant, le code peut échouer.
Les oracles peuvent dériver. Les réseaux peuvent se bloquer.
Une certaine dépendance est normale. Un système en production a besoin d’acteurs, d’infrastructures et de coordination.
Le vrai test, c’est la promesse technique face à la résilience opérationnelle. Une preuve incorrecte peut-elle être contestée avant de modifier la réalité économique ?
Babylon peut-elle rester sûre quand un groupe d’opérateurs est retardé, mal configuré ou hors ligne ? Et qui s’en aperçoit en premier lorsque les hypothèses commencent à s’empiler ?
Je vois la force de conception. Je continue de surveiller si BABY limite le pouvoir des acteurs sous contrainte, pas seulement sur le papier.
@BabylonLabs_io #baby $BABY
72
56
8.8k
·
--
Vérifié
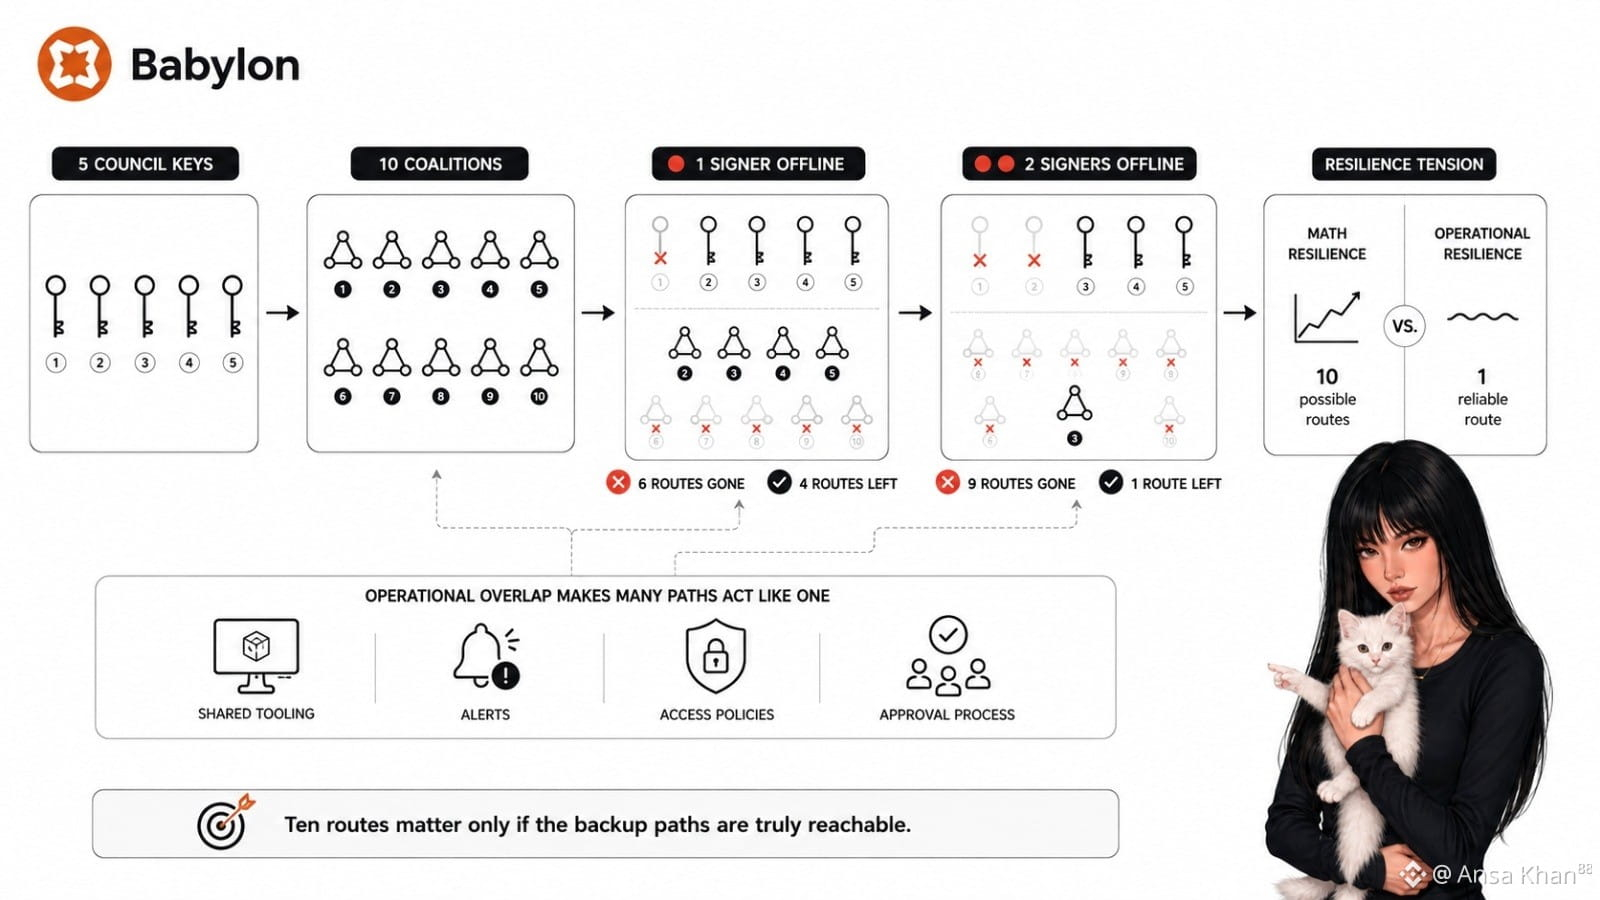
J’ai vu le conseil 3-sur-5 de Babylone à partir du numéro en titre : dix coalitions d’approbation. Puis j’ai retiré une clé, et six routes ont disparu.
Le point évident est que le quorum fonctionne encore. Quatre combinaisons restent. Ce n’est pas là le vrai problème.
Le comportement caché est de savoir si les opérateurs de BABY peuvent basculer entre ces quatre routes quand un signataire est hors ligne. Si les mêmes personnes, l’outillage, les alertes, les politiques d’accès ou le processus d’approbation se trouvent derrière chaque coalition, alors dix parcours mathématiques peuvent encore se comporter comme un seul parcours opérationnel.
Une deuxième clé hors ligne rend cela encore plus net. Les quatre coalitions restantes s’effondrent en une seule. Babylone reste techniquement en fonctionnement, oui, mais il n’y a plus de diversité de routes. Une autre défaillance devient irréversible.
Une certaine concentration est normale. Les petits conseils sont plus faciles à coordonner, et la signature d’urgence ne peut pas être infiniment complexe.
Le vrai test oppose la résilience mathématique à la résilience opérationnelle.
Des coalitions alternatives sont-elles pré-autorisées, testées et joignables sous pression ? BABY peut-il faire tourner les signataires avant qu’un incident ne devienne un gel de la gouvernance ? Ou bien les opérateurs ne découvrent-ils le chemin de secours que lorsqu’ils en ont déjà besoin ?
Je ne considère pas une panne comme une défaillance du système. Cependant, les dix routes de Babylone ne comptent que si elles sont réellement indépendantes avant le début de l’urgence.
{future}(BABYUSDT)
@babylonlabs_io #baby $BABY
J’ai vu le conseil 3-sur-5 de Babylone à partir du numéro en titre : dix coalitions d’approbation. Puis j’ai retiré une clé, et six routes ont disparu.
Le point évident est que le quorum fonctionne encore. Quatre combinaisons restent. Ce n’est pas là le vrai problème.
Le comportement caché est de savoir si les opérateurs de BABY peuvent basculer entre ces quatre routes quand un signataire est hors ligne. Si les mêmes personnes, l’outillage, les alertes, les politiques d’accès ou le processus d’approbation se trouvent derrière chaque coalition, alors dix parcours mathématiques peuvent encore se comporter comme un seul parcours opérationnel.
Une deuxième clé hors ligne rend cela encore plus net. Les quatre coalitions restantes s’effondrent en une seule. Babylone reste techniquement en fonctionnement, oui, mais il n’y a plus de diversité de routes. Une autre défaillance devient irréversible.
Une certaine concentration est normale. Les petits conseils sont plus faciles à coordonner, et la signature d’urgence ne peut pas être infiniment complexe.
Le vrai test oppose la résilience mathématique à la résilience opérationnelle.
Des coalitions alternatives sont-elles pré-autorisées, testées et joignables sous pression ? BABY peut-il faire tourner les signataires avant qu’un incident ne devienne un gel de la gouvernance ? Ou bien les opérateurs ne découvrent-ils le chemin de secours que lorsqu’ils en ont déjà besoin ?
Je ne considère pas une panne comme une défaillance du système. Cependant, les dix routes de Babylone ne comptent que si elles sont réellement indépendantes avant le début de l’urgence.
@BabylonLabs_io #baby $BABY
Le point évident est que le quorum fonctionne encore. Quatre combinaisons restent. Ce n’est pas là le vrai problème.
Le comportement caché est de savoir si les opérateurs de BABY peuvent basculer entre ces quatre routes quand un signataire est hors ligne. Si les mêmes personnes, l’outillage, les alertes, les politiques d’accès ou le processus d’approbation se trouvent derrière chaque coalition, alors dix parcours mathématiques peuvent encore se comporter comme un seul parcours opérationnel.
Une deuxième clé hors ligne rend cela encore plus net. Les quatre coalitions restantes s’effondrent en une seule. Babylone reste techniquement en fonctionnement, oui, mais il n’y a plus de diversité de routes. Une autre défaillance devient irréversible.
Une certaine concentration est normale. Les petits conseils sont plus faciles à coordonner, et la signature d’urgence ne peut pas être infiniment complexe.
Le vrai test oppose la résilience mathématique à la résilience opérationnelle.
Des coalitions alternatives sont-elles pré-autorisées, testées et joignables sous pression ? BABY peut-il faire tourner les signataires avant qu’un incident ne devienne un gel de la gouvernance ? Ou bien les opérateurs ne découvrent-ils le chemin de secours que lorsqu’ils en ont déjà besoin ?
Je ne considère pas une panne comme une défaillance du système. Cependant, les dix routes de Babylone ne comptent que si elles sont réellement indépendantes avant le début de l’urgence.
@BabylonLabs_io #baby $BABY
26
26
4.3k
·
--
J’ai d’abord remarqué le risque de reprise de Babylon en chronométrant une sauvegarde par rapport à une connexion nominale de 20 Mbps.
L’évidence, c’est que 20 Mbps semble viable. Mais la bande passante annoncée est faible. Une fois que les surcharges du protocole, la congestion, les pertes de paquets, le chiffrement et la vitesse de stockage entrent en jeu, une réduction de 20 % ne laisse plus que quelque 16 Mbps de débit utile.
Cela change le comportement.
BABY peut sembler résilient sur le papier, mais les opérateurs doivent quand même restaurer des données dans une fenêtre de temps fixe. Testent-ils réellement la vitesse de reprise, ou se contentent-ils d’enregistrer le débit du forfait internet ? Le système peut-il tolérer une route plus lente, une liaison chargée, ou une nouvelle tentative après un échec ?
Une certaine perte d’efficacité est normale. Aucun réseau ne tourne en permanence à son maximum annoncé.
Le vrai test oppose les promesses techniques à l’expérience de l’opérateur. Babylon ne réussit que si les hypothèses de reprise s’appuient sur un débit utile mesuré, et non sur des taux de service idéaux. Sinon, le protocole peut rater sa fenêtre sans aucun signe évident de défaillance matérielle. La connexion fonctionne, mais pas assez vite.
Je ne lis pas 20 Mbps comme quelque chose d’impossible. En revanche, la résilience de BABY dépend du fait que Babylon conçoit pour la friction ordinaire d’un réseau plutôt que pour des conditions exceptionnellement propres.
C’est la partie que je continue de surveiller, car la reprise échoue à la marge, pas dans le chiffre en une ligne.
@babylonlabs_io #baby $BABY
J’ai d’abord remarqué le risque de reprise de Babylon en chronométrant une sauvegarde par rapport à une connexion nominale de 20 Mbps.
L’évidence, c’est que 20 Mbps semble viable. Mais la bande passante annoncée est faible. Une fois que les surcharges du protocole, la congestion, les pertes de paquets, le chiffrement et la vitesse de stockage entrent en jeu, une réduction de 20 % ne laisse plus que quelque 16 Mbps de débit utile.
Cela change le comportement.
BABY peut sembler résilient sur le papier, mais les opérateurs doivent quand même restaurer des données dans une fenêtre de temps fixe. Testent-ils réellement la vitesse de reprise, ou se contentent-ils d’enregistrer le débit du forfait internet ? Le système peut-il tolérer une route plus lente, une liaison chargée, ou une nouvelle tentative après un échec ?
Une certaine perte d’efficacité est normale. Aucun réseau ne tourne en permanence à son maximum annoncé.
Le vrai test oppose les promesses techniques à l’expérience de l’opérateur. Babylon ne réussit que si les hypothèses de reprise s’appuient sur un débit utile mesuré, et non sur des taux de service idéaux. Sinon, le protocole peut rater sa fenêtre sans aucun signe évident de défaillance matérielle. La connexion fonctionne, mais pas assez vite.
Je ne lis pas 20 Mbps comme quelque chose d’impossible. En revanche, la résilience de BABY dépend du fait que Babylon conçoit pour la friction ordinaire d’un réseau plutôt que pour des conditions exceptionnellement propres.
C’est la partie que je continue de surveiller, car la reprise échoue à la marge, pas dans le chiffre en une ligne.
@BabylonLabs_io #baby $BABY
L’évidence, c’est que 20 Mbps semble viable. Mais la bande passante annoncée est faible. Une fois que les surcharges du protocole, la congestion, les pertes de paquets, le chiffrement et la vitesse de stockage entrent en jeu, une réduction de 20 % ne laisse plus que quelque 16 Mbps de débit utile.
Cela change le comportement.
BABY peut sembler résilient sur le papier, mais les opérateurs doivent quand même restaurer des données dans une fenêtre de temps fixe. Testent-ils réellement la vitesse de reprise, ou se contentent-ils d’enregistrer le débit du forfait internet ? Le système peut-il tolérer une route plus lente, une liaison chargée, ou une nouvelle tentative après un échec ?
Une certaine perte d’efficacité est normale. Aucun réseau ne tourne en permanence à son maximum annoncé.
Le vrai test oppose les promesses techniques à l’expérience de l’opérateur. Babylon ne réussit que si les hypothèses de reprise s’appuient sur un débit utile mesuré, et non sur des taux de service idéaux. Sinon, le protocole peut rater sa fenêtre sans aucun signe évident de défaillance matérielle. La connexion fonctionne, mais pas assez vite.
Je ne lis pas 20 Mbps comme quelque chose d’impossible. En revanche, la résilience de BABY dépend du fait que Babylon conçoit pour la friction ordinaire d’un réseau plutôt que pour des conditions exceptionnellement propres.
C’est la partie que je continue de surveiller, car la reprise échoue à la marge, pas dans le chiffre en une ligne.
@BabylonLabs_io #baby $BABY
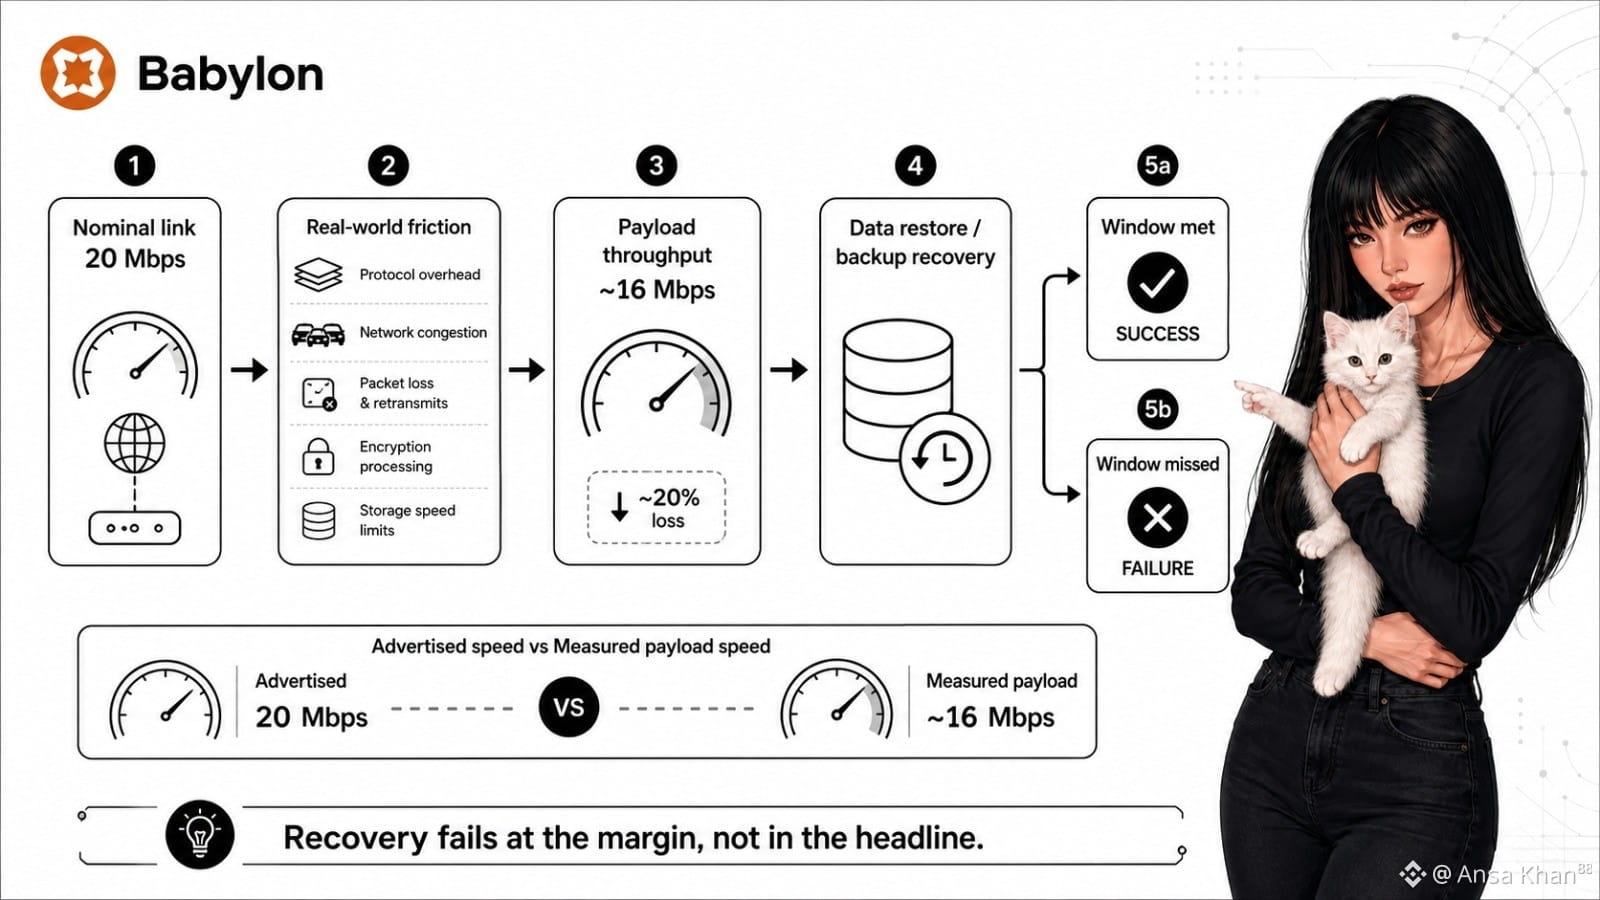
53
40
3.5k
·
--
J’ai remarqué le problème de liquidité de Babylon après avoir placé sa valeur bloquée à côté des véritables parcours de négociation du token.
Le point évident est qu’une perte de plus de 600 millions de dollars de valeur bloquée semble inquiétante. Mais ce chiffre seul est faible. L’expansion du produit peut continuer pendant que la TVL diminue, car la capacité technique ne correspond pas immédiatement à la demande.
Le signal le plus difficile se situe là où s’effectue la découverte du prix de BABY.
Les DEX ne gèrent qu’environ 13% du volume de BABY, tandis que les plateformes centralisées contrôlent les 87% restants. Même une hausse de 200% de la part des DEX ne laisserait la majorité des activités que sur des rails centralisés. Pour égaler le flux actuel des plateformes centralisées, il faudrait environ 569% de volume supplémentaire sur les DEX, en supposant que l’activité CEX ne baisse pas.
Une certaine faiblesse ici est normale. La liquidité on-chain se développe souvent plus lentement que les listings, les intégrations et les annonces produit.
Mais quel est le vrai test ? Babylon peut-elle transformer l’usage du protocole en liquidité native plus profonde, ou bien le token restera-t-il dépendant de carnets d’ordres externes pendant que l’écosystème s’étend ailleurs ?
Cela compte, car la gouvernance, l’utilité et la rétention des utilisateurs deviennent plus difficiles à croire lorsque le principal marché du token se trouve en dehors du système qu’il est censé soutenir.
Je ne considère pas une contraction comme un échec. Pourtant, une puissance d’infrastructure sans demande on-chain est un manque que Babylon n’a pas encore comblé.
{future}(BABYUSDT)
@babylonlabs_io $BABY #baby
J’ai remarqué le problème de liquidité de Babylon après avoir placé sa valeur bloquée à côté des véritables parcours de négociation du token.
Le point évident est qu’une perte de plus de 600 millions de dollars de valeur bloquée semble inquiétante. Mais ce chiffre seul est faible. L’expansion du produit peut continuer pendant que la TVL diminue, car la capacité technique ne correspond pas immédiatement à la demande.
Le signal le plus difficile se situe là où s’effectue la découverte du prix de BABY.
Les DEX ne gèrent qu’environ 13% du volume de BABY, tandis que les plateformes centralisées contrôlent les 87% restants. Même une hausse de 200% de la part des DEX ne laisserait la majorité des activités que sur des rails centralisés. Pour égaler le flux actuel des plateformes centralisées, il faudrait environ 569% de volume supplémentaire sur les DEX, en supposant que l’activité CEX ne baisse pas.
Une certaine faiblesse ici est normale. La liquidité on-chain se développe souvent plus lentement que les listings, les intégrations et les annonces produit.
Mais quel est le vrai test ? Babylon peut-elle transformer l’usage du protocole en liquidité native plus profonde, ou bien le token restera-t-il dépendant de carnets d’ordres externes pendant que l’écosystème s’étend ailleurs ?
Cela compte, car la gouvernance, l’utilité et la rétention des utilisateurs deviennent plus difficiles à croire lorsque le principal marché du token se trouve en dehors du système qu’il est censé soutenir.
Je ne considère pas une contraction comme un échec. Pourtant, une puissance d’infrastructure sans demande on-chain est un manque que Babylon n’a pas encore comblé.
@BabylonLabs_io $BABY #baby
Le point évident est qu’une perte de plus de 600 millions de dollars de valeur bloquée semble inquiétante. Mais ce chiffre seul est faible. L’expansion du produit peut continuer pendant que la TVL diminue, car la capacité technique ne correspond pas immédiatement à la demande.
Le signal le plus difficile se situe là où s’effectue la découverte du prix de BABY.
Les DEX ne gèrent qu’environ 13% du volume de BABY, tandis que les plateformes centralisées contrôlent les 87% restants. Même une hausse de 200% de la part des DEX ne laisserait la majorité des activités que sur des rails centralisés. Pour égaler le flux actuel des plateformes centralisées, il faudrait environ 569% de volume supplémentaire sur les DEX, en supposant que l’activité CEX ne baisse pas.
Une certaine faiblesse ici est normale. La liquidité on-chain se développe souvent plus lentement que les listings, les intégrations et les annonces produit.
Mais quel est le vrai test ? Babylon peut-elle transformer l’usage du protocole en liquidité native plus profonde, ou bien le token restera-t-il dépendant de carnets d’ordres externes pendant que l’écosystème s’étend ailleurs ?
Cela compte, car la gouvernance, l’utilité et la rétention des utilisateurs deviennent plus difficiles à croire lorsque le principal marché du token se trouve en dehors du système qu’il est censé soutenir.
Je ne considère pas une contraction comme un échec. Pourtant, une puissance d’infrastructure sans demande on-chain est un manque que Babylon n’a pas encore comblé.
@BabylonLabs_io $BABY #baby
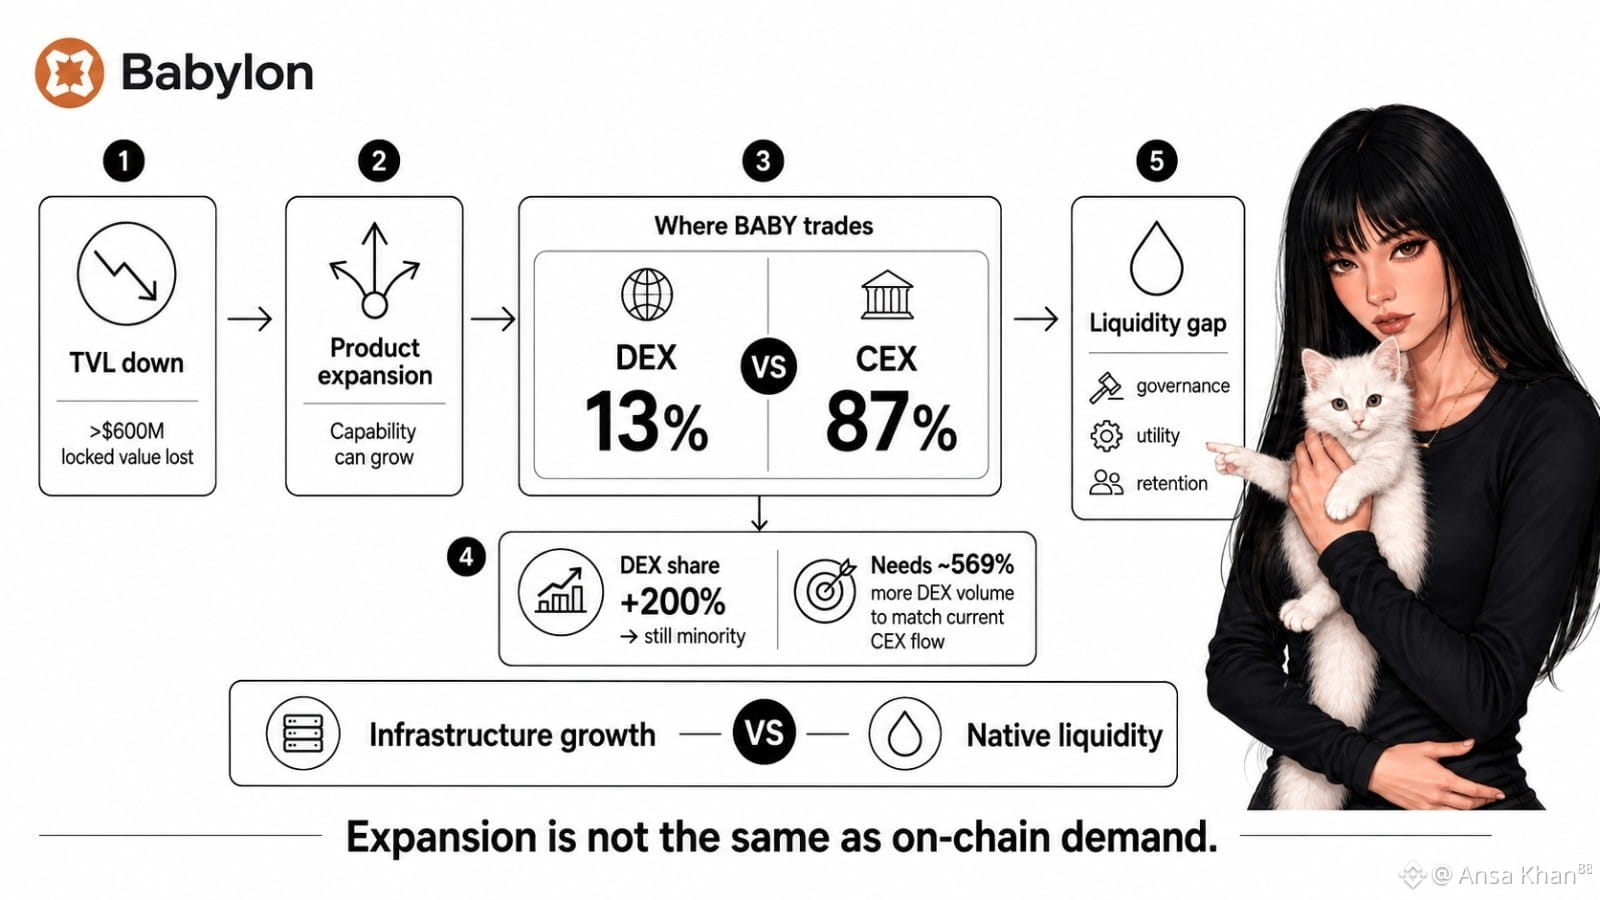
92
43
15.7k
·
--
J’ai vu le lot Pre-PegIn à dix sorties de Babylon, axé d’abord sur l’efficacité des frais. Une transaction unique portant dix sorties de vault semblait plus propre, moins chère et plus simple à faire évoluer.
C’était la lecture évidente, probablement la plus faible.
Le vrai problème apparaît après la diffusion. Chaque sortie peut conserver sa propre trajectoire de dépense Bitcoin, mais les dix dépendent encore d’un seul événement d’activation qui se déclenche à temps. Si ce peg-in se bloque, BABY ne fait pas face à un seul vault en retard. Il peut avoir dix utilisateurs en attente derrière le même échec de “liveness”.
Une dépendance partagée est normale. Le batching existe parce que répéter l’entrée dix fois gaspille de l’espace de bloc et augmente le coût par vault. L’efficacité est réelle.
Mais le test, c’est le comportement en cas de délai. Babylon peut-elle isoler la récupération pour chaque sortie, ou un problème au niveau de la transaction entière tient-il tout le lot ensemble ? Qui réagit lorsque la date limite commence à se réduire ? Les frais absolus plus élevés liés à une transaction rendent-ils la re-diffusion plus douloureuse ?
C’est l’efficacité des frais contre la concentration des défaillances.
BABY réussit si le batching réduit le coût d’entrée sans transformer une seule erreur opérationnelle en une file d’attente de dix vault. Je surveille encore un point inconfortable : des trajectoires de dépense séparées ne garantissent pas une liveness séparée.
Babylon peut gagner de l’espace ici. La question la plus difficile est de savoir si cela préserve l’indépendance.
{future}(BABYUSDT)
@babylonlabs_io #baby $BABY
J’ai vu le lot Pre-PegIn à dix sorties de Babylon, axé d’abord sur l’efficacité des frais. Une transaction unique portant dix sorties de vault semblait plus propre, moins chère et plus simple à faire évoluer.
C’était la lecture évidente, probablement la plus faible.
Le vrai problème apparaît après la diffusion. Chaque sortie peut conserver sa propre trajectoire de dépense Bitcoin, mais les dix dépendent encore d’un seul événement d’activation qui se déclenche à temps. Si ce peg-in se bloque, BABY ne fait pas face à un seul vault en retard. Il peut avoir dix utilisateurs en attente derrière le même échec de “liveness”.
Une dépendance partagée est normale. Le batching existe parce que répéter l’entrée dix fois gaspille de l’espace de bloc et augmente le coût par vault. L’efficacité est réelle.
Mais le test, c’est le comportement en cas de délai. Babylon peut-elle isoler la récupération pour chaque sortie, ou un problème au niveau de la transaction entière tient-il tout le lot ensemble ? Qui réagit lorsque la date limite commence à se réduire ? Les frais absolus plus élevés liés à une transaction rendent-ils la re-diffusion plus douloureuse ?
C’est l’efficacité des frais contre la concentration des défaillances.
BABY réussit si le batching réduit le coût d’entrée sans transformer une seule erreur opérationnelle en une file d’attente de dix vault. Je surveille encore un point inconfortable : des trajectoires de dépense séparées ne garantissent pas une liveness séparée.
Babylon peut gagner de l’espace ici. La question la plus difficile est de savoir si cela préserve l’indépendance.
@BabylonLabs_io #baby $BABY
C’était la lecture évidente, probablement la plus faible.
Le vrai problème apparaît après la diffusion. Chaque sortie peut conserver sa propre trajectoire de dépense Bitcoin, mais les dix dépendent encore d’un seul événement d’activation qui se déclenche à temps. Si ce peg-in se bloque, BABY ne fait pas face à un seul vault en retard. Il peut avoir dix utilisateurs en attente derrière le même échec de “liveness”.
Une dépendance partagée est normale. Le batching existe parce que répéter l’entrée dix fois gaspille de l’espace de bloc et augmente le coût par vault. L’efficacité est réelle.
Mais le test, c’est le comportement en cas de délai. Babylon peut-elle isoler la récupération pour chaque sortie, ou un problème au niveau de la transaction entière tient-il tout le lot ensemble ? Qui réagit lorsque la date limite commence à se réduire ? Les frais absolus plus élevés liés à une transaction rendent-ils la re-diffusion plus douloureuse ?
C’est l’efficacité des frais contre la concentration des défaillances.
BABY réussit si le batching réduit le coût d’entrée sans transformer une seule erreur opérationnelle en une file d’attente de dix vault. Je surveille encore un point inconfortable : des trajectoires de dépense séparées ne garantissent pas une liveness séparée.
Babylon peut gagner de l’espace ici. La question la plus difficile est de savoir si cela préserve l’indépendance.
@BabylonLabs_io #baby $BABY
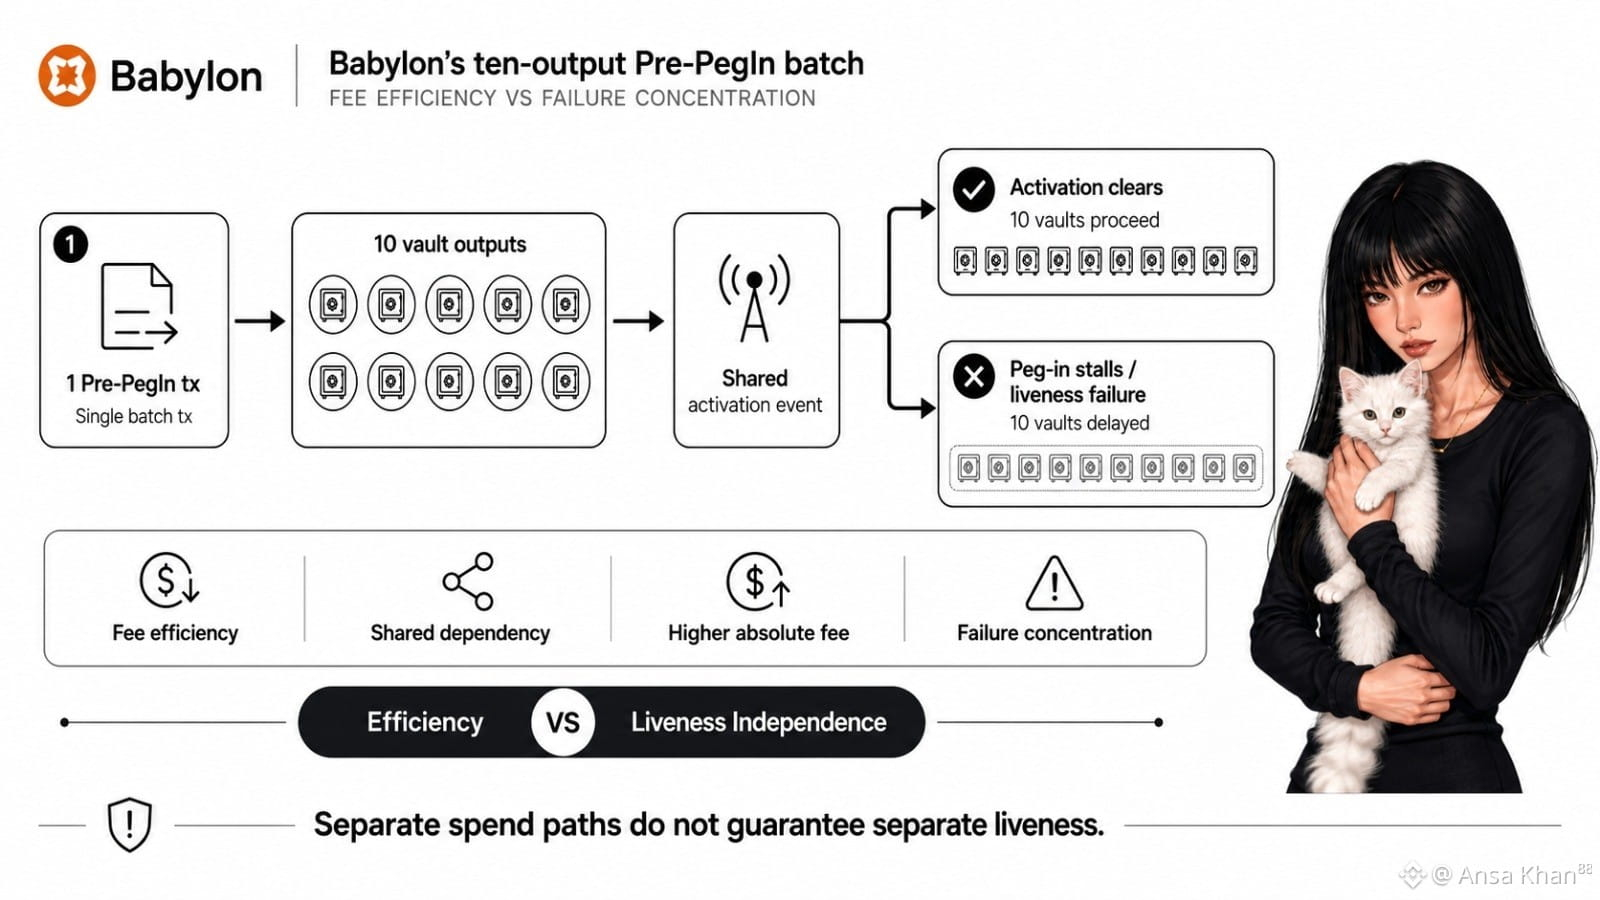
68
54
10.9k
·
--
Partiellement vrai
Ma première impression sur le design de la liquidation de Babylon, depuis la commission à taux zéro (zero-basis-point fee). Cela semblait favorable à l’emprunteur et étonnamment propre.
Mais c’est une mesure évidente, et elle masque le transfert.
Un emprunteur peut ne payer aucune commission au protocole, pourtant de la valeur quitte toujours la position via la prime du liquidateur. À proximité du seuil de 1,0, Babylon peut appliquer l’incitation complète de 10 % au lieu d’attendre une insolvabilité plus profonde. Donc « zéro commission » n’est pas un coût nul. C’est une question de visibilité des frais versus perte économique réelle.
Cet arbitrage est compréhensible. Les liquidateurs ont besoin d’une incitation suffisante pour agir rapidement lorsque la couverture des garanties est faible et que le timing compte. Des incitations faibles peuvent laisser la mauvaise dette plus longtemps. Un certain coût est normal.
Néanmoins, le comportement compte plus que l’étiquette. Est-ce que BABY protège la solvabilité en agissant tôt, ou bien la prime de 10 % consomme-t-elle trop de garantie avant que l’emprunteur ait une marge de reprise significative ? Après le remboursement de la dette et les coûts d’incitation, quelle quantité de tampon reste réellement ?
La plupart des gens regarderont si la liquidation efface la dette. Moi, je regarde ce qui reste après.
Babylon réussit si une liquidation précoce préserve la solidité du système sans obliger les emprunteurs à absorber une pénalité cachée, dissimulée derrière des frais de protocole à zéro. Mon doute est simple : une ligne de frais « propre » peut quand même produire un résultat utilisateur rude.
{future}(BABYUSDT)
@babylonlabs_io #baby $BABY
Ma première impression sur le design de la liquidation de Babylon, depuis la commission à taux zéro (zero-basis-point fee). Cela semblait favorable à l’emprunteur et étonnamment propre.
Mais c’est une mesure évidente, et elle masque le transfert.
Un emprunteur peut ne payer aucune commission au protocole, pourtant de la valeur quitte toujours la position via la prime du liquidateur. À proximité du seuil de 1,0, Babylon peut appliquer l’incitation complète de 10 % au lieu d’attendre une insolvabilité plus profonde. Donc « zéro commission » n’est pas un coût nul. C’est une question de visibilité des frais versus perte économique réelle.
Cet arbitrage est compréhensible. Les liquidateurs ont besoin d’une incitation suffisante pour agir rapidement lorsque la couverture des garanties est faible et que le timing compte. Des incitations faibles peuvent laisser la mauvaise dette plus longtemps. Un certain coût est normal.
Néanmoins, le comportement compte plus que l’étiquette. Est-ce que BABY protège la solvabilité en agissant tôt, ou bien la prime de 10 % consomme-t-elle trop de garantie avant que l’emprunteur ait une marge de reprise significative ? Après le remboursement de la dette et les coûts d’incitation, quelle quantité de tampon reste réellement ?
La plupart des gens regarderont si la liquidation efface la dette. Moi, je regarde ce qui reste après.
Babylon réussit si une liquidation précoce préserve la solidité du système sans obliger les emprunteurs à absorber une pénalité cachée, dissimulée derrière des frais de protocole à zéro. Mon doute est simple : une ligne de frais « propre » peut quand même produire un résultat utilisateur rude.
@BabylonLabs_io #baby $BABY
Mais c’est une mesure évidente, et elle masque le transfert.
Un emprunteur peut ne payer aucune commission au protocole, pourtant de la valeur quitte toujours la position via la prime du liquidateur. À proximité du seuil de 1,0, Babylon peut appliquer l’incitation complète de 10 % au lieu d’attendre une insolvabilité plus profonde. Donc « zéro commission » n’est pas un coût nul. C’est une question de visibilité des frais versus perte économique réelle.
Cet arbitrage est compréhensible. Les liquidateurs ont besoin d’une incitation suffisante pour agir rapidement lorsque la couverture des garanties est faible et que le timing compte. Des incitations faibles peuvent laisser la mauvaise dette plus longtemps. Un certain coût est normal.
Néanmoins, le comportement compte plus que l’étiquette. Est-ce que BABY protège la solvabilité en agissant tôt, ou bien la prime de 10 % consomme-t-elle trop de garantie avant que l’emprunteur ait une marge de reprise significative ? Après le remboursement de la dette et les coûts d’incitation, quelle quantité de tampon reste réellement ?
La plupart des gens regarderont si la liquidation efface la dette. Moi, je regarde ce qui reste après.
Babylon réussit si une liquidation précoce préserve la solidité du système sans obliger les emprunteurs à absorber une pénalité cachée, dissimulée derrière des frais de protocole à zéro. Mon doute est simple : une ligne de frais « propre » peut quand même produire un résultat utilisateur rude.
@BabylonLabs_io #baby $BABY
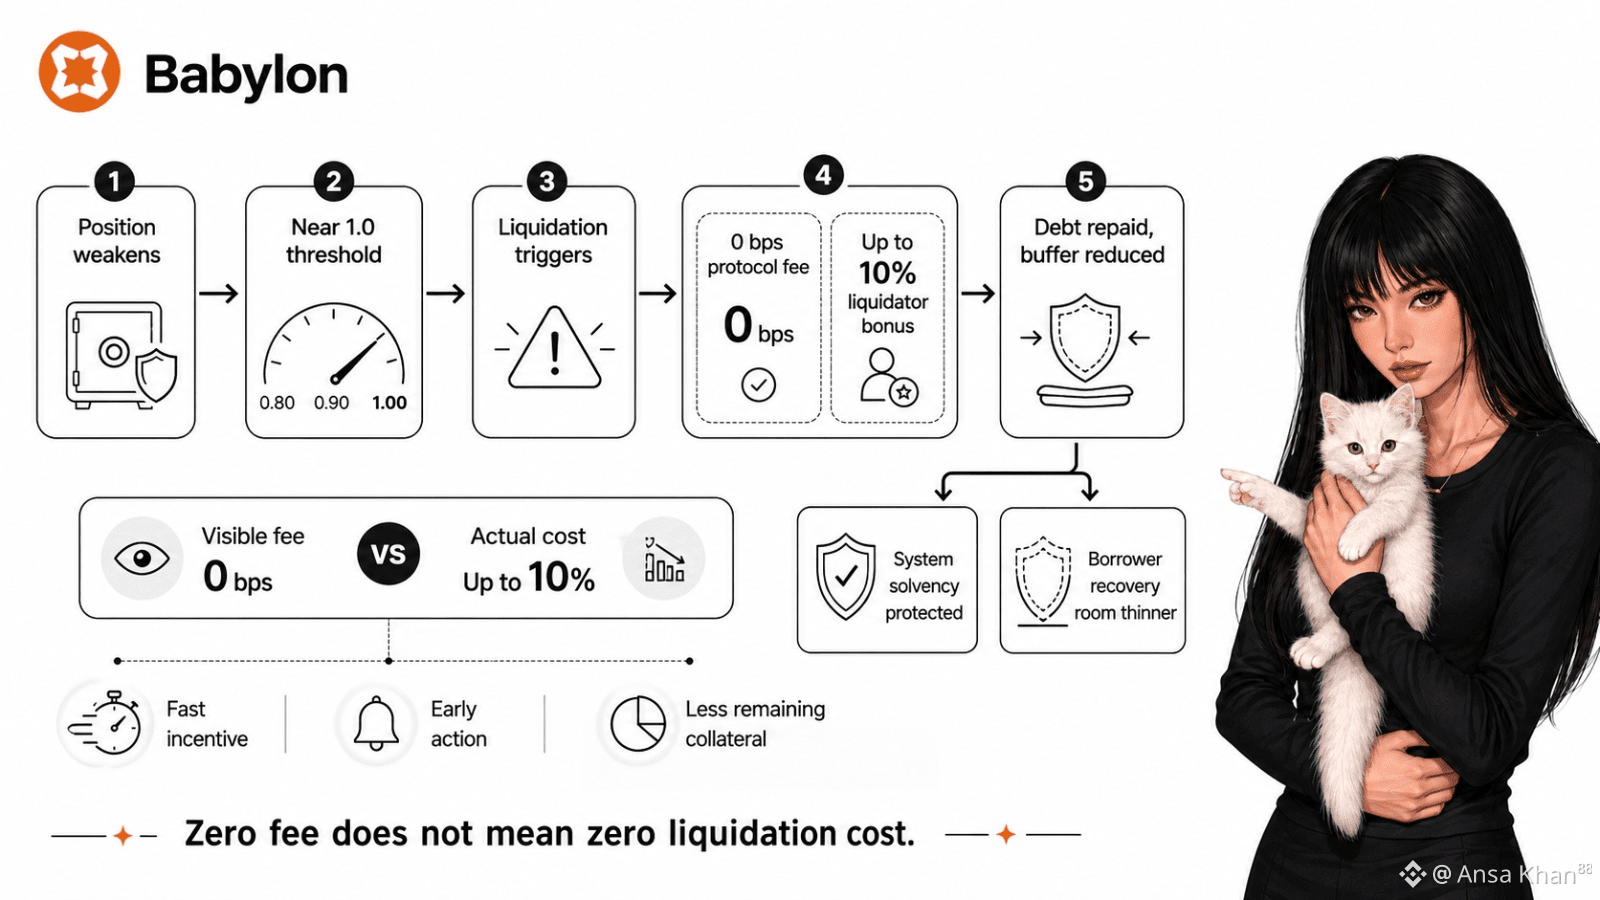
59
41
5.9k
Connectez-vous pour découvrir plus de contenu
Rejoignez la communauté mondiale des adeptes de cryptomonnaies sur Binance Square
⚡️ Suviez les dernières informations importantes sur les cryptomonnaies.
💬 Jugé digne de confiance par la plus grande plateforme d’échange de cryptomonnaies au monde.
👍 Découvrez les connaissances que partagent les créateurs vérifiés.
Adresse e-mail/Nº de téléphone
Sujets d’actualité
HotCPIDecemberHikePriced
5,446 vues
262 mentions
Suivi des marchés et de l’IPC | L’IPC américain progresse de 0,4 % en octobre, contre 0,3 % attendu
Binance News
·10 mentions J’aime
·14.3k vues
AnthropicRejectsIPODelayValuationinQuestion
135,306 vues
1,267 mentions
NvidiaInvestigatesAfterHuang’sAffairApology
381,639 vues
2,743 mentions