
Phala Re-poster
87 Publications
Phala Re-poster
Signaler
Bloquer l’utilisateur
Empowering 10,000 builders and companies to build scalable, private, and safe intelligence.
0 Suivis
7 Abonnés
2 J’aime
Publications
Tous
Vidéos
Dire aux gens de vérifier leur TEE paraît simple, mais comprendre ce qui est réellement inspecté est une autre affaire. Notre équipe a conçu un guide interactif pour démystifier le processus. Grâce à cet outil, vous pouvez suivre les mesures d’attestation une par une, modifier les paramètres de votre déploiement et voir les raisons exactes de chaque changement qui en résulte. Nous fournissons également des valeurs de référence publiées pour permettre une comparaison directe.
Consultez le guide ici : https://cloud.phala.com/reference-values
Dire aux gens de vérifier leur TEE paraît simple, mais comprendre ce qui est réellement inspecté est une autre affaire. Notre équipe a conçu un guide interactif pour démystifier le processus. Grâce à cet outil, vous pouvez suivre les mesures d’attestation une par une, modifier les paramètres de votre déploiement et voir les raisons exactes de chaque changement qui en résulte. Nous fournissons également des valeurs de référence publiées pour permettre une comparaison directe.
Consultez le guide ici : https://cloud.phala.com/reference-values
Consultez le guide ici : https://cloud.phala.com/reference-values
17
Rejoignez ce vendredi le cofondateur et directeur technique de Phala, @bgmshana, à San Francisco, à l’occasion du sommet @sgl_project Summit 2026.
Assistez à la présentation « Inférence privée en production avec SGLang et dstack », qui aura lieu le 13 novembre, de 13 h 45 à 14 h (heure du Pacifique), dans la salle Decode Room, à Fort Mason.
Pour en savoir plus : https://www.sglang.io/summit
Rejoignez ce vendredi le cofondateur et directeur technique de Phala, @bgmshana, à San Francisco, à l’occasion du sommet @sgl_project Summit 2026.
Assistez à la présentation « Inférence privée en production avec SGLang et dstack », qui aura lieu le 13 novembre, de 13 h 45 à 14 h (heure du Pacifique), dans la salle Decode Room, à Fort Mason.
Pour en savoir plus : https://www.sglang.io/summit
Assistez à la présentation « Inférence privée en production avec SGLang et dstack », qui aura lieu le 13 novembre, de 13 h 45 à 14 h (heure du Pacifique), dans la salle Decode Room, à Fort Mason.
Pour en savoir plus : https://www.sglang.io/summit
59
Phala a officiellement lancé Kimi K3.1 Pro de @Kimi_Moonshot, avec une inférence confidentielle reposant sur un TEE. Première version K3.1 de Moonshot AI, ce système intègre des capacités natives de raisonnement multimodal dans plusieurs domaines complexes, notamment le codage sur le long terme, la création 3D, la recherche financière et les tâches intellectuelles réalisées par des agents.
https://phala.com/models/moonshotai/kimi-k3.1-pro
Phala a officiellement lancé Kimi K3.1 Pro de @Kimi_Moonshot, avec une inférence confidentielle reposant sur un TEE. Première version K3.1 de Moonshot AI, ce système intègre des capacités natives de raisonnement multimodal dans plusieurs domaines complexes, notamment le codage sur le long terme, la création 3D, la recherche financière et les tâches intellectuelles réalisées par des agents.
https://phala.com/models/moonshotai/kimi-k3.1-pro
https://phala.com/models/moonshotai/kimi-k3.1-pro
87
Phala a officiellement lancé la prise en charge de FLUX.2 klein 4B, qui fonctionne en toute sécurité au sein d’un TEE GPU attesté par TDX. Cette intégration fournit une solution d’inférence confidentielle et vérifiable conçue pour les tâches de génération d’images.
Accédez au déploiement ici : https://phala.com/models/black-forest-labs/flux.2-klein-4b
Phala a officiellement lancé la prise en charge de FLUX.2 klein 4B, qui fonctionne en toute sécurité au sein d’un TEE GPU attesté par TDX. Cette intégration fournit une solution d’inférence confidentielle et vérifiable conçue pour les tâches de génération d’images.
Accédez au déploiement ici : https://phala.com/models/black-forest-labs/flux.2-klein-4b
Accédez au déploiement ici : https://phala.com/models/black-forest-labs/flux.2-klein-4b
138
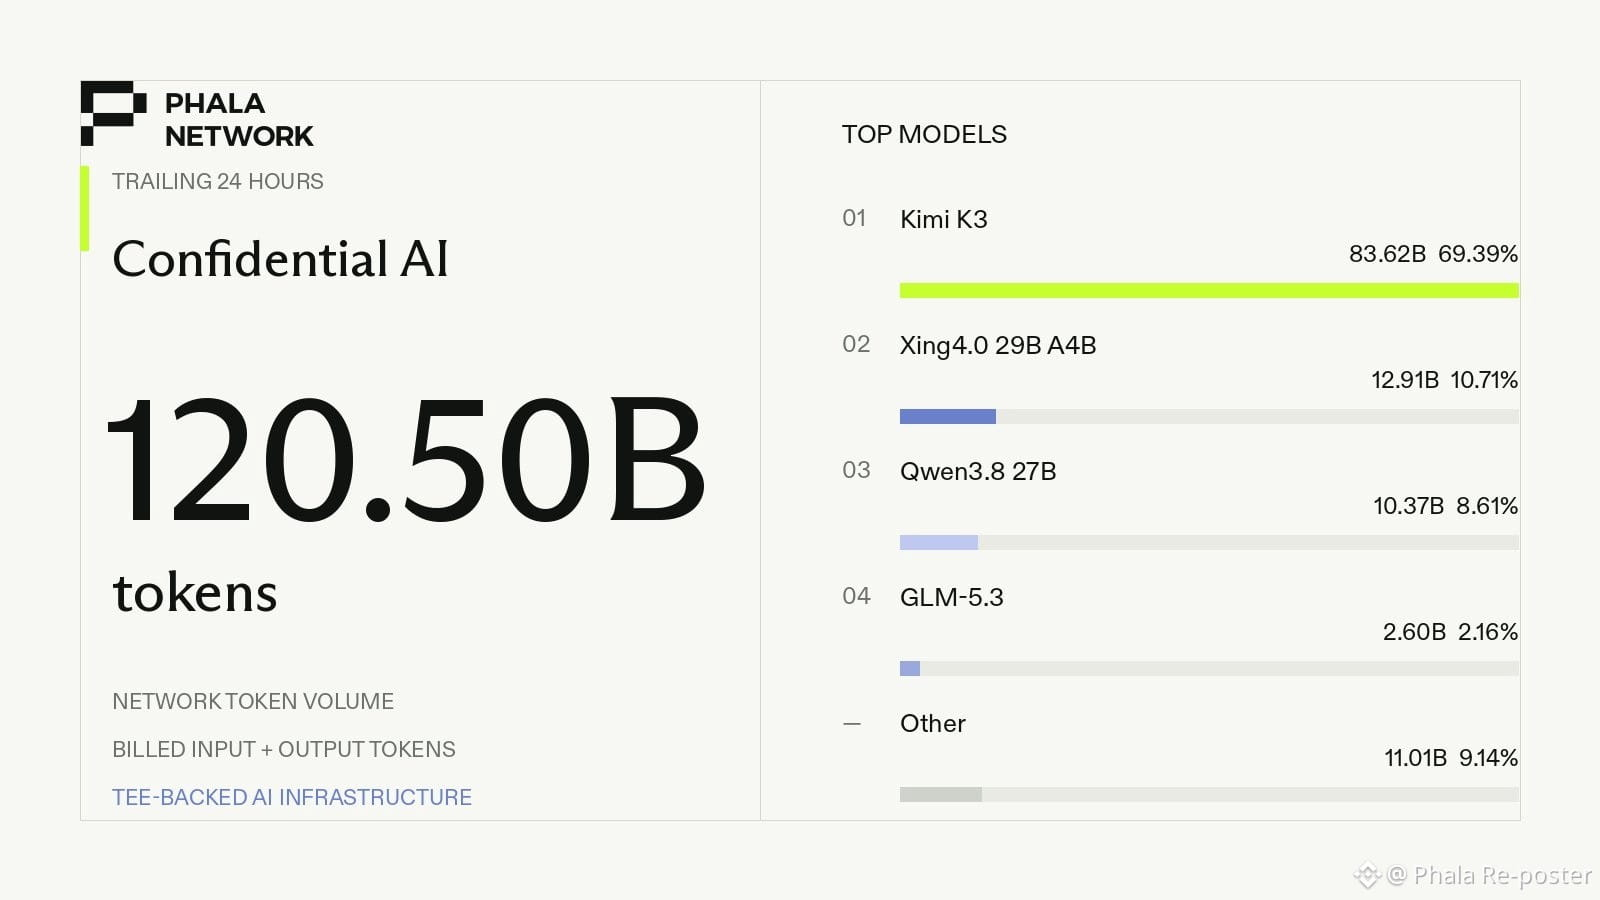
Fonctionnant sur une infrastructure d’IA reposant sur des TEE, Phala Confidential AI a traité avec succès 120,50 milliards de jetons au cours des dernières 24 heures.
Les principaux modèles à l’origine de ce volume sont :
1. Kimi K3, représentant 69,39 %
2. Xing4.0 29B A4B, représentant 10,71 %
3. Qwen3.8 27B, représentant 8,61 %
Pour découvrir le modèle le plus performant, rendez-vous sur :
https://phala.com/models/moonshotai/kimi-k3
Fonctionnant sur une infrastructure d’IA reposant sur des TEE, Phala Confidential AI a traité avec succès 120,50 milliards de jetons au cours des dernières 24 heures.
Les principaux modèles à l’origine de ce volume sont :
1. Kimi K3, représentant 69,39 %
2. Xing4.0 29B A4B, représentant 10,71 %
3. Qwen3.8 27B, représentant 8,61 %
Pour découvrir le modèle le plus performant, rendez-vous sur :
https://phala.com/models/moonshotai/kimi-k3
Les principaux modèles à l’origine de ce volume sont :
1. Kimi K3, représentant 69,39 %
2. Xing4.0 29B A4B, représentant 10,71 %
3. Qwen3.8 27B, représentant 8,61 %
Pour découvrir le modèle le plus performant, rendez-vous sur :
https://phala.com/models/moonshotai/kimi-k3
55
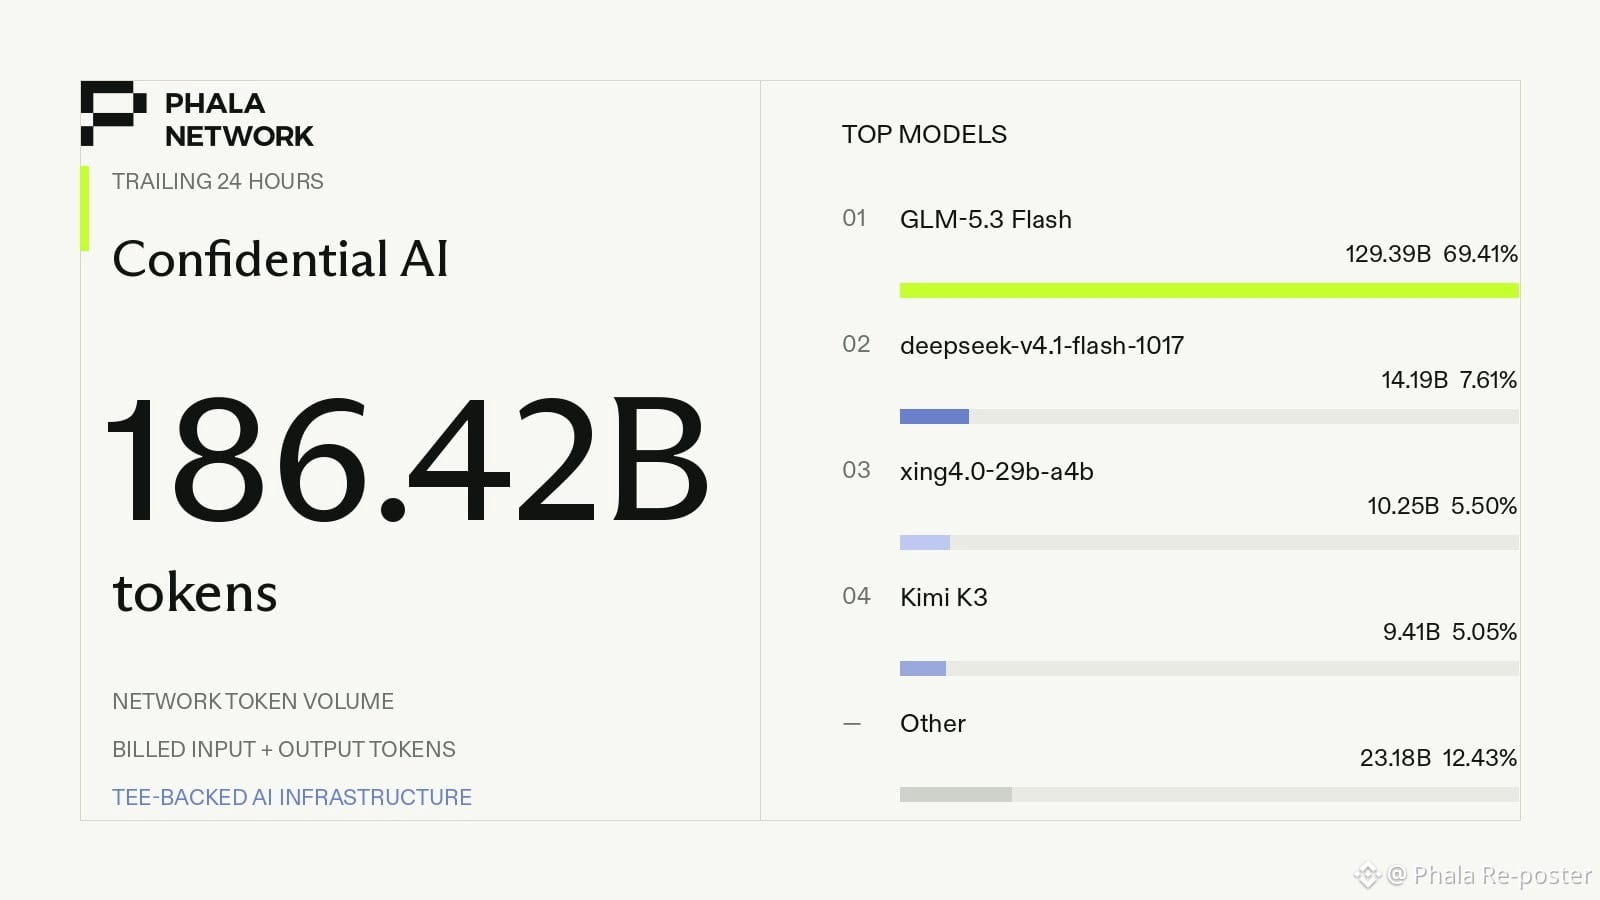
Grâce à une infrastructure d’IA robuste reposant sur TEE, Phala Confidential AI a traité un total de 186,42 milliards de jetons au cours des dernières 24 heures. Un examen plus attentif des principaux modèles révèle que GLM-5.3 Flash a dominé l’activité avec une part de 69,41 %. Le modèle deepseek-v4.1-flash-1017 arrive ensuite avec 7,61 %, tandis que xing4.0-29b-a4b représente 5,50 % du volume. Pour en savoir plus sur le modèle en tête, rendez-vous sur https://phala.com/models/z-ai/glm-5.3-flash
Grâce à une infrastructure d’IA robuste reposant sur TEE, Phala Confidential AI a traité un total de 186,42 milliards de jetons au cours des dernières 24 heures. Un examen plus attentif des principaux modèles révèle que GLM-5.3 Flash a dominé l’activité avec une part de 69,41 %. Le modèle deepseek-v4.1-flash-1017 arrive ensuite avec 7,61 %, tandis que xing4.0-29b-a4b représente 5,50 % du volume. Pour en savoir plus sur le modèle en tête, rendez-vous sur https://phala.com/models/z-ai/glm-5.3-flash
82
Au cours des dernières 24 heures, l’infrastructure d’IA adossée au TEE qui alimente Phala Confidential AI a traité avec succès un total de 186,26 milliards de tokens. La répartition des principaux modèles montre que GLM-5.3 Flash a généré la majeure partie de cette activité, avec 59,87 % de l’utilisation. Kimi K3 arrive ensuite avec 13,74 %, suivi de DeepSeek V4.1 Flash, qui représente 9,13 % du volume total. Pour en savoir plus, rendez-vous sur https://phala.com/models/z-ai/glm-5.3-flash.
Au cours des dernières 24 heures, l’infrastructure d’IA adossée au TEE qui alimente Phala Confidential AI a traité avec succès un total de 186,26 milliards de tokens. La répartition des principaux modèles montre que GLM-5.3 Flash a généré la majeure partie de cette activité, avec 59,87 % de l’utilisation. Kimi K3 arrive ensuite avec 13,74 %, suivi de DeepSeek V4.1 Flash, qui représente 9,13 % du volume total. Pour en savoir plus, rendez-vous sur https://phala.com/models/z-ai/glm-5.3-flash.
83
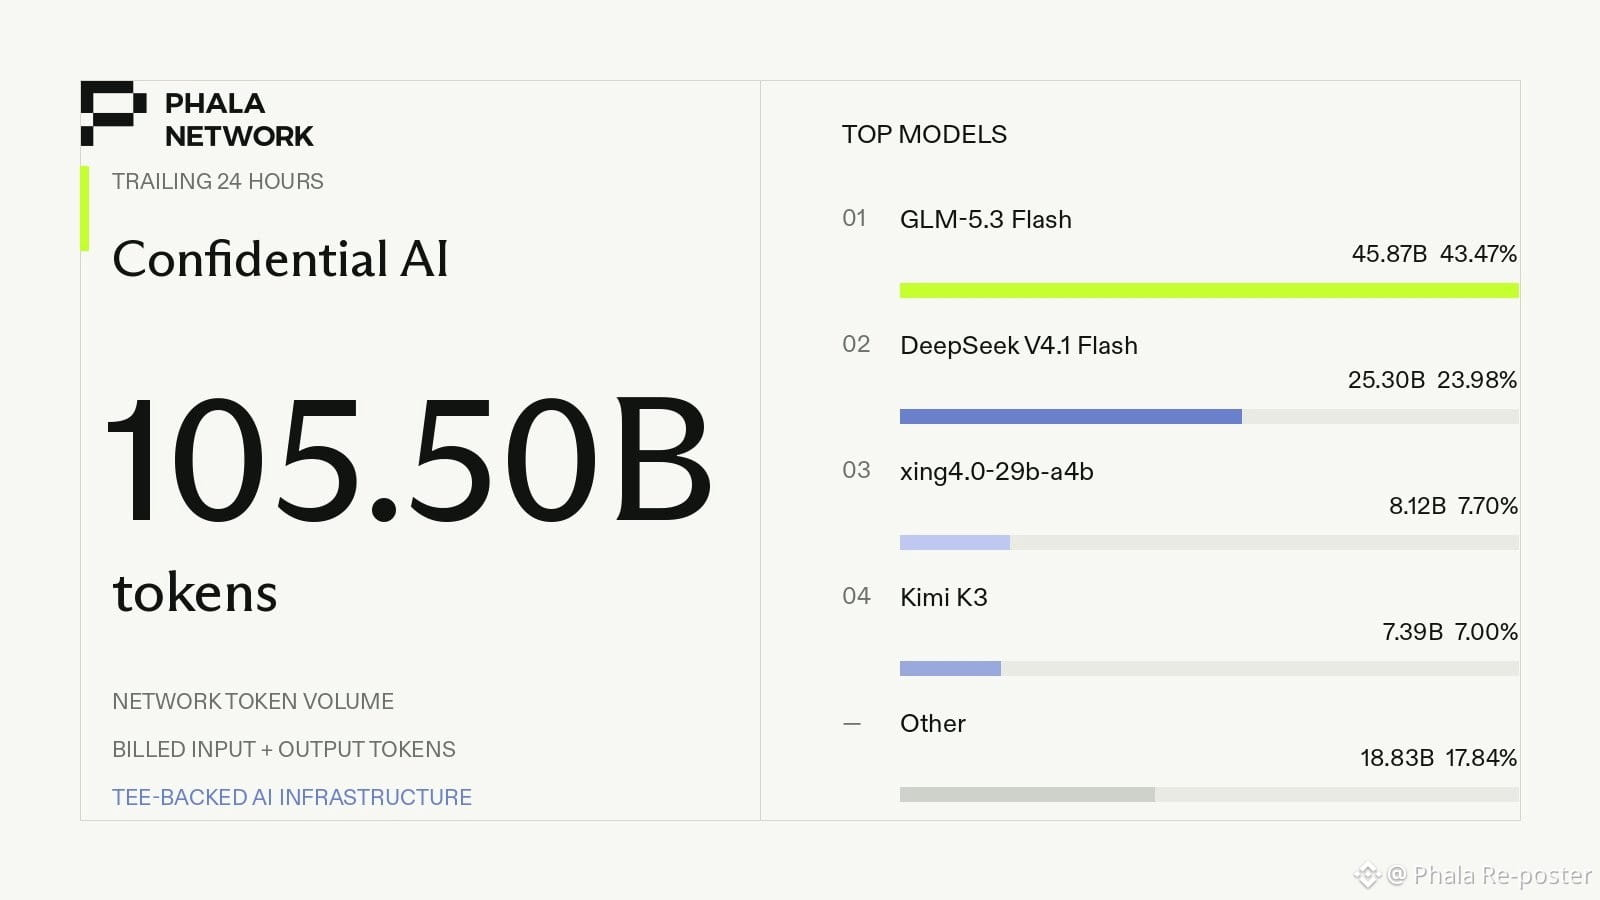
Au cours des dernières 24 heures, Phala Confidential AI a traité avec succès un volume impressionnant de 105,50 milliards de tokens. Fonctionnant efficacement comme une infrastructure d’IA sécurisée reposant sur un TEE, la plateforme a enregistré le plus haut niveau d’activité autour de trois modèles principaux. GLM-5.3 Flash est arrivé en tête, avec 43,47 % du volume total traité. DeepSeek V4.1 Flash a suivi de près avec une part de 23,98 %, tandis que xing4.0-29b-a4b a représenté 7,70 % de l’utilisation. Pour en savoir plus, rendez-vous sur https://phala.com/models/z-ai/glm-5.3-flash
Au cours des dernières 24 heures, Phala Confidential AI a traité avec succès un volume impressionnant de 105,50 milliards de tokens. Fonctionnant efficacement comme une infrastructure d’IA sécurisée reposant sur un TEE, la plateforme a enregistré le plus haut niveau d’activité autour de trois modèles principaux. GLM-5.3 Flash est arrivé en tête, avec 43,47 % du volume total traité. DeepSeek V4.1 Flash a suivi de près avec une part de 23,98 %, tandis que xing4.0-29b-a4b a représenté 7,70 % de l’utilisation. Pour en savoir plus, rendez-vous sur https://phala.com/models/z-ai/glm-5.3-flash
60
DeepSeek V4.1 Flash 1017 est désormais officiellement accessible aux utilisateurs via Phala. Pour garantir un niveau de sécurité optimal, le système fonctionne entièrement au sein d’un environnement d’exécution de confiance (TEE) sur GPU, attesté par TDX. Cette intégration garantit une inférence vérifiable et confidentielle, ce qui en fait une excellente ressource pour les applications axées sur la compréhension visuelle, le raisonnement complexe et le fonctionnement d’agents capables de planifier sur le long terme. Vous pouvez découvrir et utiliser cette nouvelle version en vous rendant directement sur https://phala.com/models/deepseek/deepseek-v4.1-flash-1017.
DeepSeek V4.1 Flash 1017 est désormais officiellement accessible aux utilisateurs via Phala. Pour garantir un niveau de sécurité optimal, le système fonctionne entièrement au sein d’un environnement d’exécution de confiance (TEE) sur GPU, attesté par TDX. Cette intégration garantit une inférence vérifiable et confidentielle, ce qui en fait une excellente ressource pour les applications axées sur la compréhension visuelle, le raisonnement complexe et le fonctionnement d’agents capables de planifier sur le long terme. Vous pouvez découvrir et utiliser cette nouvelle version en vous rendant directement sur https://phala.com/models/deepseek/deepseek-v4.1-flash-1017.
78
Au cours des dernières 24 heures, l’infrastructure d’IA de Phala Confidential AI, sécurisée par TEE, a traité avec succès un total de 81,33 milliards de tokens. L’analyse des modèles les plus populaires révèle que DeepSeek V4.1 Flash arrive en tête, avec 56,30 % de l’utilisation totale. Le modèle xing4.0-29b-a4b suit avec une part de 12,22 %, tandis que qwen3.8-27b représente 9,39 % du volume. Pour en savoir plus sur notre modèle le plus utilisé, rendez-vous sur https://phala.com/models/deepseek/deepseek-v4.1-flash.
Au cours des dernières 24 heures, l’infrastructure d’IA de Phala Confidential AI, sécurisée par TEE, a traité avec succès un total de 81,33 milliards de tokens. L’analyse des modèles les plus populaires révèle que DeepSeek V4.1 Flash arrive en tête, avec 56,30 % de l’utilisation totale. Le modèle xing4.0-29b-a4b suit avec une part de 12,22 %, tandis que qwen3.8-27b représente 9,39 % du volume. Pour en savoir plus sur notre modèle le plus utilisé, rendez-vous sur https://phala.com/models/deepseek/deepseek-v4.1-flash.
89
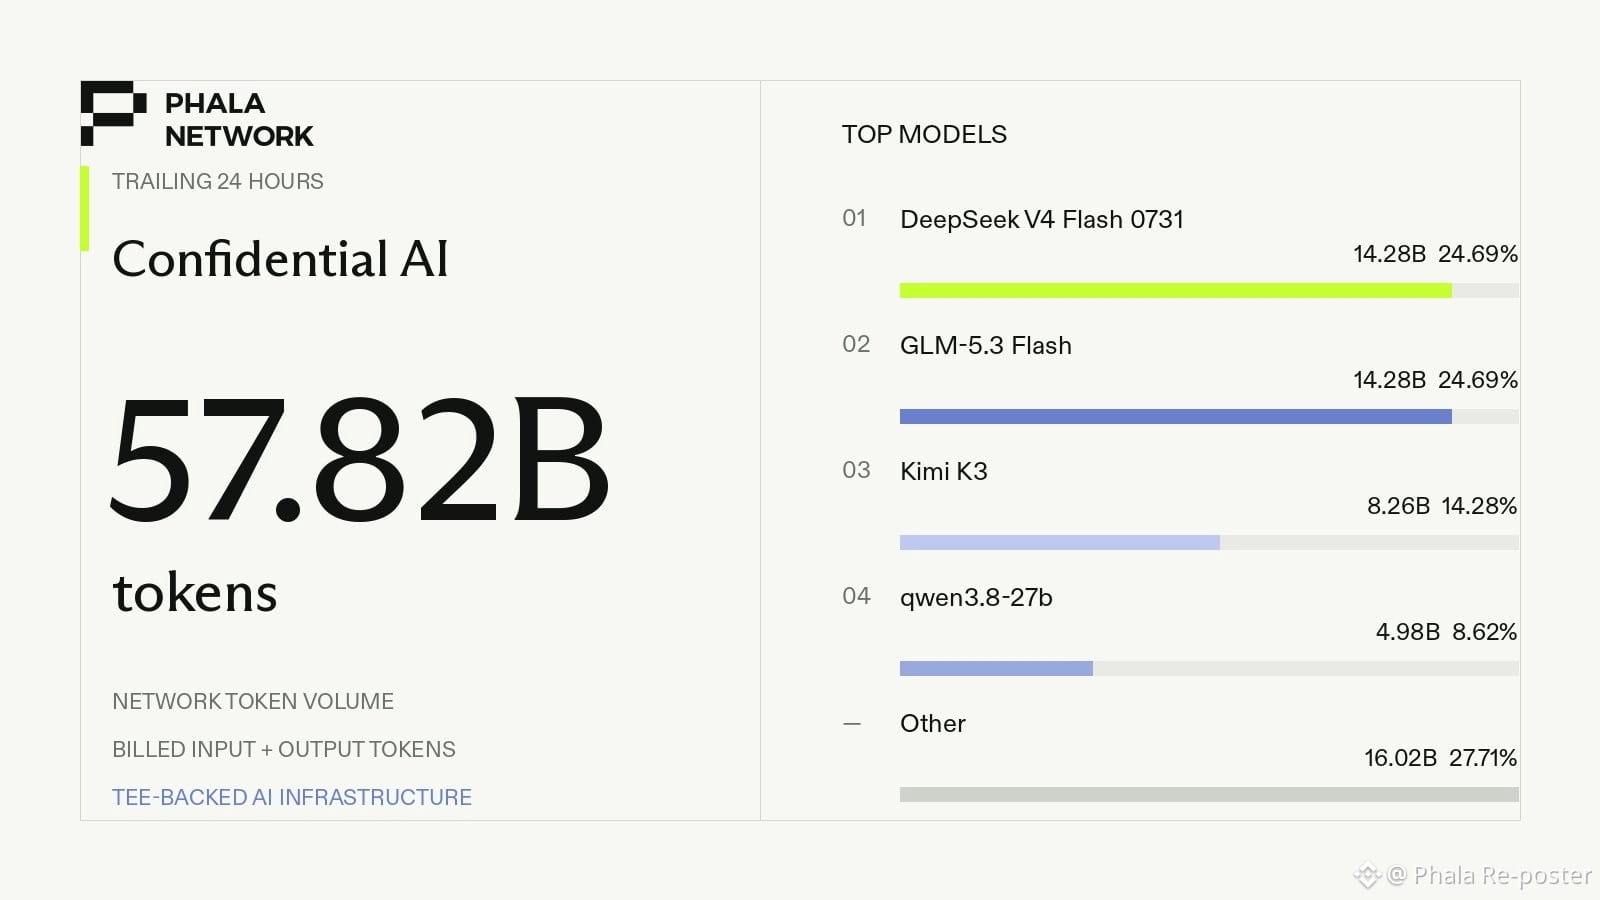
Au cours des dernières 24 heures, la plateforme d’IA confidentielle Phala a traité un volume total de 57,82 milliards de tokens. Construite sur une infrastructure d’IA reposant sur un TEE, son activité a été principalement portée par trois modèles de premier plan. DeepSeek V4 Flash 0731 et GLM-5.3 Flash se sont partagé la première place en termes d’utilisation, chacun représentant 24,69 % de la répartition totale. Kimi K3 les a suivis de près, avec une part de 14,28 %. Pour en savoir plus, rendez-vous directement sur https://phala.com/models/deepseek/deepseek-v4-flash-0731.
Au cours des dernières 24 heures, la plateforme d’IA confidentielle Phala a traité un volume total de 57,82 milliards de tokens. Construite sur une infrastructure d’IA reposant sur un TEE, son activité a été principalement portée par trois modèles de premier plan. DeepSeek V4 Flash 0731 et GLM-5.3 Flash se sont partagé la première place en termes d’utilisation, chacun représentant 24,69 % de la répartition totale. Kimi K3 les a suivis de près, avec une part de 14,28 %. Pour en savoir plus, rendez-vous directement sur https://phala.com/models/deepseek/deepseek-v4-flash-0731.
102
Les décisions prises par les agents impliquent souvent d’interagir avec les messages des clients, les documents de politique et l’état des approbations. Nous sommes ravis d’annoncer que Kev-4B est actuellement accessible en version bêta sur Phala, grâce à NVIDIA Confidential Computing. Vous pouvez le découvrir ici :
https://phala.com/models/jaredpalmer/kev-4b
Les décisions prises par les agents impliquent souvent d’interagir avec les messages des clients, les documents de politique et l’état des approbations. Nous sommes ravis d’annoncer que Kev-4B est actuellement accessible en version bêta sur Phala, grâce à NVIDIA Confidential Computing. Vous pouvez le découvrir ici :
https://phala.com/models/jaredpalmer/kev-4b
https://phala.com/models/jaredpalmer/kev-4b
83
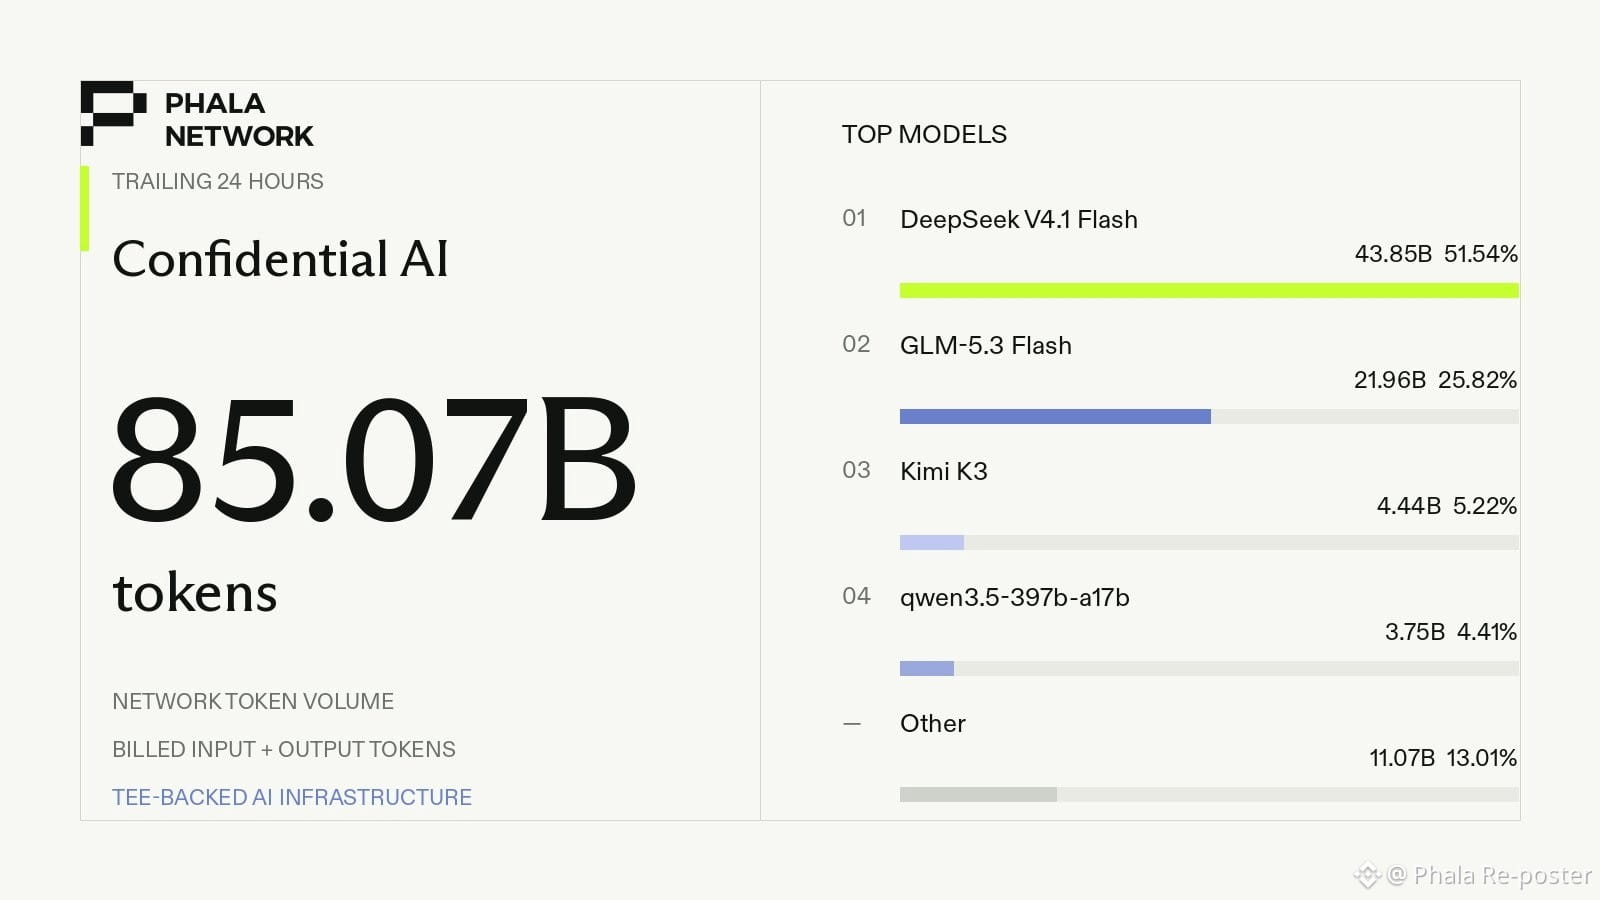
Au cours des dernières 24 heures, notre infrastructure d'IA sécurisée par TEE chez Phala Confidential AI a traité avec succès un total de 85,07 milliards de tokens. Nous sommes heureux de partager la répartition de nos modèles les plus utilisés durant cette période. DeepSeek V4.1 Flash est arrivé en tête, représentant 51,54 % de toute l'activité. GLM-5.3 Flash a suivi avec une part de 25,82 %, tandis que Kimi K3 a représenté 5,22 % de l'utilisation. Vous pouvez trouver plus d'informations sur notre modèle principal en vous rendant sur https://phala.com/models/deepseek/deepseek-v4.1-flash
Au cours des dernières 24 heures, notre infrastructure d'IA sécurisée par TEE chez Phala Confidential AI a traité avec succès un total de 85,07 milliards de tokens. Nous sommes heureux de partager la répartition de nos modèles les plus utilisés durant cette période. DeepSeek V4.1 Flash est arrivé en tête, représentant 51,54 % de toute l'activité. GLM-5.3 Flash a suivi avec une part de 25,82 %, tandis que Kimi K3 a représenté 5,22 % de l'utilisation. Vous pouvez trouver plus d'informations sur notre modèle principal en vous rendant sur https://phala.com/models/deepseek/deepseek-v4.1-flash
60
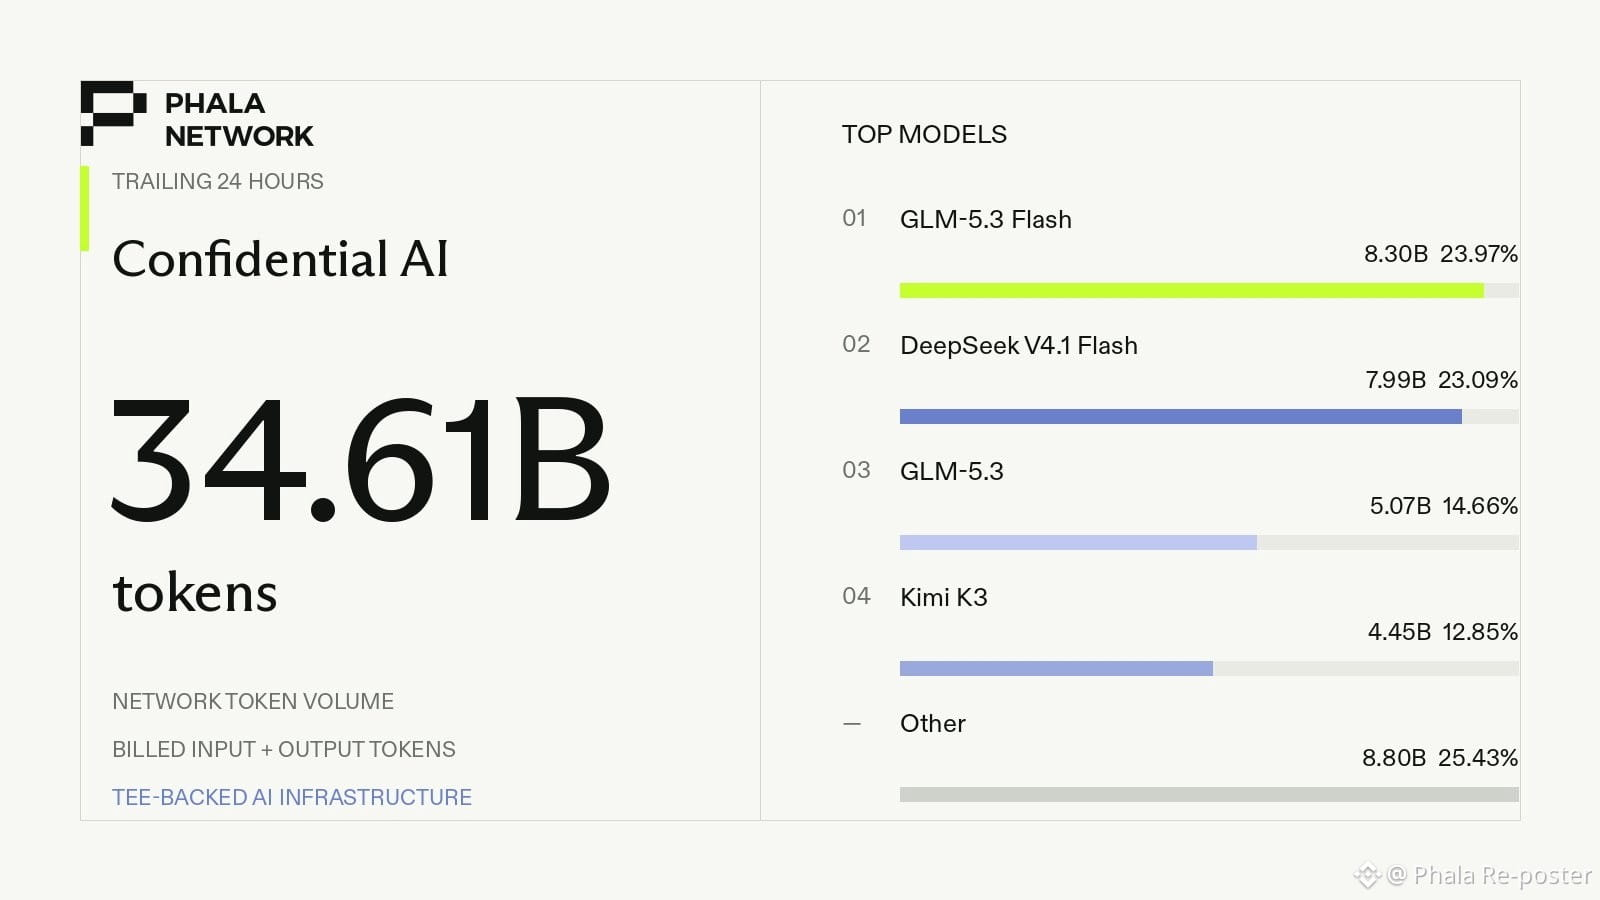
Au cours des dernières 24 heures, l’infrastructure d’IA protégée par TEE, connue sous le nom de Phala Confidential AI, a traité avec succès un total de 34,61 milliards de tokens.
Pendant cette période, l’activité a été principalement portée par trois choix. Le plus utilisé était GLM-5.3 Flash, qui représentait 23,97 % du volume total. DeepSeek V4.1 Flash arrivait juste derrière, avec une part de 23,09 %, tandis que le modèle standard GLM-5.3 représentait 14,66 % de l’utilisation.
Pour découvrir plus en détail le modèle le plus populaire, rendez-vous directement sur https://phala.com/models/z-ai/glm-5.3-flash.
Au cours des dernières 24 heures, l’infrastructure d’IA protégée par TEE, connue sous le nom de Phala Confidential AI, a traité avec succès un total de 34,61 milliards de tokens.
Pendant cette période, l’activité a été principalement portée par trois choix. Le plus utilisé était GLM-5.3 Flash, qui représentait 23,97 % du volume total. DeepSeek V4.1 Flash arrivait juste derrière, avec une part de 23,09 %, tandis que le modèle standard GLM-5.3 représentait 14,66 % de l’utilisation.
Pour découvrir plus en détail le modèle le plus populaire, rendez-vous directement sur https://phala.com/models/z-ai/glm-5.3-flash.
Pendant cette période, l’activité a été principalement portée par trois choix. Le plus utilisé était GLM-5.3 Flash, qui représentait 23,97 % du volume total. DeepSeek V4.1 Flash arrivait juste derrière, avec une part de 23,09 %, tandis que le modèle standard GLM-5.3 représentait 14,66 % de l’utilisation.
Pour découvrir plus en détail le modèle le plus populaire, rendez-vous directement sur https://phala.com/models/z-ai/glm-5.3-flash.
77
Comme votre agent de programmation est capable d’analyser l’ensemble de votre base de code, il est essentiel de garder ces informations en sécurité. Avant que ce contexte soit autorisé à quitter votre ordinateur, Private AI Proxy intervient pour authentifier le service d’IA. Le logiciel garantit cette protection en mettant en œuvre un transfert « fail-closed », une attestation matérielle et un épinglage des clés TLS.
Vous pouvez télécharger la version Mac dès aujourd’hui via le lien suivant :
https://apps.apple.com/app/private-ai-proxy/id6814051406
Comme votre agent de programmation est capable d’analyser l’ensemble de votre base de code, il est essentiel de garder ces informations en sécurité. Avant que ce contexte soit autorisé à quitter votre ordinateur, Private AI Proxy intervient pour authentifier le service d’IA. Le logiciel garantit cette protection en mettant en œuvre un transfert « fail-closed », une attestation matérielle et un épinglage des clés TLS.
Vous pouvez télécharger la version Mac dès aujourd’hui via le lien suivant :
https://apps.apple.com/app/private-ai-proxy/id6814051406
Vous pouvez télécharger la version Mac dès aujourd’hui via le lien suivant :
https://apps.apple.com/app/private-ai-proxy/id6814051406
75
Veuillez noter que le lien officiel d’invitation pour notre serveur Discord a récemment été modifié. Notre URL précédente, à savoir https://discord.com/invite/phala-network, est désormais expirée et ne fonctionnera plus. Nous vous prions de commencer à utiliser notre nouvelle adresse générée pour rejoindre la communauté : https://discord.gg/saGuzKq5Wm.
Les annonces sur CoinMarketCap et CoinGecko refléteront cette mise à jour dans les prochains jours. Pendant que ces changements sont en cours, veuillez rester vigilant contre les escroqueries potentielles et vérifier systématiquement que vous évitez tout URL frauduleux.
Veuillez noter que le lien officiel d’invitation pour notre serveur Discord a récemment été modifié. Notre URL précédente, à savoir https://discord.com/invite/phala-network, est désormais expirée et ne fonctionnera plus. Nous vous prions de commencer à utiliser notre nouvelle adresse générée pour rejoindre la communauté : https://discord.gg/saGuzKq5Wm.
Les annonces sur CoinMarketCap et CoinGecko refléteront cette mise à jour dans les prochains jours. Pendant que ces changements sont en cours, veuillez rester vigilant contre les escroqueries potentielles et vérifier systématiquement que vous évitez tout URL frauduleux.
Les annonces sur CoinMarketCap et CoinGecko refléteront cette mise à jour dans les prochains jours. Pendant que ces changements sont en cours, veuillez rester vigilant contre les escroqueries potentielles et vérifier systématiquement que vous évitez tout URL frauduleux.
68
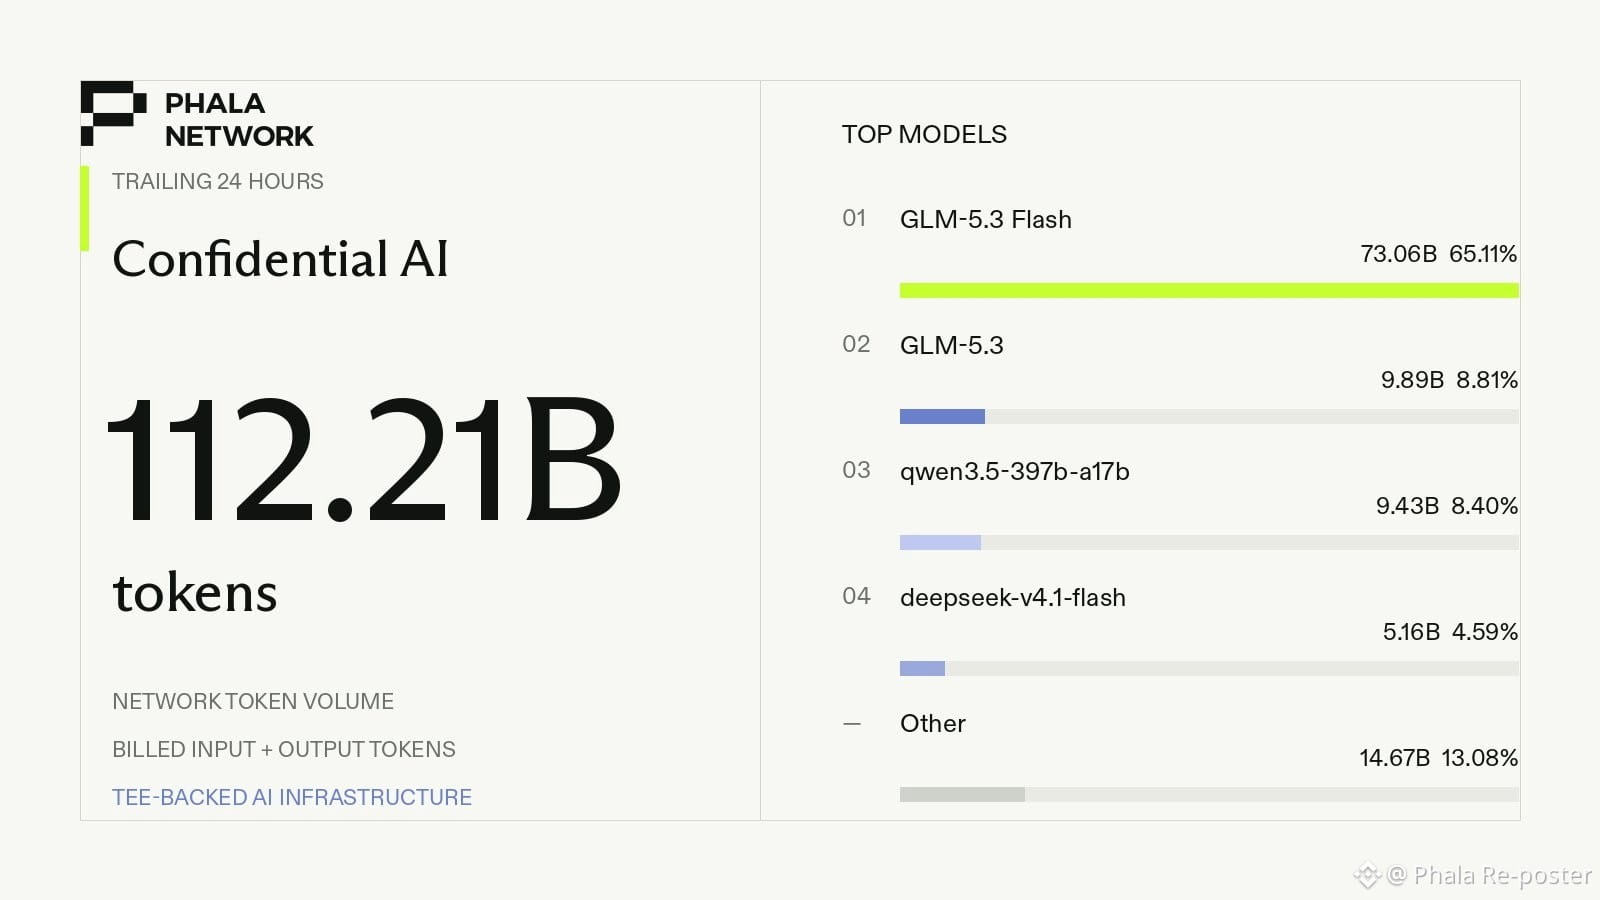
Au cours des dernières 24 heures, le réseau d’IA Phala Confidential a traité avec succès un volume impressionnant de 112,21 milliards de jetons. Pendant cette période, quelques options précises se sont démarquées comme étant les modèles les plus utilisés. Le modèle GLM-5.3 Flash a mené l’activité en traitant 65,11 % du volume total. Il a été suivi par le modèle standard GLM-5.3, qui a représenté 8,81 %, et par le modèle qwen3.5-397b-a17b, juste derrière avec 8,40 %.
Pour explorer plus en détail le modèle leader, vous pouvez visiter https://phala.com/models/z-ai/glm-5.3-flash. Cet écosystème complet fonctionne sur une infrastructure d’IA sécurisée adossée à un TEE, garantissant un environnement robuste et protégé pour tous les utilisateurs.
Au cours des dernières 24 heures, le réseau d’IA Phala Confidential a traité avec succès un volume impressionnant de 112,21 milliards de jetons. Pendant cette période, quelques options précises se sont démarquées comme étant les modèles les plus utilisés. Le modèle GLM-5.3 Flash a mené l’activité en traitant 65,11 % du volume total. Il a été suivi par le modèle standard GLM-5.3, qui a représenté 8,81 %, et par le modèle qwen3.5-397b-a17b, juste derrière avec 8,40 %.
Pour explorer plus en détail le modèle leader, vous pouvez visiter https://phala.com/models/z-ai/glm-5.3-flash. Cet écosystème complet fonctionne sur une infrastructure d’IA sécurisée adossée à un TEE, garantissant un environnement robuste et protégé pour tous les utilisateurs.
Pour explorer plus en détail le modèle leader, vous pouvez visiter https://phala.com/models/z-ai/glm-5.3-flash. Cet écosystème complet fonctionne sur une infrastructure d’IA sécurisée adossée à un TEE, garantissant un environnement robuste et protégé pour tous les utilisateurs.
85
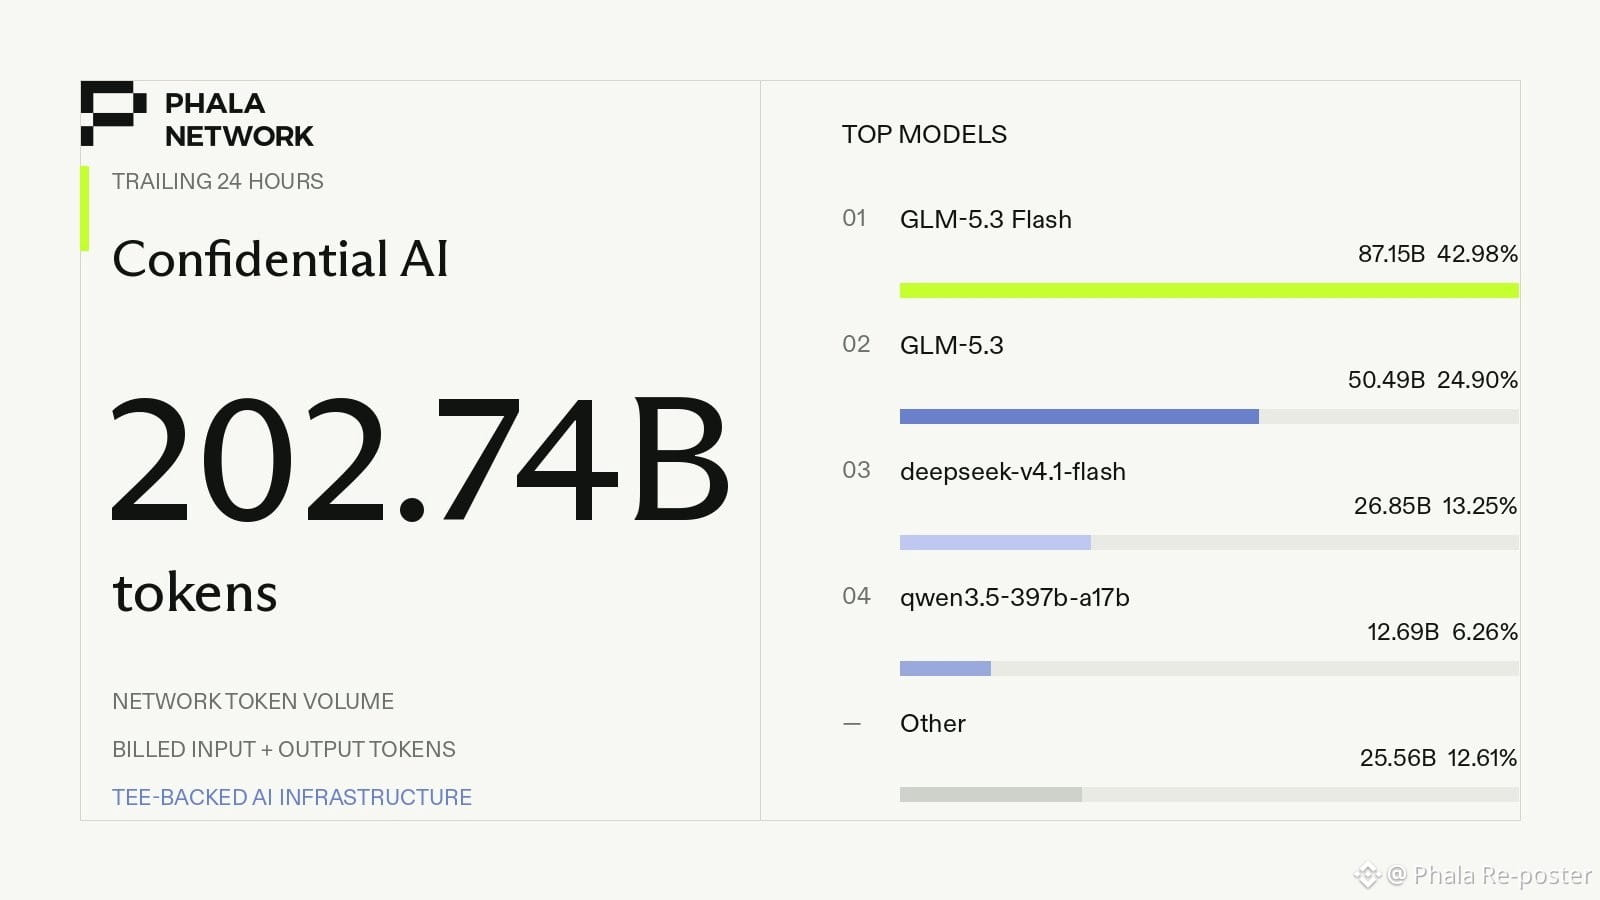
Conçu sur une infrastructure d’IA robuste adossée à un TEE, Phala Confidential AI a traité avec succès 202,74 milliards de jetons remarquables au cours des dernières 24 heures.
Une analyse de cette activité récente met en évidence les modèles les plus utilisés pendant cette période. En tête, on trouve GLM-5.3 Flash, qui représentait 42,98 % du volume total. Le modèle GLM-5.3 suivait de près avec une part de 24,90 %, tandis que deepseek-v4.1-flash a capturé 13,25 % de l’utilisation.
Vous pouvez explorer davantage d’informations directement via ce lien :
https://phala.com/models/z-ai/glm-5.3-flash
Conçu sur une infrastructure d’IA robuste adossée à un TEE, Phala Confidential AI a traité avec succès 202,74 milliards de jetons remarquables au cours des dernières 24 heures.
Une analyse de cette activité récente met en évidence les modèles les plus utilisés pendant cette période. En tête, on trouve GLM-5.3 Flash, qui représentait 42,98 % du volume total. Le modèle GLM-5.3 suivait de près avec une part de 24,90 %, tandis que deepseek-v4.1-flash a capturé 13,25 % de l’utilisation.
Vous pouvez explorer davantage d’informations directement via ce lien :
https://phala.com/models/z-ai/glm-5.3-flash
Une analyse de cette activité récente met en évidence les modèles les plus utilisés pendant cette période. En tête, on trouve GLM-5.3 Flash, qui représentait 42,98 % du volume total. Le modèle GLM-5.3 suivait de près avec une part de 24,90 %, tandis que deepseek-v4.1-flash a capturé 13,25 % de l’utilisation.
Vous pouvez explorer davantage d’informations directement via ce lien :
https://phala.com/models/z-ai/glm-5.3-flash
65
1/ SayGM a choisi Phala Cloud comme base pour construire sa passerelle d’inférence IA axée sur la confidentialité.
Pour traiter chaque requête entrante, le système l’achemine directement vers une VM confidentielle attestée matériellement. Étant donné que cette machine virtuelle fonctionne exclusivement à partir d’une image approuvée et épinglée, la charge de travail sous-jacente associée à chaque requête demeure entièrement et indépendamment vérifiable.
https://saygm.com
1/ SayGM a choisi Phala Cloud comme base pour construire sa passerelle d’inférence IA axée sur la confidentialité.
Pour traiter chaque requête entrante, le système l’achemine directement vers une VM confidentielle attestée matériellement. Étant donné que cette machine virtuelle fonctionne exclusivement à partir d’une image approuvée et épinglée, la charge de travail sous-jacente associée à chaque requête demeure entièrement et indépendamment vérifiable.
https://saygm.com
Pour traiter chaque requête entrante, le système l’achemine directement vers une VM confidentielle attestée matériellement. Étant donné que cette machine virtuelle fonctionne exclusivement à partir d’une image approuvée et épinglée, la charge de travail sous-jacente associée à chaque requête demeure entièrement et indépendamment vérifiable.
https://saygm.com
63
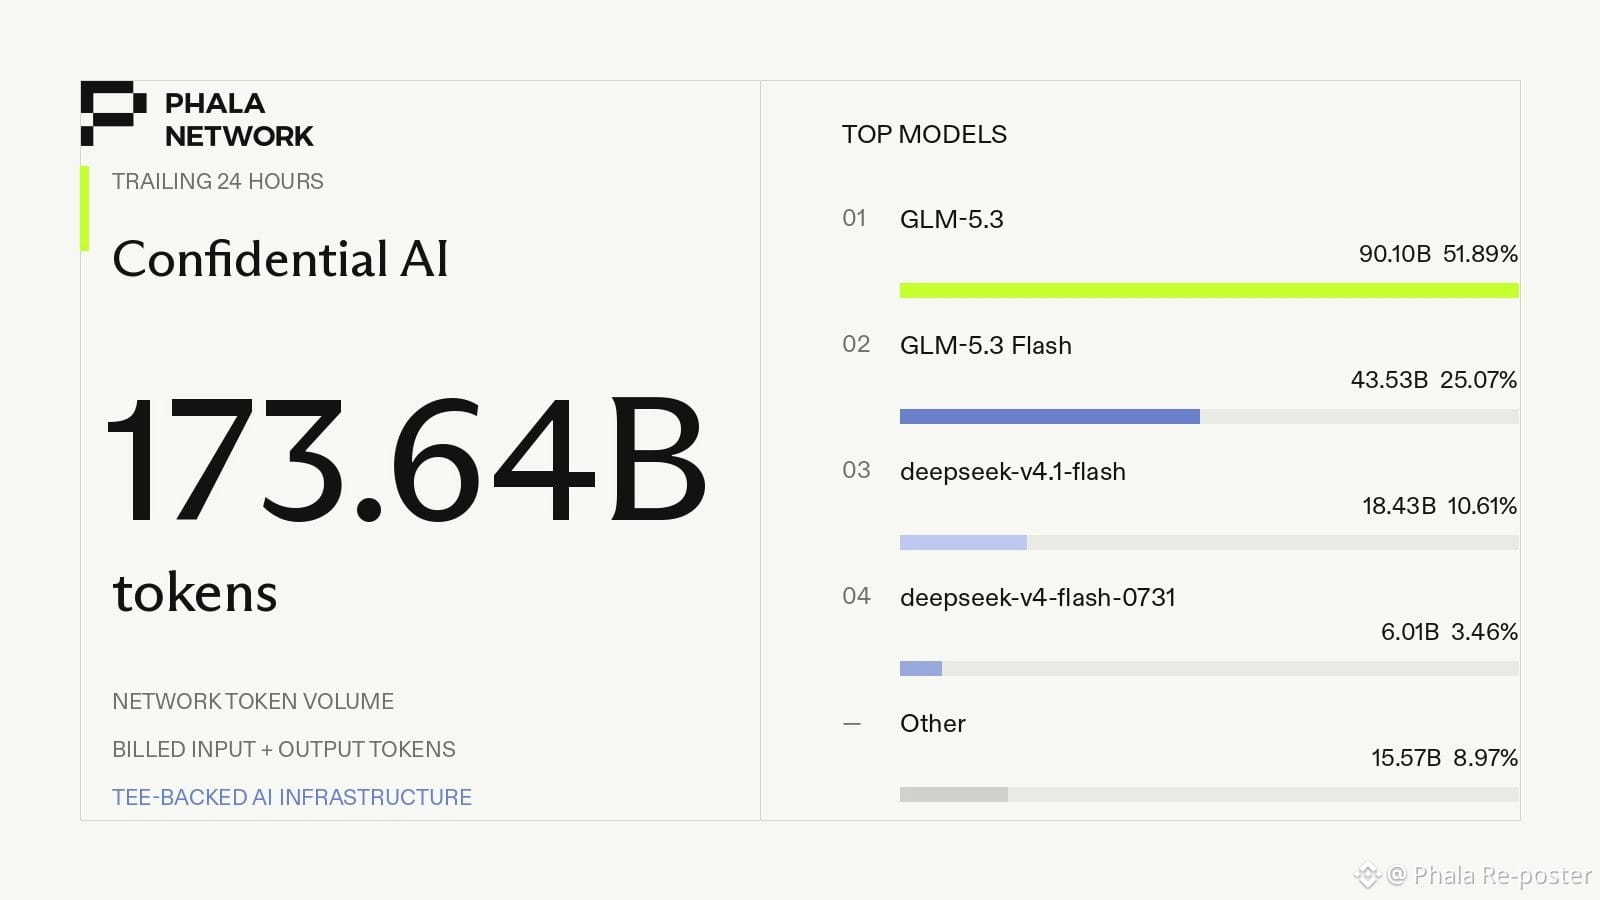
Au cours des dernières 24 heures, l’infrastructure d’IA soutenue par TEE chez Phala Confidential AI a traité avec succès un total de 173,64 milliards de jetons. Un examen plus approfondi des modèles les plus performants montre que GLM-5.3 a mené l’utilisation avec une part de 51,89 %. Il a été suivi par GLM-5.3 Flash, qui représentait 25,07 % de l’activité, et par deepseek-v4.1-flash, qui constituait 10,61 % du volume. Pour plus d’informations, veuillez consulter https://phala.com/models/z-ai/glm-5.3
Au cours des dernières 24 heures, l’infrastructure d’IA soutenue par TEE chez Phala Confidential AI a traité avec succès un total de 173,64 milliards de jetons. Un examen plus approfondi des modèles les plus performants montre que GLM-5.3 a mené l’utilisation avec une part de 51,89 %. Il a été suivi par GLM-5.3 Flash, qui représentait 25,07 % de l’activité, et par deepseek-v4.1-flash, qui constituait 10,61 % du volume. Pour plus d’informations, veuillez consulter https://phala.com/models/z-ai/glm-5.3
69
Connectez-vous pour découvrir plus de contenu
Rejoignez la communauté mondiale des adeptes de cryptomonnaies sur Binance Square
⚡️ Suviez les dernières informations importantes sur les cryptomonnaies.
💬 Jugé digne de confiance par la plus grande plateforme d’échange de cryptomonnaies au monde.
👍 Découvrez les connaissances que partagent les créateurs vérifiés.
Adresse e-mail/Nº de téléphone
Sujets d’actualité
NvidiaBeatsEstimatesAICloudStocksRiseAfterHours
5,616 vues
74 mentions
Nvidia dépasse les attentes avec un chiffre d’affaires de 115,8 milliards de dollars, prévoit 130 milliards et ajoute 150 milliards de dollars à son programme de rachats d’actions
Binance News
·8 mentions J’aime
·10.9k vues
A Packed Week of Earnings and Data Tests Markets
153,499 vues
668 mentions
AnthropicIPOTestsInvestorAppetiteForAI
338,996 vues
2,934 mentions