

À la fin de mon dernier article, j’avais annoncé trois objectifs pour le suivant : ajouter un buffer et un stop au signal de fusion, effectuer un test sur la période de validation, puis réaliser un walk-forward.
Cette fois, je n’ai pas suivi cet ordre.
Après avoir ajouté les données jusqu’au 21 octobre, j’ai d’abord fait tourner les neuf stratégies sur la nouvelle fenêtre prospective, puis réexaminé la structure des drawdowns sur la période de test. Résultat : j’en garde trois et je supprime les six autres, ainsi que leurs fichiers de stratégie et leurs résultats de backtest.
Les six stratégies supprimées ne sont pas déficitaires. Cinq affichent un rendement supérieur à +115% sur la période de test, et la meilleure atteint +152.67%. Mais leur drawdown maximal se situe entre -21.8% et -54.8%, et elles sont restées sous l’eau jusqu’à 232 jours de trading. Une telle courbe peut avoir sa place dans un backtest, mais sur un compte réel, la plupart des gens ne tiendraient pas jusqu’au retour à l’équilibre.
Cette fois, j’ai donc commencé par réduire la voilure. Je vais expliquer clairement quatre choses : pourquoi le plan a changé, selon quels critères j’ai éliminé des stratégies, ce qu’il reste après le tri et quel problème demeure sans solution.
I. Pourquoi le plan de la dernière fois a changé
La dernière livraison était un « répertoire de neuf stratégies reproductibles en un clic » : neuf fichiers de stratégie, six fichiers de signaux et un notebook ; la vérification détaillée des neuf stratégies sur neuf était concluante. L’objectif était de fiabiliser les chiffres, pas de décider quelles stratégies méritaient d’être déployées.
Le problème vient aussi de là. Le répertoire présentait les neuf stratégies côte à côte, ce qui pouvait facilement laisser croire au lecteur qu’elles étaient toutes candidates. En réalité, certaines affichaient un drawdown d’environ -50%, et leur courbe de capital n’avait pas atteint de nouveau sommet pendant six mois. Elles figuraient dans le répertoire parce que la tâche était alors de reproduire les résultats, pas de faire une sélection.
Continuer, dans ces conditions, à ajouter un stop à la stratégie de fusion et à effectuer un walk-forward reviendrait à empiler des fonctionnalités sur des stratégies inutilisables. Plus on ajoute de fonctionnalités, plus il devient difficile de distinguer ensuite si le problème vient du signal, de la gestion du risque ou de l’exécution.
Autre changement : les données du 1er au 21 octobre sont arrivées. C’est la première période après la période de test qui n’a participé à aucun choix. Elle ne couvre que 21 jours, mais suffit pour un premier bilan de santé.
L’ordre a donc changé : commencer par filtrer les stratégies selon leur profil de risque sur la période de test et réduire leur nombre à trois ; utiliser ensuite octobre pour une validation prospective ; puis seulement revenir à l’ajout d’un stop à la fusion et au walk-forward. La maintenance porte désormais sur trois stratégies au lieu de neuf, ce qui accélère en fait la suite du travail.
Le test sur la période de validation n’a pas été réalisé non plus cette fois-ci. VALID a participé à l’arrêt anticipé du modèle et ne peut être considérée que comme un demi-échantillon interne ; en termes de propreté, elle est moins bonne que ces 21 jours d’octobre. Une fois le problème d’exécution de stop10 réglé, j’ajouterai le test de validation et le walk-forward.
II. Les deux méthodes de calcul du Calmar, une mise au point
Le Calmar de la stratégie de fusion indiqué dans le dernier article était de 7.49, tandis que le tableau de sélection de cette édition affiche 9.38. Deux chiffres pour une même stratégie : il faut d’abord expliquer pourquoi.
Les deux sont corrects, mais les méthodes de calcul diffèrent. 7.49 est annualisé : le rendement total sur 457 jours est annualisé au prorata de 365/457, puis divisé par le drawdown maximal. 9.38 est calculé sur la période : le rendement total sur 457 jours est directement divisé par le drawdown maximal. La période de test dépassant un an, l’annualisation réduit le numérateur, d’où un résultat de 7.49 inférieur à 9.38.
Les seuils de cette édition reposent sur le calcul sur la période ; le chiffre de 9.38 est donc à comparer au seuil de 7. Selon la méthode annualisée, les trois stratégies conservées affichent respectivement un Calmar de 7.49, 6.43 et 6.33.
À l’avenir, quand vous verrez un Calmar, demandez d’abord de quelle méthode de calcul il s’agit. Comparer des chiffres calculés différemment peut fausser le classement des stratégies.
III. Quatre critères : d’abord le drawdown, ensuite le rendement
La sélection porte uniquement sur la période de test, du 1er juillet 2025 au 30 septembre 2026, soit 457 jours, avec un capital initial de 10 millions. Quatre critères :
- Drawdown maximal inférieur ou égal à 20%
- Calmar (rendement total sur la période divisé par le drawdown maximal) supérieur ou égal à 7
- Indice Ulcer inférieur ou égal à 8
- Nombre maximal de jours sous l’eau inférieur ou égal à 110 jours de trading
Pourquoi ces quatre critères ? Le drawdown détermine si l’on peut tenir une stratégie ; le Calmar met en regard rendement et drawdown ; l’Ulcer ne se limite pas au creux le plus profond, mais tient aussi compte de la durée et de la fréquence des drawdowns ; les jours sous l’eau offrent la mesure la plus intuitive : après une baisse depuis un sommet, combien de jours faut-il pour y revenir ? Ces quatre indicateurs répondent tous à la même question : peut-on supporter cette courbe ?
Le rendement ne fait pas partie des critères. La raison est simple : une stratégie très rentable, mais avec un drawdown de -50%, ne survit généralement pas assez longtemps en conditions réelles pour que ses gains se concrétisent.
Les données d’octobre n’ont pas participé à la sélection. Avec seulement 21 jours, utiliser cette période pour choisir les stratégies reviendrait à demander à l’arbitre de participer à la compétition. Octobre sert uniquement à la validation, pas à la sélection.
Il faut être honnête sur un point : j’ai défini ces quatre critères après avoir examiné les résultats des neuf stratégies. Ce sont donc des critères a posteriori, et non des règles fixées à l’avance. Ils m’aident à prendre des décisions cohérentes, mais ne constituent pas une preuve au sens statistique.
IV. Bilan des neuf stratégies
Classement par Calmar décroissant :
| Stratégie | Rendement | Drawdown maximal | Calmar | Sharpe | Ulcer | Jours sous l’eau | Conclusion |
|---|---:|---:|---:|---:|---:|---:|---|
| Fusion top5 | +172.93% | -18.44% | 9.38 | 2.076 | 7.59 | 107 | Conservée |
| Modèle buf4 stop 10 | +130.86% | -16.25% | 8.05 | 1.906 | 6.10 | 96 | Conservée |
| Modèle long buf5 stop 10 | +114.01% | -14.39% | 7.92 | 1.846 | 4.84 | 75 | Conservée |
| mom10 top5 long buf5 | +152.67% | -30.13% | 5.07 | 1.577 | 13.48 | 171 | Éliminée |
| Modèle buf4 stop 35 | +151.47% | -31.42% | 4.82 | 1.635 | 11.90 | 123 | Éliminée |
| mom10 top5 | +134.22% | -39.03% | 3.44 | 1.385 | 13.93 | 171 | Éliminée |
| mom10 top20 long buf5 | +68.98% | -21.81% | 3.16 | 1.563 | 6.92 | 109 | Éliminée |
| Modèle buf4 | +137.55% | -54.80% | 2.51 | 1.368 | 22.31 | 219 | Éliminée |
| Modèle long buf5 | +115.08% | -51.89% | 2.22 | 1.174 | 25.96 | 232 | Éliminée |
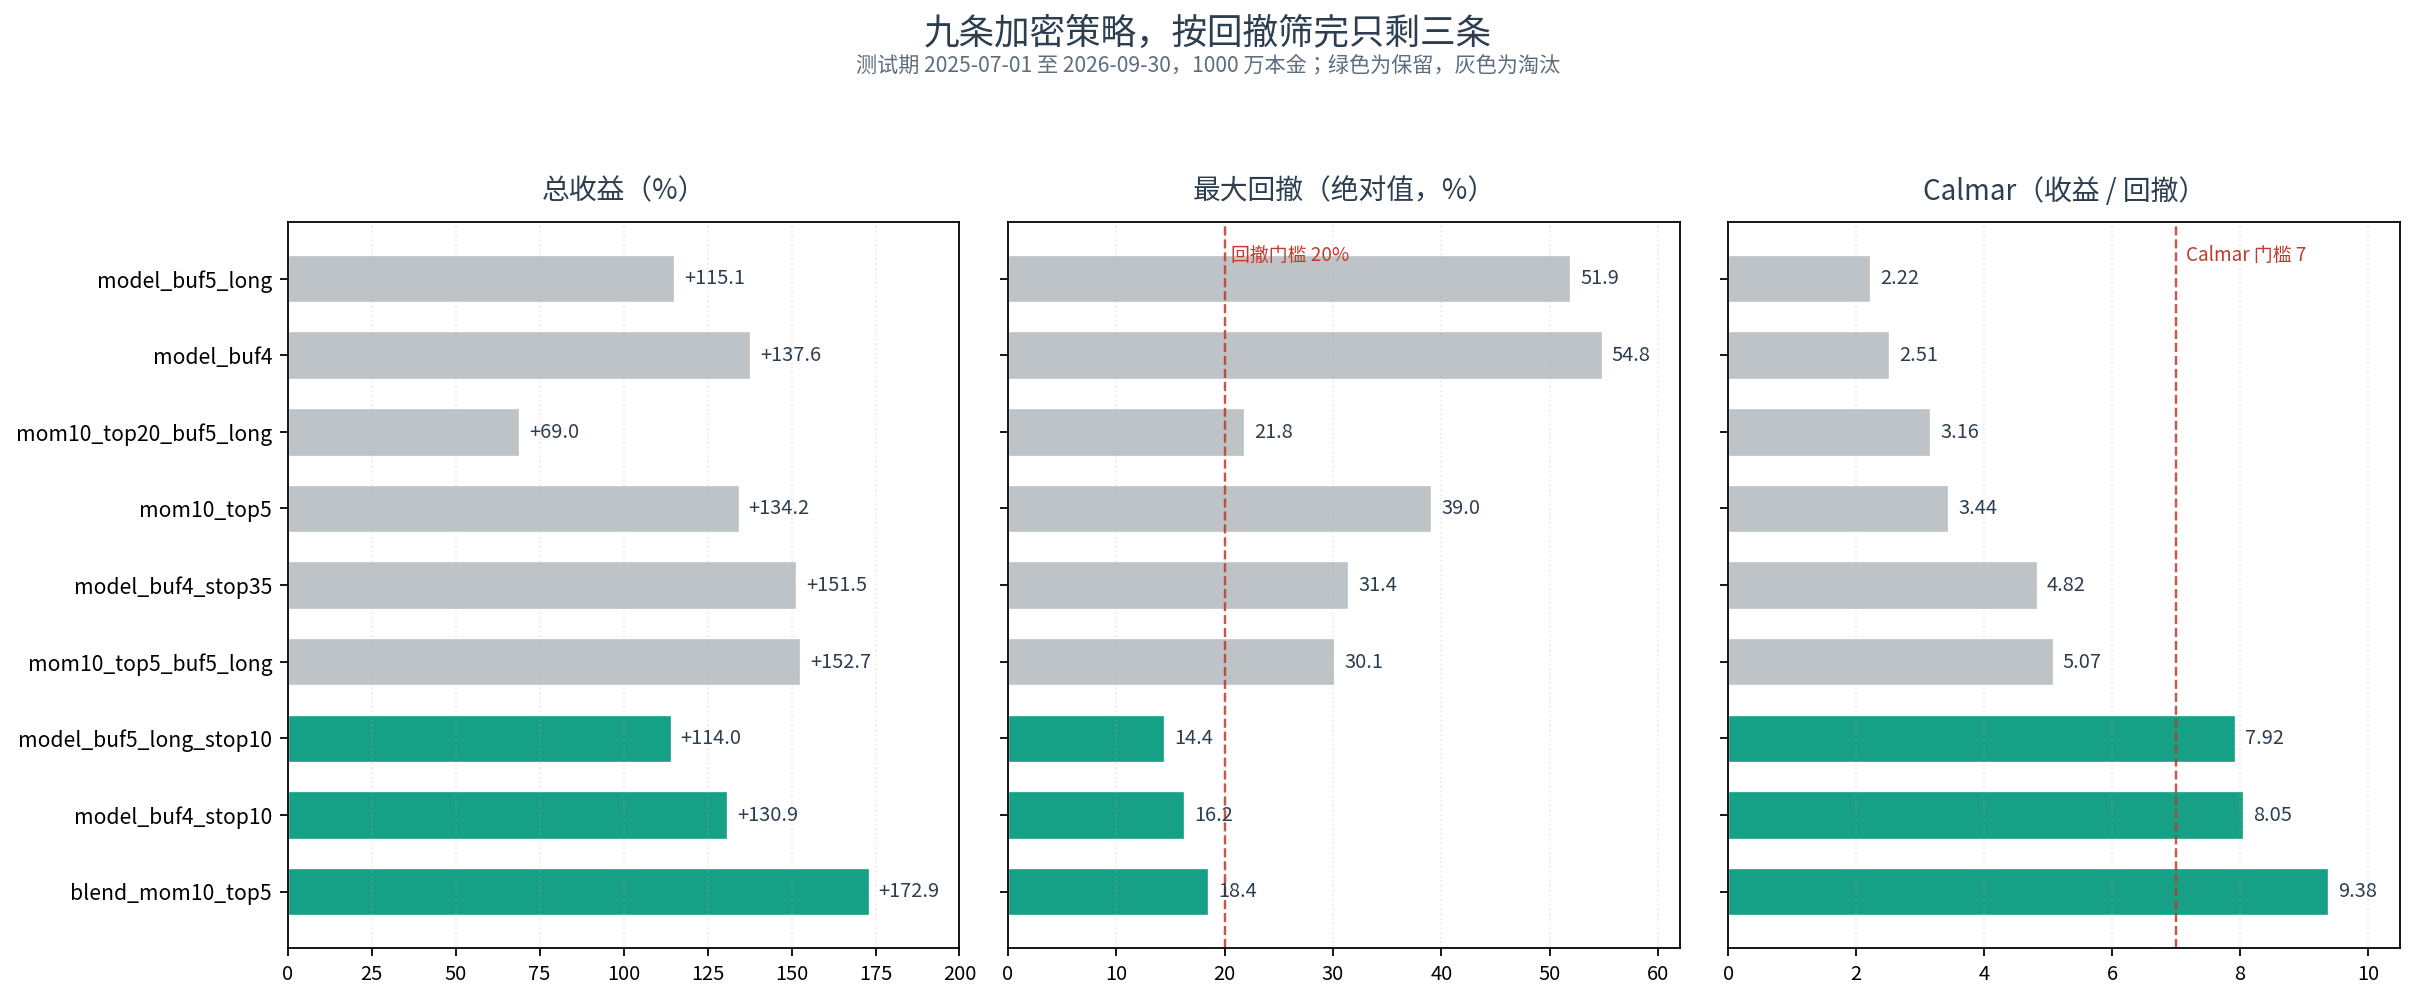
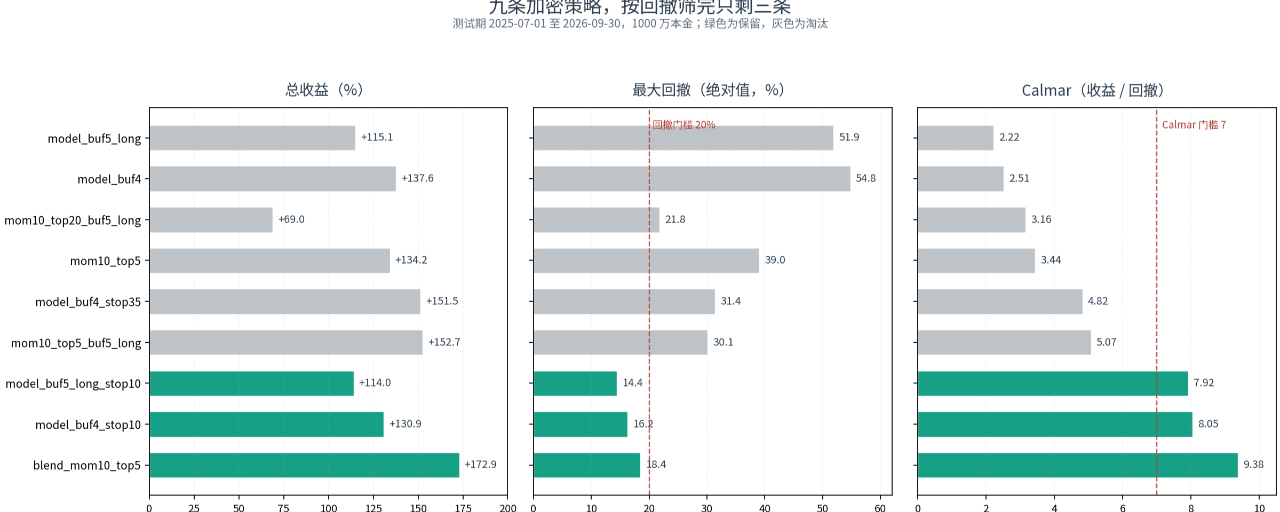
Figure 1 : rendement à gauche, drawdown maximal au centre et Calmar à droite. Les stratégies conservées sont en vert, celles éliminées en gris. Les lignes pointillées indiquent les seuils de drawdown de 20% et de Calmar de 7.
La séparation est nette. Les trois stratégies conservées ont toutes un Calmar supérieur à 7.9, un Ulcer inférieur ou égal à 7.6 et au plus 107 jours sous l’eau. Parmi les six éliminées, le Calmar le plus élevé est de 5.07 et l’Ulcer le plus faible de 6.92.
À noter : la stratégie mom10 top20. Son drawdown est de -21.81%, soit seulement 1.8 point de pourcentage au-dessus du seuil ; son Ulcer est de 6.92, donc inférieur à 8 ; et ses 109 jours sous l’eau restent juste sous la limite de 110. À l’aune de ces trois indicateurs, elle n’est pas loin de satisfaire aux critères. Mais son Calmar n’est que de 3.16 : le rendement est trop dilué, elle ne passe donc toujours pas.
V. Pourquoi six stratégies ont été supprimées
Voyons-les une par une.
Modèle buf4, +137.55%, drawdown de -54.80%. Cette version combine le signal du modèle et un buffer4 dans les deux sens. Le buffer a fait passer le rendement de négatif à +137%, mais le drawdown reste de -54.80%. Modifier le niveau de buffer ne change presque rien au drawdown. Cette stratégie montre bien que le buffer ne peut pas, à lui seul, servir de gestion du risque : il améliore la rotation et la stabilité du classement, mais ne maîtrise pas les pertes extrêmes.
Modèle long buf5, +115.08%, drawdown de -51.89%. En fixant le buffer des positions longues à 5 et en n’appliquant aucun buffer aux positions courtes, le drawdown passe seulement de -54.80% à -51.89%. Avec un Ulcer de 25.96 et 232 jours sous l’eau, cette stratégie affiche les pires résultats des neuf sur ces deux critères.
Modèle buf4 stop 35, +151.47%, drawdown de -31.42%. Son rendement arrive en troisième position, ce qui pourrait laisser penser qu’il faut la conserver. Mais son drawdown dépasse 30%, son Calmar est de 4.82 et elle passe 123 jours sous l’eau. Un stop à 35% sur une seule crypto est trop laxiste compte tenu de la volatilité du marché crypto : quand il se déclenche, les pertes sont déjà importantes.
mom10 top5 long buf5, +152.67%, drawdown de -30.13%. C’est la deuxième stratégie la plus rentable des neuf et la plus rentable des six éliminées. Le problème est le même : 30% de drawdown et 171 jours sous l’eau. Même avec le deuxième meilleur rendement, elle ne franchit pas le seuil de drawdown.
mom10 top5, +134.22%, drawdown de -39.03%. Une stratégie momentum top5 pure, sans buffer ni stop. Les facteurs momentum présentent naturellement une queue épaisse ; la pire perte sur une journée atteint -13.10%.
mom10 top20 long buf5, +68.98%, drawdown de -21.81%. C’est la stratégie au drawdown le plus faible parmi les six éliminées. Mais son Calmar n’est que de 3.16 : le rendement est dilué de moitié par la diversification. Elle démontre autre chose : répartir les positions ne rend pas une stratégie meilleure, cela la rend seulement plus petite.
VI. Trois enseignements à retenir
Premièrement, le stop est le principal levier de réduction du drawdown, pas le buffer.
Avec la même famille de signaux de modèle, j’ai fixé un buffer4 symétrique et comparé trois variantes. Sans ajout : +137.55%, drawdown de -54.80%. Avec un stop de 35% sur chaque crypto : +151.47%, drawdown de -31.42%. Avec un stop de 10% sur chaque crypto : +130.86%, drawdown de -16.25%. En remplaçant ensuite le buffer par un buffer de 5 sur les positions longues et de 0 sur les positions courtes, sans stop, le drawdown est de -51.89% : presque inchangé.
Les quatre courbes réunies donnent un résultat sans ambiguïté. Pour réduire le drawdown, il faut d’abord mettre en place un stop ; le buffer sert surtout à gérer la rotation et la stabilité du classement, pas à maîtriser les pertes extrêmes.
Deuxièmement, un faible nombre de déclenchements ne signifie pas un faible risque.
Le stop à 35% s’est déclenché 121 fois pendant la période de test, contre 646 fois pour le stop à 10%. Le stop à 35% semble plus tranquille, mais les drawdowns sont respectivement de -31.42% et -16.25%. L’explication est simple : les déclenchements sont moins fréquents parce qu’il faut perdre 35% avant de couper, mais chaque perte est importante ; ils sont plus fréquents avec un stop à 10%, mais chaque perte est moindre. Pour évaluer un stop, on ne peut pas se contenter de compter les déclenchements : il faut tenir compte de la perte par déclenchement et du nombre de déclenchements consécutifs possibles dans une fenêtre de stress.
Il faut d’abord estimer combien de déclenchements consécutifs pourraient avoir lieu pendant une fenêtre de stress, puis fixer le seuil. À 10%, on coupe dès que la perte est faible. À 35%, le stop tient davantage du stop psychologique : on se dit « j’ai mis un stop », mais au moment où il se déclenche, le compte a déjà subi de sérieux dégâts.
Troisièmement, la diversification réduit tout proportionnellement, mais n’améliore pas l’efficacité ajustée du risque.
En passant de mom10 top5 à top20, puis en ajoutant un buffer5 sur les positions longues, la volatilité annualisée passe de 63.1% à 29.6% et le drawdown de -39.03% à -21.81%. Le risque semble avoir été divisé par deux. Mais le rendement passe de 134.22% à 68.98% et le Calmar de 3.44 à 3.16. Le rendement et le risque diminuent ensemble, mais l’efficacité est en fait moindre.
Si l’objectif est de réduire le risque, il est plus simple de réduire directement le levier. La diversification est utile pour éviter d’avoir une position trop importante sur une seule crypto, mais pas pour améliorer le Sharpe.
Autre constat plus élémentaire : le classement par rendement peut être trompeur. Selon le rendement, stop35 arrive troisième et mom10 long buf5 deuxième : il faudrait donc les conserver. Selon le Calmar et le drawdown, elles ne franchissent même pas les seuils. Pour choisir une stratégie, il faut d’abord regarder si l’on peut la tenir, puis combien elle peut rapporter.
VII. Les trois stratégies conservées correspondent à trois niveaux de risque
| Stratégie | Profil | Rendement | Drawdown maximal | Calmar | Sharpe | Ulcer | Jours sous l’eau |
|---|---|---:|---:|---:|---:|---:|---:|
| Fusion top5 | Rendement maximal, sans stop | +172.93% | -18.44% | 9.38 | 2.076 | 7.59 | 107 |
| Modèle buf4 stop 10 | Équilibre entre rendement et drawdown | +130.86% | -16.25% | 8.05 | 1.906 | 6.10 | 96 |
| Modèle long buf5 stop 10 | Drawdown minimal, courbe la plus régulière | +114.01% | -14.39% | 7.92 | 1.846 | 4.84 | 75 |
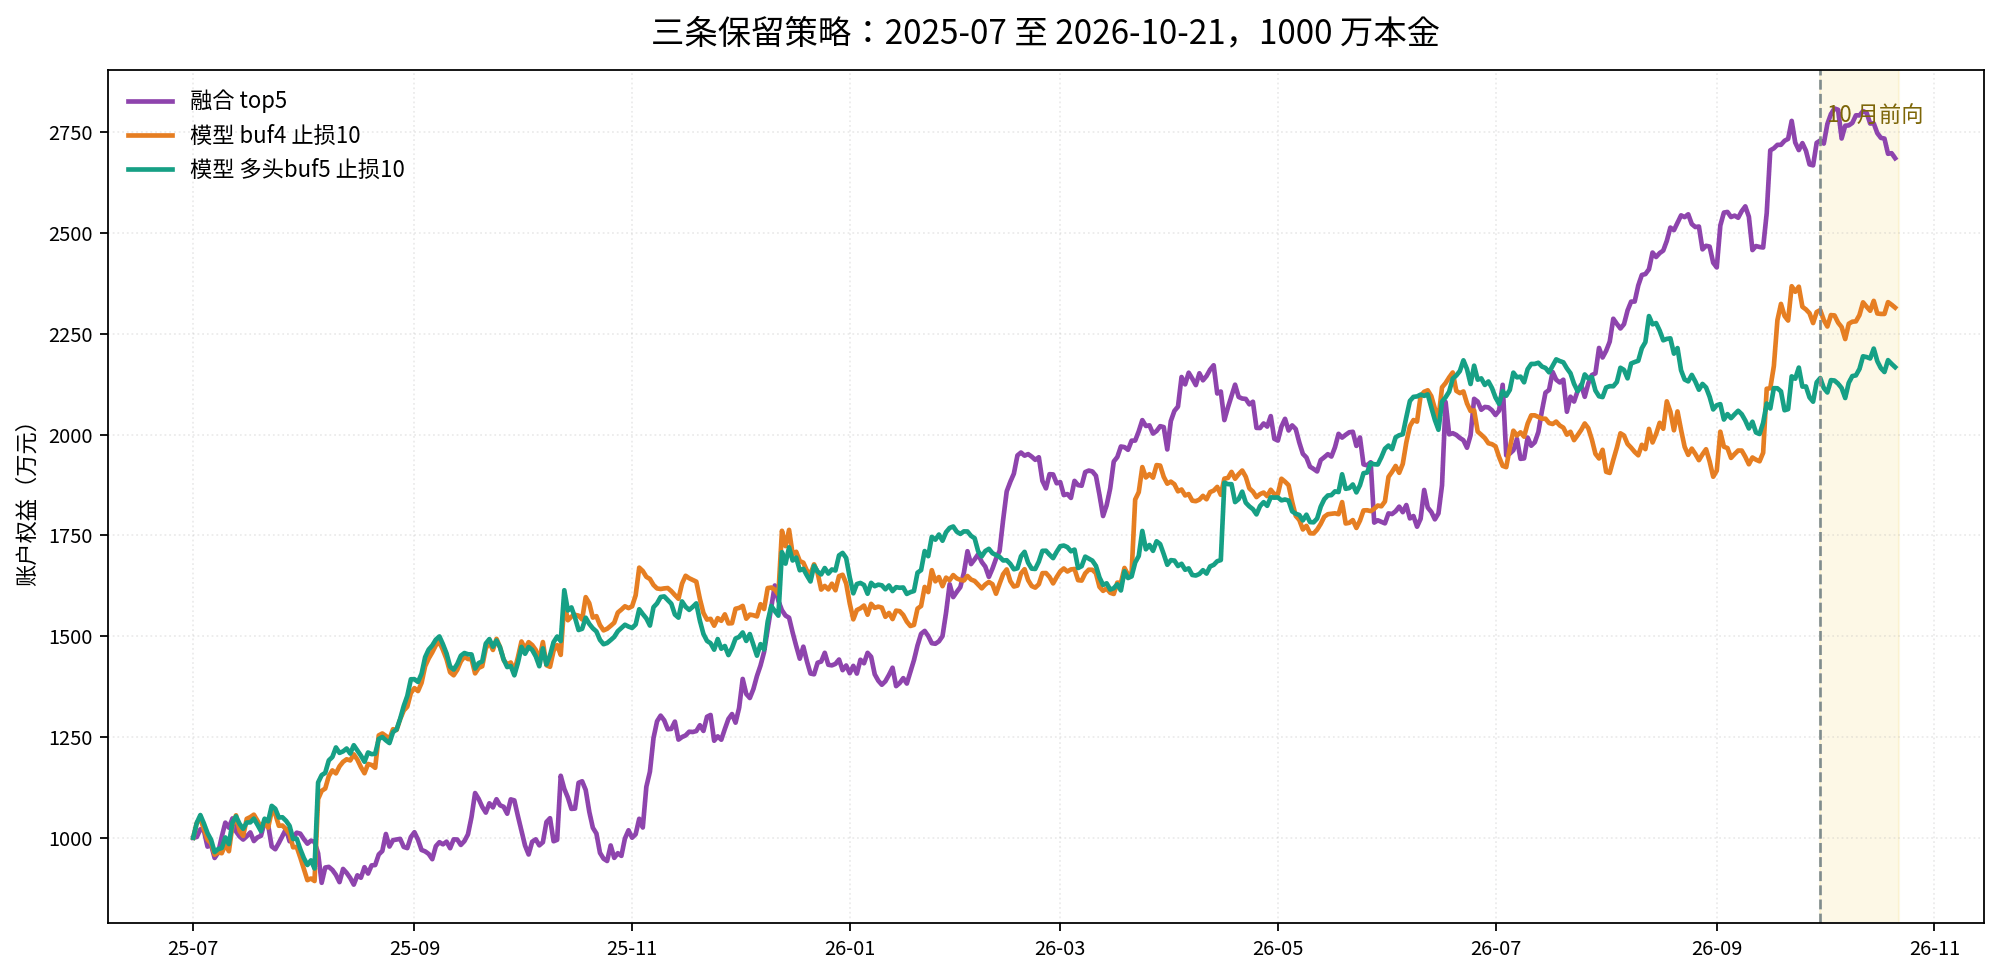
Figure 2 : ces trois stratégies ont été testées du 1er juillet 2025 au 21 octobre 2026, avec un capital initial de 10 millions. La partie prospective d’octobre se trouve à droite de la ligne pointillée.
Il ne s’agit pas de « choisir les trois meilleures parmi des stratégies similaires », mais de retenir trois niveaux de risque différents.
Fusion top5 affiche le rendement le plus élevé et le meilleur résultat ajusté du risque, mais elle n’a pas de stop. C’est pourquoi, pendant le mois de baisse d’octobre, son drawdown a été le plus important des trois. La dernière fois, j’avais promis d’ajouter un stop à la stratégie de fusion ; je ne l’ai pas fait cette fois-ci. J’expliquerai pourquoi plus loin.
Modèle buf4 stop 10 est la variante intermédiaire. Un buffer4 des deux côtés, associé à un stop de 10% sur chaque crypto, offre un équilibre raisonnable entre rendement et drawdown.
Modèle long buf5 stop 10 est la variante défensive : buffer5 sur les positions longues, aucun buffer sur les positions courtes et stop de 10%. Son drawdown est le plus faible, son Ulcer est de 4.84 et elle ne passe que 75 jours sous l’eau. C’est la courbe la plus régulière, mais aussi celle au rendement le plus faible.
S’il ne fallait en choisir qu’une, le choix dépendrait des caractéristiques du capital et de la tolérance au drawdown. Si vous pouvez supporter un drawdown de -20% et recherchez du rendement, choisissez la fusion ; pour une courbe plus régulière, choisissez long buf5 stop 10 ; entre les deux, choisissez buf4 stop 10. C’est un compromis, pas un classement.
## VIII. Période prospective d’octobre : le stop a pour la première fois fait ses preuves sur des données prospectives
Le modèle est resté figé. Après le réentraînement, `best_iteration` est toujours à 290 ; la différence maximale entre les prédictions sur la période de test et le fichier publié la dernière fois est de 0.0. Les signaux d’octobre n’ont pas été réoptimisés.
Du 1er au 21 octobre, les 122 contrats de l’univers de signaux, pondérés de manière égale, ont baissé de 8.57% ; leur médiane a reculé de 9.82%. $BTC a progressé de 0.57%, $ETH a baissé de 7.89% et $SOL de 9.45%. Les altcoins ont baissé dans l’ensemble, tandis que le BTC évoluait sans tendance marquée.
Résultats des trois stratégies :
| Stratégie | P&L en octobre | Par rapport aux capitaux propres au 30/09 | Par rapport à 10 millions | Drawdown maximal | Nombre de stops | Long/court |
|---|---:|---:|---:|---:|---:|---:|
| Modèle long buf5 stop 10 | +271 000 | +1.26% | +2.71% | -2.63% | 24 | +255 000 / +15 000 |
| Modèle buf4 stop 10 | +61 000 | +0.27% | +0.61% | -3.11% | 22 | +61 000 / +1 000 |
| Fusion top5 | -439 000 | -1.61% | -4.39% | -4.39% | 0 | -537 000 / +98 000 |
Je présente les résultats selon deux modes de calcul. Par rapport aux capitaux propres au 30/09, car les gains se sont composés pendant la période de test et que les capitaux propres des trois stratégies se situaient entre 21.4 et 27.29 millions ; et par rapport à 10 millions, car la taille des ordres est toujours calculée sur une base de 10 millions, sans capitalisation des gains. Le premier chiffre correspond au rendement réel du compte ; le second reflète mieux la capacité bénéficiaire propre de la stratégie. N’annualisez pas ces chiffres sur 21 jours en les extrapolant proportionnellement.
Pendant ce mois de baisse, les deux stratégies stop10 ont toutes deux préservé un rendement positif. La fusion, sans stop, a perdu 537 000 sur sa jambe longue ; sa pire journée a été de -712 000, une perte directement répercutée sur la valeur liquidative. C’est la raison immédiate de l’écart entre les trois stratégies, et la première fois que le stop a fait ses preuves sur des données prospectives.
Mais 21 jours, c’est trop court pour tirer des conclusions à long terme. Et ce rendement positif comporte plusieurs biais qu’il faut corriger.
Premièrement, les gains sont très concentrés. Les positions des deux stratégies stop10 se recoupent largement : GTC a rapporté 603 000, MAGMA 229 000 et AKE 201 000. La meilleure journée de buf4 a rapporté 379 000, soit 21.9% de l’ensemble des gains ; les trois meilleures journées en représentent 56.9%. Le taux de journées gagnantes n’est que de 38.1%, et la perte journalière médiane est de 11 000. Autrement dit, le rendement positif repose sur quelques fortes hausses et un petit nombre de contrats. Il ne faut pas l’extrapoler en se disant qu’on gagne « tant par jour en moyenne ».
Deuxièmement, les positions n’ont pas été pleinement investies. Chacune des stratégies a une position morte sur dix : pour les deux stop10, il s’agit d’une position courte sur OMNI ; pour la fusion, d’une position courte sur VANRY. Ces contrats ont été radiés sans que les positions soient clôturées : ils immobilisent une exposition notionnelle de 1 million sans générer ni gain ni perte. En octobre, l’exposition notionnelle active moyenne des deux stratégies de modèle n’était que de 6.47 à 6.57 millions, contre 9.97 millions pour la fusion. Les rendements positifs de stop10 ont été obtenus avec environ 65% de l’exposition. Il s’agit d’un problème connu du moteur de backtest, qui n’a pas été causé par cette mise à jour des données et figure déjà sur la liste des corrections à apporter.
Troisièmement, les frais de financement ne sont pas inclus dans le backtest principal. Une estimation a posteriori à partir des positions en fin de journée donne 72 000 reçus pour la fusion et 88 000 à 89 000 payés par chacune des deux stratégies stop10. Dans les trois cas, cela représente moins d’un point de pourcentage sur une base de 10 millions. La direction de l’effet est claire, mais il ne s’agit pas d’un coût calculé précisément.
Quatrièmement, un IC élevé ne signifie pas que les stratégies peuvent gagner dans les queues de distribution. L’IC moyen prospectif sur 20 jours est de 0.0760 ; il est positif sur 90% des jours de trading et se situe au 91.1e percentile des fenêtres glissantes de la période de test. Mais si l’on classe les actifs selon le même score en utilisant les rendements bruts sur 2 jours, la coupe transversale d’octobre n’est pas monotone : selon la méthode de sélection réelle de la stratégie, la moyenne des cinq premières positions longues p5 est de -3.59% sur 2 jours, celle des cinq dernières positions courtes p0 de -0.49% sur 2 jours, et l’écart long-court de -3.10%, avec un t de -2.07. Le modèle classe les rendements sur 2 jours normalisés par la volatilité ; cela ne revient pas à prévoir les rendements bruts dans les queues. Les pertes extrêmes des positions longues p5 en octobre sont principalement dues aux deux journées de forte chute du 4 et du 19 octobre. La stratégie a limité les dégâts grâce au buffer, au stop, à la jambe courte et à quelques positions gagnantes. Le diagnostic des queues ne porte que sur 19 jours de signaux : l’échantillon est trop court pour conclure autre chose que « continuer à observer ». Il ne permet pas de déclarer le modèle défaillant, et encore moins d’augmenter le levier.
## IX. Le scénario le plus inconfortable : 2% de glissement à l’exécution du stop
Le backtest suppose que le stop est exécuté à un prix proche de son niveau de déclenchement. J’ai relancé le test en ajoutant un glissement de 2% à l’exécution du stop :
| Stratégie | P&L de référence | P&L avec 2% de glissement | Rendement des capitaux propres de référence | Rendement des capitaux propres avec 2% de glissement | Drawdown de référence | Drawdown avec 2% de glissement |
|---|---:|---:|---:|---:|---:|---:|
| Modèle buf4 stop 10 | +61 000 | -385 000 | +0.27% | -3.80% | -3.11% | -8.85% |
| Modèle long buf5 stop 10 | +271 000 | -219 000 | +1.26% | -2.65% | -2.63% | -7.93% |
Les gains disparaissent complètement.
Ce résultat s’explique par un simple calcul. Chaque déclenchement du stop concerne une position de 1 million ; un glissement de 2% représente donc 20 000. En octobre, les stops se sont déclenchés 22 à 24 fois, soit un total de 400 000 à 500 000, largement suffisant pour transformer les gains de +60 000 et +270 000 en pertes.
À l’inverse, cela montre aussi que les gains de stop10 ne viennent pas d’une meilleure sélection des actifs, mais du fait que « les pertes sont coupées tôt ». Si la qualité d’exécution des stops se dégrade, cet avantage disparaît rapidement.
2% est un test de résistance, pas une prévision. Le glissement réel peut être plus faible ou plus élevé, selon la liquidité de la crypto, le type d’ordre stop et les conditions de marché au moment de l’exécution. Mais tant que ces hypothèses n’auront pas été vérifiées à partir du carnet d’ordres réel et des volumes exécutés, les rendements positifs des deux stratégies stop10 ne seront que théoriques.
C’est aussi pourquoi je n’ai pas ajouté de stop à la fusion cette fois-ci. Comme je l’expliquais dans le dernier article, les stratégies avec stop ne prennent en charge que la sélection d’actifs p5/p0 ; pour la fusion, il faut d’abord isoler l’interface de score. Mais surtout, si la qualité d’exécution de stop10 n’a pas encore été vérifiée, appliquer à la fusion un stop qui dépend lui aussi de l’exécution reviendrait à reproduire le même problème. Il faut d’abord résoudre la question de l’exécution, puis ajouter des fonctionnalités.
X. Nettoyage, limites et prochaine étape
Les fichiers et résultats de backtest des six stratégies ont été supprimés : 6 scripts de stratégie py, 6 backtests de la période de test, 6 backtests d’octobre et 6 résultats de backtest dans le répertoire racine, soit 24 fichiers au total. Avant leur suppression, une sauvegarde a été placée dans le répertoire temporaire `/tmp/eliminated_strategies_2026-10-22/`. Elle sera perdue au redémarrage de la machine ; la référence à long terme est `策略筛选记录.md` dans le dépôt. Les fichiers parquet de valeur liquidative quotidienne n’ont pas fait l’objet d’une sauvegarde séparée.
Pourquoi ne pas les garder ? Parce que les fichiers conservés continueraient d’exister en tant que « stratégies candidates ». En revenant deux semaines plus tard et en voyant les neuf stratégies, on pourrait facilement recommencer à optimiser une stratégie dont le drawdown excessif a déjà été démontré. La suppression est une mesure de gouvernance, pas une question de perfectionnisme.
Nettoyage effectué en parallèle : le notebook est passé de neuf à trois stratégies et son exécution a réussi ; les tableaux récapitulatifs de la période de test et de la période prospective contiennent chacun 3 lignes ; le CSV détaillé d’octobre en contient également 3 ; le rapport a été réécrit pour ne présenter que les trois stratégies ; le document de sélection indique, pour chacune des stratégies éliminées, les chiffres et les motifs de son élimination.
Il faut également préciser les limites. Les critères de sélection ont été définis a posteriori ; la période de test a déjà servi au réglage des paramètres, donc les 457 jours ne constituent pas un échantillon hors période propre ; octobre ne couvre que 21 jours ; le backtest principal est journalier et n’inclut ni les frais de financement, ni les liquidations, ni les marges, ni le glissement réel ; le stop est une approximation a posteriori à partir des données journalières. Ces limites ne disparaissent pas simplement parce que les résultats sont séduisants.
La prochaine fois, je m’occuperai de trois choses, dans l’ordre. Premièrement, vérifier la qualité d’exécution de stop10 : carnet d’ordres réel, glissement par niveau et type d’ordre stop. Il faut au minimum établir une fourchette de glissement crédible. Deuxièmement, corriger le problème des positions mortes et relancer les tests d’octobre pour voir comment les résultats changent une fois l’exposition effective complétée. Troisièmement, revenir à l’ajout d’un stop à la fusion et au walk-forward. Si la qualité d’exécution de stop10 ne passe pas l’épreuve, il faudra repenser les deux stratégies conservées du modèle : elles ne peuvent pas reposer sur un prix de stop théorique dans le backtest. Il reste également à vérifier une exclusion erronée dans la liste des actifs : GRAM a été écarté par une liste statique d’actifs non crypto, alors qu’il s’agit en réalité d’un contrat perpétuel crypto.
Cet article est un compte rendu de recherche sur des backtests, pas un signal de trading ni un conseil en investissement. Ce laboratoire quantitatif continuera à publier ses travaux, des données et facteurs à la gestion du risque. Si vous trouvez cela utile, vous pouvez l’enregistrer. À la prochaine.