


Titre original : (Après la faillite d’une entreprise, comment gagner de l’argent en vendant les données des employés)
Auteur original : Dòngchá Beating
E-mails, conversations, documents de projet, tickets : autrefois, ce ne sont que des « héritages numériques » que l’entreprise fermait puis laissait en attente pendant la phase de nettoyage. Aujourd’hui, ils commencent à être réévalués, regroupés, vendus et envoyés dans la chaîne d’approvisionnement d’entraînement des entreprises d’IA.
Embaumeur : celui qui préserve la dernière dignité du défunt. La dignité après la mort d’une entreprise, c’est la preuve que ce qu’elle a laissé derrière elle a encore de la valeur.
Le 17 août, lors d’une vente aux enchères d’actifs en faillite, Google a fait une offre de 10 millions de dollars et a racheté toutes les données d’entreprise de Spirit Airlines. Une autre société, appelée Mercor, a également enchéri : 7,5 millions. Elle a perdu de 2,5 millions.
Les lots se divisent en trois blocs. Premier bloc : environ 100 millions d’e-mails d’employés. Deuxième bloc : 500 millions de messages Microsoft Teams. Les deux ensemble totalisent 600 millions de messages. Troisième bloc : calendriers, feuilles de calcul, bases de données financières, dossiers de projet, registres opérationnels, plus un ensemble de logiciels internes. Les dossiers passagers et les informations sur les voyageurs fréquents n’en font pas partie.
600 millions de messages : si une personne disait 100 phrases par jour, il lui faudrait plus de 16 000 ans sans s’arrêter.
Au final, un message s’est vendu 1,67 centime. Aux États-Unis, on appelle une pièce d’un cent un penny, au point qu’on ne prend même plus la peine de la ramasser lorsqu’elle tombe par terre. Autrement dit, une phrase prononcée par un employé de Spirit dans Teams vaut un penny et demi.
Remontons à 1980 : Spirit Airlines est née à Detroit. À l’origine, c’était une entreprise de camions appelée Charter One, qui s’est ensuite reconvertie dans l’aviation. En 1992, elle prend le nom de Spirit, comme « esprit ». Pendant les 34 années qui ont suivi, elle a fait du modèle des compagnies aériennes à très bas coût américaines une référence imitée par tout le secteur.
L’entreprise partait pourtant sur de bonnes bases : 205 Airbus, un vol moyen d’environ 300 par jour, et un chiffre d’affaires 2024 d’environ 5 milliards de dollars. Mais la même année, elle a subi une perte nette d’environ 1,2 milliard, et lors de sa demande de faillite, elle portait environ 9 milliards de dettes.
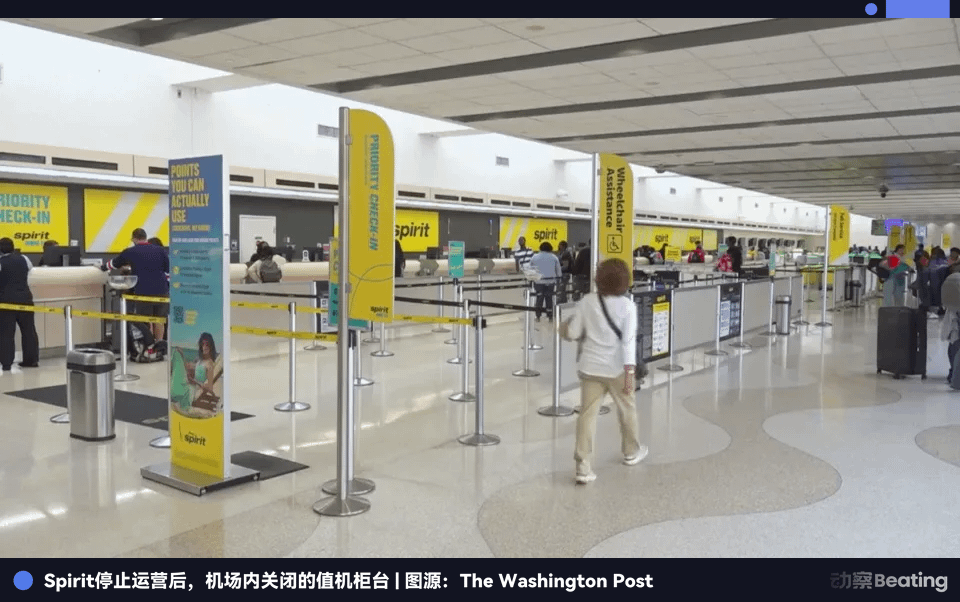
Un soir tard en mai 2026, l’entreprise a annoncé l’arrêt des vols. Le lendemain, environ 17 000 employés ont appris leur licenciement par la presse.
La procédure suit son cours, et la transaction doit attendre l’approbation du juge des faillites. Spirit suit une fermeture de type liquidation sous le Chapter 11, sans administrateur judiciaire pour reprendre l’affaire ; l’entreprise continue, sous la supervision du tribunal, à vendre un par un ses actifs restants. Les e-mails des employés, les messages Teams et autres données sensibles doivent d’abord être traités par une entité indépendante, qui supprime les noms, e-mails et autres informations permettant d’identifier une personne ; cette entité est choisie par Google, qui en assume aussi les coûts.
Par ailleurs, en passant en revue les articles publics, on ne trouve pas de précédent connu où les données internes d’une entreprise en faillite auraient été vendues à une société d’IA. Cette transaction est très probablement la première de l’histoire.
Le média technologique américain de longue date Gizmodo a titré cette transaction ainsi : Spirit est morte, mais ses données hanteront les serveurs de Google pour des générations.
Un nouveau secteur
Les gens chargés de s’occuper des entreprises mortes ont toujours existé. Avocats, liquidateurs, maisons de vente : ils font ce travail depuis des décennies. Avions, tables, marques, brevets — tout ce qui pouvait être vendu l’a déjà été.
La vraie nouveauté, c’est qu’à partir de cette année, les données internes des employés d’une entreprise ont elles aussi été mises en vente.
Si cette activité a émergé, c’est pour deux raisons.
Première chose : il y a de plus en plus d’entreprises qui meurent.
Au premier trimestre 2024, le taux d’échec des start-up américaines a augmenté de 58 % sur un an, tandis que le nombre d’acteurs actifs du capital-risque était inférieur de 62 % à son pic.
L’argent n’a pas vraiment diminué, il se concentre simplement de plus en plus sur l’IA. En 2024, les start-up américaines d’IA ont capté 97 milliards de dollars de financement, un record historique. Les marchés de capitaux ont toujours de l’argent, mais ils sont de moins en moins disposés à le dépenser en dehors de l’IA.
Le résultat, c’est qu’un groupe d’entreprises qui auraient encore pu survivre grâce au financement a commencé à heurter le mur plus tôt. En août 2024, Tally, une fintech soutenue par a16z, a annoncé sa fermeture. Elle avait levé au total 172 millions de dollars, atteint une valorisation maximale de 855 millions de dollars et était déjà arrivée en série D, sans réussir malgré tout à obtenir le tour suivant.
Deuxième chose : les données sont devenues plus chères.
L’entraînement des grands modèles consomme déjà des quantités de données absolument colossales. Les données d’entraînement de GPT-4 représentent environ 13 000 milliards de tokens. À titre de comparaison, Google Books a scanné environ 40 millions de livres en plus de quarante ans, soit l’équivalent d’environ 4 000 milliards de tokens. Autrement dit, une seule session d’entraînement de GPT-4 a utilisé un volume de données environ trois fois supérieur à celui de Google Books.
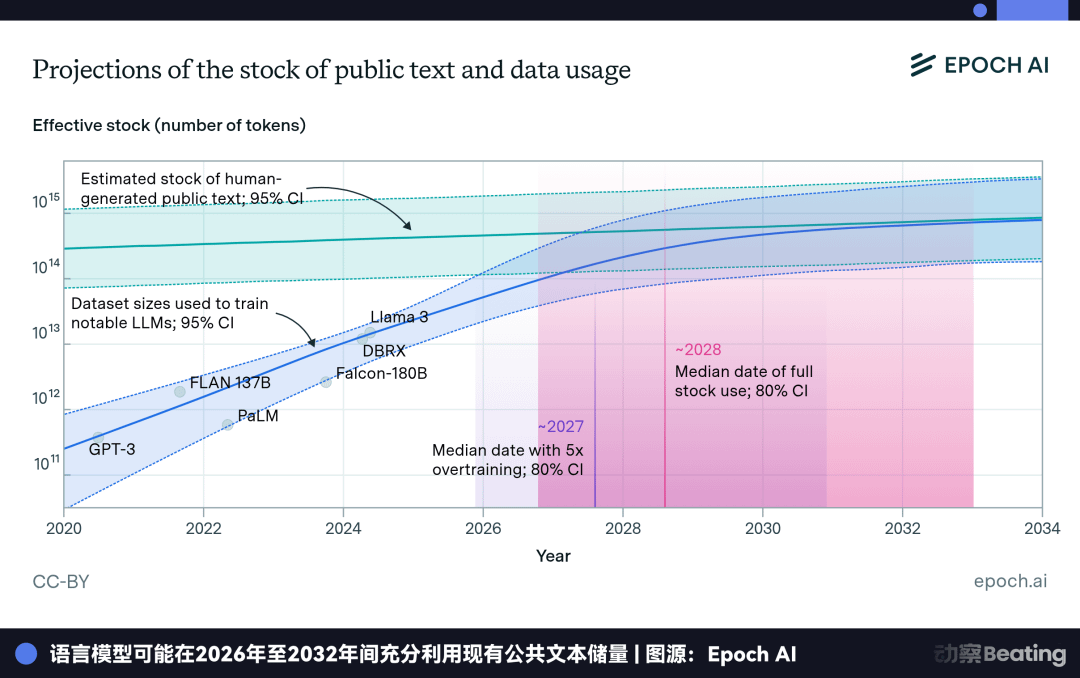
Epoch AI a fait le calcul : les données textuelles de haute qualité — livres, actualités, Wikipédia — s’épuiseront vers 2026. Le texte de haute qualité disponible sur Internet pour l’entraînement touche rapidement ses limites, et la part des données synthétiques augmente de plus en plus. Ensuite, les nouvelles données que les entreprises d’IA devront chercher iront forcément davantage en dehors de l’Internet public. Les e-mails, messages de discussion et documents de travail accumulés pendant des années dans les entreprises sont alors entrés dans le champ de vision.
Et le marché des jeux de données pour l’entraînement de l’IA devrait atteindre 9,7 milliards de dollars en 2030, selon les prévisions des instituts de recherche. En comptant les différentes licences, la taille totale du marché pourrait atteindre 67,5 milliards de dollars.
D’un côté, de plus en plus d’entreprises entrent en fermeture et en liquidation, laissant derrière elles de grandes quantités de données internes jusque-là non valorisées ; de l’autre, la demande des sociétés d’IA pour des données en dehors de l’Internet public ne cesse d’augmenter. Le fait que ces deux mouvements apparaissent simultanément a enfin donné aux données internes d’entreprise les conditions d’une transaction à grande échelle.
Ce qui rend réellement ces données plus précieuses, c’est le développement des agents d’entreprise. Gartner prévoit qu’en 2026, 40 % des applications professionnelles intégreront des agents IA orientés tâches, alors que l’année précédente ce taux était encore inférieur à 5 %.
Les matériaux d’entraînement dont un agent d’entreprise a besoin ne sont pas tout à fait les mêmes que ceux d’un grand modèle standard. Les pages web publiques peuvent fournir des connaissances, du langage et des contenus finis, mais elles restituent difficilement le processus de travail réel d’une entreprise. La communication et la coopération comportent dans la pratique de très nombreux détails concrets : comment une demande est formulée, comment plusieurs personnes en discutent, comment les tâches sont réparties, comment les problèmes sont corrigés, et comment, au final, la livraison se fait.
Ces processus sont largement conservés dans les e-mails, les conversations, les tickets et les documents de projet internes des entreprises.
Lorsque ce type de données commence à avoir des acheteurs et des usages clairement identifiés, ce qui était autrefois supprimé directement lors de la fermeture d’une société acquiert une valeur propre et peut être vendu séparément.
croque-mort
Autrefois, c’étaient les avocats en liquidation qui faisaient ce travail ; aujourd’hui, il y a trois types de personnes en plus.
La première s’appelle les prestataires de dissolution, dont SimpleClosure est l’exemple représentatif.
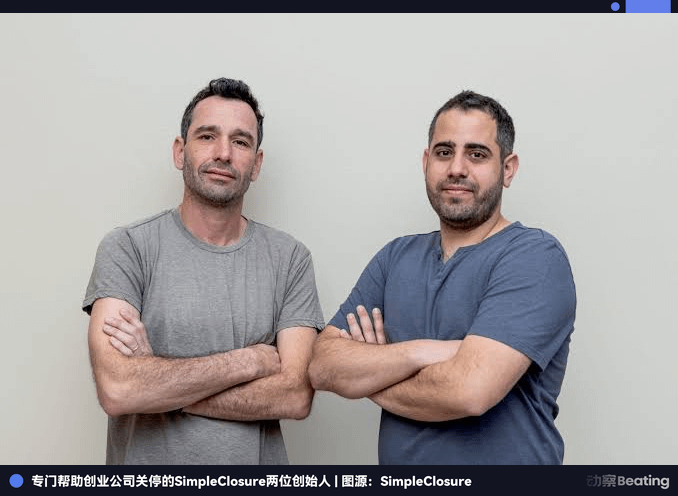
Cette société ne fait qu’une chose : aider les start-up à mourir avec dignité. Créée en 2023, elle a levé 1,5 million de dollars en pre-seed, puis 15 millions de dollars en série A en mai 2025, avec TTV Capital comme chef de file. Même Carta, qui gère les actions et les affaires de nombreuses start-up américaines, a mis fin à son propre service de fermeture pour investir dans SimpleClosure et lui confier cette partie de la clientèle.
En octobre 2025, SimpleClosure avait déjà organisé les funérailles de plus d’un millier d’entreprises. Crunchbase lui a donné un nom : « A Better Way To Fail », une meilleure façon d’échouer. Les entrepreneurs américains aiment dire « fail fast », échouer vite. SimpleClosure dit que ce n’est pas assez, il faut aussi que ce soit digne. Le site affiche même un calculateur de prix : on saisit les informations de l’entreprise et l’on obtient le coût pour mourir une fois.
Les funérailles ne sont pas gratuites. En avril 2026, SimpleClosure a lancé Asset Hub, dédié au traitement des actifs immatériels laissés par les entreprises fermées. Au-delà des marques, logiciels et listes clients, on trouvait pour la première fois sur l’étalage des données de travail internes telles que les historiques Slack, les e-mails et les tickets Jira.
Cela montre qu’avant Spirit, le marché avait déjà commencé à essayer de fixer un prix aux données internes des entreprises mortes, mais il s’agissait encore de start-up, de petites transactions et d’arrangements privés.
Il existe un cas déjà observé. Lorsque la société de transcription et de sous-titrage cielo24 a fermé, elle a vendu via SimpleClosure les messages Slack, e-mails internes et tickets Jira accumulés sur 13 ans. Sa CEO, Shanna Johnson, a ensuite déclaré à Forbes que ces données s’étaient finalement vendues pour des centaines de milliers de dollars.
Pour une entreprise déjà décidée à fermer, il s’agissait à l’origine d’un lot de données à nettoyer ; au final, c’est devenu un actif récupérable lors de la liquidation.
La partie vente des données a été confiée par SimpleClosure à Protege. Il s’agit d’une place de marché de données spécialisée dans les licences de données d’entraînement pour l’IA ; en janvier 2026, elle a levé 30 millions de dollars menés par a16z. Son fondateur s’appelle Bobby Samuels. Protege a d’abord commencé par l’imagerie médicale, et a réussi en trente jours à fournir à l’acheteur plusieurs millions d’images pour le pré-entraînement.
Désormais, Protege commence à appliquer cette capacité de licence et de transaction de données aux communications internes d’entreprises en cessation d’activité. SimpleClosure gère la fermeture de l’entreprise et le tri des actifs, tandis que Protege se charge de trouver des acheteurs, d’obtenir les licences de données et de finaliser les transactions.
La deuxième catégorie d’acteurs, ce sont les tribunaux des faillites et les avocats en liquidation. Pendant des décennies, ils ont inventorié des avions, des tables, des marques et des brevets. Désormais, la liste commence à inclure des e-mails, des historiques Slack et d’autres données internes.
Selon le droit américain des faillites, ces données peuvent être intégrées à la masse de la faillite en tant qu’actifs immatériels et vendues sous le contrôle du tribunal. Certains cabinets ont aussi commencé à créer des équipes spécialisées pour gérer, dans les dossiers de faillite, la conservation, l’investigation et la préparation des données. Redgrave LLP a justement une activité de restructuration et d’investigation de ce type.
La troisième catégorie regroupe les prestataires d’e-discovery chargés de l’exécution technique. Des sociétés comme KLDiscovery, Epiq ou Consilio travaillent déjà au quotidien sur la collecte, l’organisation, l’hébergement et la revue de données d’entreprise. Les contenus des e-mails, Teams et SharePoint doivent d’abord être exportés et archivés par eux, puis organisés en un lot de données pouvant entrer dans le processus de transaction.
Le secteur dispose déjà d’un mode de tarification assez mûr. L’EDRM publie régulièrement des enquêtes de prix, et les unités de facturation courantes incluent la collecte de données par Go, l’hébergement par Go et par mois, ainsi que les frais de revue documentaire.
Les 600 millions de messages de Spirit sont devenus un lot à vendre grâce à ce type de travail de base. Mais, comparé aux dossiers judiciaires et aux offres d’enchères, cette partie apparaît rarement dans les reportages publics ; on ne voit généralement pas qui la traite ni comment.
inventaire post-mortem
Pour un agent d’entreprise, il doit apprendre non seulement des connaissances et des réponses standards, mais aussi le jugement, la coopération, la correction d’erreurs et l’exécution dans un environnement de travail réel.
Le produit fini dit au modèle ce qui a finalement été réalisé ; les archives internes lui disent comment cela a été réalisé.
Ce changement se reflète déjà dans les données d’entraînement des agents. Autrefois, un échantillon d’entraînement pour le code ne contenait peut-être que quelques centaines de tokens, avec la modification de quelques lignes ; aujourd’hui, un échantillon d’entraînement pour un agent doit souvent inclure tout le processus : compréhension de la demande, localisation des fichiers, modification du code et vérification par les tests.
L’entraînement des données évolue d’une simple réponse vers l’enregistrement complet de l’exécution d’une tâche. Pour un agent, le résultat final compte bien sûr, mais ce qui a le plus de valeur pour l’apprentissage, ce sont les jugements, actions et retours laissés pendant la réalisation.
Par rapport à une entreprise en activité normale, les données d’une société en fermeture entrent plus facilement dans un processus de transaction. Tant que l’entreprise fonctionne encore, vendre les communications internes implique des secrets commerciaux, la vie privée des employés, des risques de concurrence et les relations clients ; les services juridiques et la direction restent généralement très prudents. Une fois la liquidation engagée, l’objectif principal de l’entreprise devient de récupérer autant que possible les actifs restants afin d’obtenir davantage de valeur pour les créanciers.
C’est aussi pourquoi le même lot de données internes, difficile à vendre tant que l’entreprise est en activité, peut être réévalué comme un actif au moment de la fermeture.
La valeur des données internes d’entreprise est en réalité comprise depuis longtemps par le secteur. Salesforce a toujours considéré les communications d’entreprise accumulées dans Slack comme un actif de données important, et le CEO de Microsoft, Satya Nadella, a également souligné à plusieurs reprises que, dans l’usage de l’IA en entreprise, la partie la plus précieuse réside précisément dans les données propriétaires et le contexte de travail de l’entreprise.
Jusqu’ici, ces données servaient surtout à l’entreprise elle-même. Désormais, à mesure que les sociétés d’IA cherchent activement des données internes d’entreprise, elles ont pour la première fois un acheteur externe plus clairement identifié.
L’art de la tarification
Bien que ce secteur soit encore tout récent, le marché a déjà vu apparaître quelques prix de référence.
Les données de start-up fermées traitées par SimpleClosure et Protege se négocient généralement entre 10 000 et 100 000 dollars par transaction. Les offres de Mercor pour les conversations et e-mails d’employés de start-up acquises peuvent, elles, atteindre 300 000 dollars.
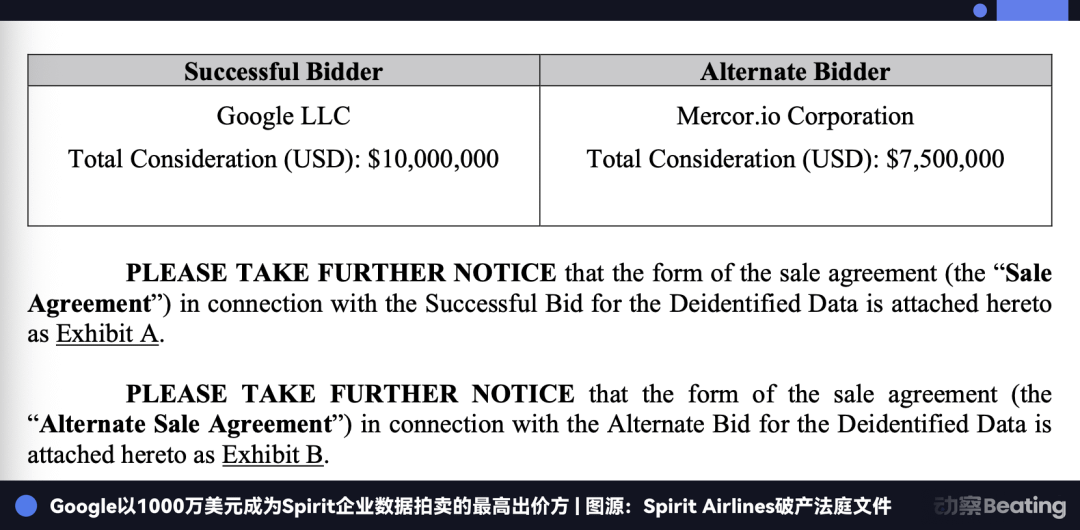
Spirit a fait grimper les prix d’un coup au niveau des dizaines de millions de dollars. Mercor a offert 7,5 millions de dollars, Google est finalement monté à 10 millions, pour obtenir environ 600 millions de communications internes et autres données d’entreprise. Si l’on ne compte que ces 600 millions de messages, cela revient à environ 1,67 centime par message.
Le prix unitaire n’est pas élevé. Reuters rapportait en 2024 que Photobucket, avec environ 13 milliards de photos et vidéos, discutait de licences avec des sociétés d’IA ; le prix des photos était d’environ 5 centimes à 1 dollar chacune, tandis que les vidéos dépassaient souvent 1 dollar l’unité. Sur le marché B2B des données, une information de contact peut aussi se vendre de quelques centimes à quelques dollars selon son niveau de complétude et de précision.
Mais ces prix ne suffisent pas encore à former une norme unifiée. La valeur des données internes d’une entreprise fermée se négocie encore au cas par cas. Le volume de données, le secteur, la période couverte, l’exhaustivité, l’unicité, ainsi que l’usage prévu par l’acheteur influencent tous le prix final. Les 10 millions de dollars de Spirit ressemblent davantage à l’un des rares grands exemples publics disponibles à ce jour.
La différence est encore plus nette si on compare avec des marchés de licences de données déjà mûrs. Reddit a concédé à Google l’usage de ses publications et commentaires, pour un contrat d’environ 60 millions de dollars par an ; l’accord de licence de contenu entre News Corp et OpenAI est d’environ 250 millions de dollars sur cinq ans ; la coopération entre xAI et Telegram atteint 300 millions de dollars ; tandis que l’achat par Apple de licences d’images Shutterstock se situe entre 25 et 50 millions de dollars.
Ces marchés disposent déjà d’acheteurs stables, de modalités de licence et d’une expérience en matière de tarification. Les transactions de données internes d’entreprises en fermeture n’en sont qu’à leurs débuts ; quelles données valent le plus, et s’il faut les valoriser à l’unité, au volume ou par lot complet, il n’existe pour l’instant aucune règle claire.
Les 10 millions de dollars de Spirit, rapportés à la taille de l’entreprise elle-même, racontent encore autre chose. En 2024, le chiffre d’affaires annuel de Spirit a approché les 5 milliards de dollars, soit en moyenne environ 13,7 millions de dollars par jour. L’argent payé par Google pour ces données représentait moins d’une journée de revenus de l’exploitation normale.
Pour une liquidation, il ne s’agit que d’un élément parmi les actifs restants à récupérer ; pour une entreprise d’IA, en revanche, ce qu’elle achète est un ensemble de données longtemps non publiées, contenant le fonctionnement réel d’une entreprise.
Nettoyage et transfert
Une fois la transaction conclue, les données ne peuvent pas être remises directement à l’acheteur. Avant le transfert officiel, elles passent généralement par plusieurs étapes : extraction, dé-identification, préparation, approbation du tribunal et livraison finale.
La première étape est l’exportation. Les données d’entreprise de Slack sont généralement exportées sous forme de fichier ZIP, comprenant des fichiers JSON classés par canal, les informations des membres et les pièces jointes.
Microsoft 365 permet, lui, d’exporter les e-mails et les messages Teams via des outils d’investigation. Spirit concernait environ 600 millions de communications internes, un volume énorme qui, en pratique, doit être traité par lots. Le dossier public ne précise pas si l’exécution a été confiée à un prestataire d’e-discovery ou à l’équipe technique de l’acheteur.
Ensuite vient la dé-identification, c’est-à-dire supprimer autant que possible les informations permettant d’identifier un employé précis. Les méthodes courantes consistent à repérer et masquer les noms, numéros de téléphone, adresses et autres données personnelles, ou à remplacer les champs sensibles par des identifiants qui ne renvoient pas directement à une personne. Dans certains scénarios statistiques et d’entraînement, on ajoute aussi des perturbations aléatoires pour réduire encore la probabilité de réidentification.
Mais la dé-identification ne signifie pas anonymat absolu. Même si les noms et les e-mails ont été supprimés, dès lors que le texte conserve suffisamment de caractéristiques professionnelles, temporelles, géographiques ou comportementales, il reste possible de réidentifier une personne à partir d’autres informations.
Dans la transaction de Spirit, il est donc important de savoir qui prend cette étape en charge. Selon le dispositif actuel, les données seront dé-identifiées par un tiers indépendant, mais cette entité a été choisie par Google et ses coûts sont aussi pris en charge par Google. Google s’engage également à ne pas utiliser ces données pour réidentifier qui que ce soit.
La vente de données par des entreprises en faillite n’a rien de totalement nouveau. Au cours des vingt dernières années, des cas comme Toysmart, Borders, RadioShack ou 23andMe ont déjà vu des données clients être traitées ou vendues dans le cadre d’une faillite. Ce type de transaction touche à la vie privée des consommateurs et fait généralement l’objet d’un contrôle plus strict de la part des tribunaux, des régulateurs et des États.
La différence avec Spirit, c’est qu’ici l’objet principal de la vente n’était pas la liste des passagers, mais les e-mails des employés, les messages Teams et autres données de travail internes. Les procédures de faillite existantes n’ont pas encore établi de règles mûres pour le traitement de ce type de données, contrairement aux informations des consommateurs.
Des controverses sont aussi apparues. Le syndicat des hôtesses et stewards de Spirit a contesté la transaction, ce qui a poussé le tribunal à en retarder l’approbation. Des données d’entreprise initialement vendues comme actifs de faillite ont commencé à soulever des questions de droits des employés et de limites de l’usage de l’IA.
Si la transaction obtient finalement l’approbation, les données entreront alors dans la phase finale de livraison. Mais entre le jeu de données préparé et les systèmes de Google, les documents publics en disent très peu. La manière dont les données seront transférées, si elles seront encore nettoyées, et sous quelle forme exacte elles entreront dans le développement produit ou l’entraînement des modèles restent inconnus pour l’instant.
Ce n’est qu’à ce stade de la procédure que les données achèvent réellement leur passage d’actif de faillite à actif d’IA.
Acheteurs
Les acheteurs les plus clairement identifiés pour ce type de données sont aujourd’hui des sociétés de modèles comme Google, ainsi que des fournisseurs de données d’entraînement comme Mercor.
La version officielle de Google concernant cette transaction avec Spirit est qu’elle servira à l’amélioration des produits et au développement de l’IA. Pour Google, la valeur de ce jeu de données réside dans le fait qu’il documente le fonctionnement réel d’une grande entreprise, par exemple la planification des équipes, la collaboration, les communications internes, l’avancement des projets, le traitement des problèmes et les décisions de management.
Ces contenus sont difficiles à obtenir à partir des pages web publiques. Pour un agent d’entreprise en particulier, au-delà du résultat final, l’essentiel est de savoir comment une tâche est réellement menée et achevée dans une organisation réelle. Les archives internes laissées par Spirit contiennent justement une grande quantité de ce type de données de գործընթաց.
L’autre enchérisseur, Mercor, montre encore mieux dans quelle direction cette activité évolue.
Mercor a été fondée en 2023, et ses trois fondateurs, Brendan Foody, Adarsh Hiremath et Surya Midha, étaient camarades d’équipe de débat depuis le lycée. L’entreprise s’est d’abord consacrée au recrutement par IA, en aidant les sociétés à trier et interviewer des candidats à l’aide de modèles. En septembre 2024, Mercor avait déjà évalué environ 300 000 candidats, pour une valorisation de 250 millions de dollars.
Par la suite, l’entreprise s’est progressivement recentrée sur les données d’entraînement pour l’IA. En novembre 2025, les trois fondateurs n’avaient que 22 ans, et avec la hausse de la valorisation, ils sont devenus à l’époque l’un des plus jeunes groupes de milliardaires autodidactes du monde. Au premier semestre 2026, le chiffre d’affaires de Mercor a dépassé 614 millions de dollars, dont environ 90 % provenaient de laboratoires d’IA de premier plan comme OpenAI. En juillet, l’entreprise cherchait une valorisation d’environ 20 milliards de dollars et a racheté Deeptune, spécialisée dans la construction d’environnements d’entraînement pour les agents d’IA.
Mercor obtient principalement ses données d’entraînement par deux voies.
L’une consiste à acheter directement des archives internes d’entreprise. Elle a déjà proposé d’acheter des conversations d’employés et des e-mails à des start-up rachetées ou fermées, avec une offre pouvant aller jusqu’à environ 300 000 dollars par société.
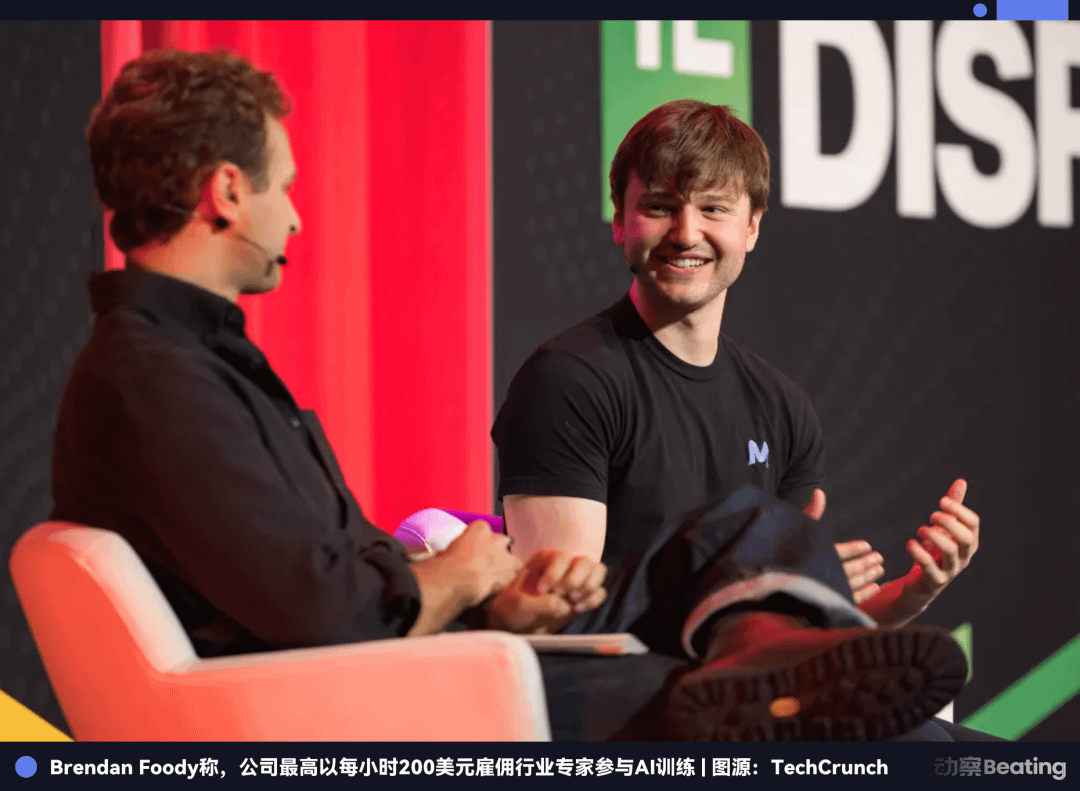
L’autre consiste à embaucher des personnes ayant une expérience professionnelle concrète. TechCrunch a rapporté en octobre 2025 que des laboratoires d’IA recrutent, via Mercor, d’anciens employés d’entreprises pour qu’ils transforment leur expérience de travail en tâches d’entraînement et en retours, pour un taux horaire d’environ 200 dollars. Le CEO de Mercor a déjà déclaré que l’entreprise versait chaque jour plus de 1,5 million de dollars de rémunération aux personnes participant à l’entraînement de l’IA.
D’un côté, on achète les traces de travail laissées par l’entreprise ; de l’autre, on achète l’expérience professionnelle détenue par ses employés. Les actifs essentiels de Mercor sont, au fond, les processus de travail du monde réel.
Cela explique aussi pourquoi elle s’est retrouvée dans les enchères de Spirit. Pour Mercor, 600 millions de communications internes représentent une source de données d’entraînement d’une autre ampleur, bien plus grande.
Ce type d’activité comporte aussi des risques. En 2025, Scale AI a poursuivi Mercor, l’accusant d’un ancien employé ayant emporté des secrets commerciaux ; depuis, l’entreprise a aussi connu des fuites d’informations liées à l’entraînement et des suspensions de partenariats. Les données sont à la fois le métier de Mercor et l’actif qu’elle doit le plus défendre.
Il y a enfin un contraste numérique. Spirit a exploité cette marque pendant 34 ans, alors que les trois fondateurs de Mercor, qui participaient aux enchères sur ses données internes, n’avaient tous que 22 ans à l’époque.
banc brisé
La transaction de Spirit n’est pas encore finalisée, le tribunal n’a pas encore signé, et Google n’a pas encore reçu ces données. Il reste les objections syndicales, les audiences et encore beaucoup de procédures à suivre.
Mais cette enchère a rendu concret quelque chose dont on parlait rarement auparavant.
Avant, lorsqu’une entreprise fermait, beaucoup de choses disparaissaient vraiment. Les états financiers restaient, les marques restaient, les brevets restaient. Mais l’expérience quotidienne d’une entreprise ne restait généralement pas. Comment un service tenait ses réunions, comment un manager prenait ses décisions, comment des dizaines de personnes se coordonnaient après un retard, pourquoi un processus finissait par être modifié pour devenir celui d’aujourd’hui : tout cela était rarement consigné officiellement.
L’entreprise est dissoute, les employés partent, les boîtes mail sont désactivées, les groupes de discussion fermés, et tout cela disparaît avec eux.
C’est pourquoi l’entreprise a toujours été une organisation assez étrange.
Elle peut vivre pendant des décennies et accumuler l’expérience de milliers de personnes, mais ce qui peut réellement se transmettre n’en est souvent qu’une très mince partie. La société suivante doit encore recruter, recommettre les mêmes erreurs et tout réapprendre à nouveau.
L’IA est peut-être en train de changer cela. Si les e-mails, réunions, tickets, modifications de code et discussions internes peuvent réellement être organisés en données d’entraînement, alors l’expérience qu’une entreprise ne pouvait auparavant transmettre qu’avec des personnes devient, pour la première fois, susceptible d’être conservée autrement.
On ne sait pas encore où tout cela mènera. Peut-être que, demain, les entreprises conserveront ces données de leur propre initiative ; peut-être que les contrats des employés seront réécrits ; peut-être que le droit des faillites imposera de nouvelles restrictions ; peut-être qu’au moment des levées de fonds et des fusions-acquisitions, même les traces de travail internes seront valorisées séparément.
Spirit a mis ce problème sur la table à l’avance.
Le mot « faillite » a une étymologie souvent citée. Au Moyen Âge, les marchands italiens faisaient affaire assis derrière un banc. Quand ils étaient insolvables, on brisait publiquement ce banc. Banca rotta, le banc cassé.
Pendant des siècles, quand le banc était brisé, l’affaire était terminée.
La chaise de Spirit est déjà brisée. Les 600 millions de messages qu’elle a laissés derrière elle sont en train d’être revalorisés.
Un penny et demi par message.
Lien original