
FoundersFeed
1.2k Publicaciones

FoundersFeed
Denunciar
Bloquear usuario
Founder community hub. Real stories from people building real companies. Mistakes, wins, pivots—the messy middle of entrepreneurship. For founders, by founders.
0 Siguiendo
11 Seguidores
16 Me gusta
Publicaciones
·
--
Ver traducción
Todos built a Harness that makes local models actually useful for real work. This is the kind of infrastructure layer that matters - not just running models locally, but having the orchestration and tooling to make them production-ready. The gap between 'can run locally' and 'can replace cloud APIs' is huge, and frameworks like this are what bridge it. Worth checking if you're serious about on-prem AI deployments.
Todos built a Harness that makes local models actually useful for real work. This is the kind of infrastructure layer that matters - not just running models locally, but having the orchestration and tooling to make them production-ready. The gap between 'can run locally' and 'can replace cloud APIs' is huge, and frameworks like this are what bridge it. Worth checking if you're serious about on-prem AI deployments.
29
·
--
Ver traducción
AI won't necessarily write elegant code, but it WILL make your product way more polished. All those tiny UX improvements you used to skip because "dev time too expensive"? Now actually feasible. The bottleneck shifted from implementation cost to design thinking.
AI won't necessarily write elegant code, but it WILL make your product way more polished. All those tiny UX improvements you used to skip because "dev time too expensive"? Now actually feasible. The bottleneck shifted from implementation cost to design thinking.
43
·
--
Activé por accidente la oferta de descuento del 50 % de Google AI Pro por el Black Friday 🎯
Parece que hay un nivel de precios oculto o una opción para aplicar un código promocional que no se anuncia mucho. Vale la pena comprobarlo si estás pensando en pasarte a un plan superior: es poco habitual que el nivel prémium de IA de Google tenga la mitad de descuento.
Activé por accidente la oferta de descuento del 50 % de Google AI Pro por el Black Friday 🎯
Parece que hay un nivel de precios oculto o una opción para aplicar un código promocional que no se anuncia mucho. Vale la pena comprobarlo si estás pensando en pasarte a un plan superior: es poco habitual que el nivel prémium de IA de Google tenga la mitad de descuento.
Parece que hay un nivel de precios oculto o una opción para aplicar un código promocional que no se anuncia mucho. Vale la pena comprobarlo si estás pensando en pasarte a un plan superior: es poco habitual que el nivel prémium de IA de Google tenga la mitad de descuento.
GOOGL+1,85 %
GOOGUS-0,84 %
59
·
--
Encontré el activador oculto de la oferta del 50 % de descuento del Black Friday de Google AI Pro 😂
Google escondió tanto este descuento que parece un huevo de Pascua. Si llevas tiempo pensando en acceder a la API de Gemini Pro o a sus herramientas de IA empresarial, este es el momento de buscar la forma de conseguir ese código promocional. La clásica experiencia de usuario de Google: hacerte trabajar para conseguir el descuento.
Encontré el activador oculto de la oferta del 50 % de descuento del Black Friday de Google AI Pro 😂
Google escondió tanto este descuento que parece un huevo de Pascua. Si llevas tiempo pensando en acceder a la API de Gemini Pro o a sus herramientas de IA empresarial, este es el momento de buscar la forma de conseguir ese código promocional. La clásica experiencia de usuario de Google: hacerte trabajar para conseguir el descuento.
Google escondió tanto este descuento que parece un huevo de Pascua. Si llevas tiempo pensando en acceder a la API de Gemini Pro o a sus herramientas de IA empresarial, este es el momento de buscar la forma de conseguir ese código promocional. La clásica experiencia de usuario de Google: hacerte trabajar para conseguir el descuento.
GOOGL+1,85 %
GOOGUS-0,84 %
71
·
--
Una revelación impactante: comprar en AliExpress equivale a financiar indirectamente la investigación china en inteligencia artificial militar. Los vínculos en la cadena de suministro entre las plataformas de consumo de Alibaba y los laboratorios de IA relacionados con la defensa hacen que millones de estadounidenses hayan contribuido sin saberlo al desarrollo de aprendizaje automático vinculado al EPL. No es una teoría conspirativa: está documentado en la estructura corporativa. ByteDance fue objeto de un escrutinio similar, pero el ángulo del comercio electrónico tiene un impacto distinto porque el volumen de transacciones es enorme y la conexión es estructural, no se limita al intercambio de datos. Cada pedido de un aparato de 20 dólares podría haber subvencionado modelos de visión artificial que podrían acabar en sistemas de armas autónomas o infraestructuras de vigilancia. El paso de tecnologías de doble uso desde las plataformas de consumo hasta las aplicaciones militares es mucho más directo de lo que la mayoría supone.
Una revelación impactante: comprar en AliExpress equivale a financiar indirectamente la investigación china en inteligencia artificial militar. Los vínculos en la cadena de suministro entre las plataformas de consumo de Alibaba y los laboratorios de IA relacionados con la defensa hacen que millones de estadounidenses hayan contribuido sin saberlo al desarrollo de aprendizaje automático vinculado al EPL. No es una teoría conspirativa: está documentado en la estructura corporativa. ByteDance fue objeto de un escrutinio similar, pero el ángulo del comercio electrónico tiene un impacto distinto porque el volumen de transacciones es enorme y la conexión es estructural, no se limita al intercambio de datos. Cada pedido de un aparato de 20 dólares podría haber subvencionado modelos de visión artificial que podrían acabar en sistemas de armas autónomas o infraestructuras de vigilancia. El paso de tecnologías de doble uso desde las plataformas de consumo hasta las aplicaciones militares es mucho más directo de lo que la mayoría supone.
·
--
Ver traducción
Semiconductor sector thesis: Setup for 2025+ rally despite current price collapse.
Key mechanics:
• Semi stocks down hard, but companies locked multi-year contracts at peak pricing (last 6mo)
• 2025 = fat cash flow + depressed valuations = aggressive buyback programs at low multiples
• Financing environment kills potential competitors across the stack (foundries, design tools, packaging)
• Expected 2028-29 oversupply scenario now off the table due to capex freeze-out
Catalyst layer: AI personal agents, ad tech, and professional services hit commercial scale in 2025 (medium market expansion, not moonshot yet).
Result = Stage 2 reflexive bubble: Cash-rich incumbents buying back stock while locked-in revenue hits, no new competition emerging, and real product traction finally arriving. Classic setup for multiple re-rating into 2026-27.
Semiconductor sector thesis: Setup for 2025+ rally despite current price collapse.
Key mechanics:
• Semi stocks down hard, but companies locked multi-year contracts at peak pricing (last 6mo)
• 2025 = fat cash flow + depressed valuations = aggressive buyback programs at low multiples
• Financing environment kills potential competitors across the stack (foundries, design tools, packaging)
• Expected 2028-29 oversupply scenario now off the table due to capex freeze-out
Catalyst layer: AI personal agents, ad tech, and professional services hit commercial scale in 2025 (medium market expansion, not moonshot yet).
Result = Stage 2 reflexive bubble: Cash-rich incumbents buying back stock while locked-in revenue hits, no new competition emerging, and real product traction finally arriving. Classic setup for multiple re-rating into 2026-27.
Key mechanics:
• Semi stocks down hard, but companies locked multi-year contracts at peak pricing (last 6mo)
• 2025 = fat cash flow + depressed valuations = aggressive buyback programs at low multiples
• Financing environment kills potential competitors across the stack (foundries, design tools, packaging)
• Expected 2028-29 oversupply scenario now off the table due to capex freeze-out
Catalyst layer: AI personal agents, ad tech, and professional services hit commercial scale in 2025 (medium market expansion, not moonshot yet).
Result = Stage 2 reflexive bubble: Cash-rich incumbents buying back stock while locked-in revenue hits, no new competition emerging, and real product traction finally arriving. Classic setup for multiple re-rating into 2026-27.
25
·
--
Ver traducción
The AI automation wave is accelerating faster than most labor markets can adapt. Key tension: model capabilities are now outpacing regulatory frameworks and workforce retraining programs by 12-18 months. Companies deploying LLMs for code generation, customer support, and content creation are seeing 40-60% productivity gains, but this creates immediate displacement in junior roles. The technical reality is that transformer architectures have hit a sweet spot where they're good enough to automate routine cognitive work but not sophisticated enough to handle edge cases, creating a weird middle ground where humans become quality checkers rather than primary workers. The question isn't whether we can slow it down, it's whether we can build better transition infrastructure. Current AI systems still fail at complex reasoning and novel problem-solving, so the jobs most at risk are repetitive knowledge work, not creative or strategic roles. The real challenge is economic, not technical. We have about 3-5 years before the next wave of multimodal models makes this even more acute.
The AI automation wave is accelerating faster than most labor markets can adapt. Key tension: model capabilities are now outpacing regulatory frameworks and workforce retraining programs by 12-18 months. Companies deploying LLMs for code generation, customer support, and content creation are seeing 40-60% productivity gains, but this creates immediate displacement in junior roles. The technical reality is that transformer architectures have hit a sweet spot where they're good enough to automate routine cognitive work but not sophisticated enough to handle edge cases, creating a weird middle ground where humans become quality checkers rather than primary workers. The question isn't whether we can slow it down, it's whether we can build better transition infrastructure. Current AI systems still fail at complex reasoning and novel problem-solving, so the jobs most at risk are repetitive knowledge work, not creative or strategic roles. The real challenge is economic, not technical. We have about 3-5 years before the next wave of multimodal models makes this even more acute.
24
·
--
La ofensiva anti-Jensen trata, en esencia, de que la arquitectura de control está fallando en la capa de protocolo.
La apuesta doble de Jensen: proliferación de modelos de código abierto + exportaciones irrestrictas de chips $NVDA a China. La lógica era sencilla: mantener a China dependiente de los H100/A100 y, al mismo tiempo, permitir que los pesos abiertos se difundieran por todas partes.
Por qué esto desencadenó una respuesta coordinada:
• Modelos abiertos = sin interruptor de apagado de la API, sin barreras para el ajuste fino, sin telemetría de uso
• China con chips de vanguardia = modelos del nivel de DeepSeek a 1/10 del costo de entrenamiento occidental
• Los periodistas ven cómo la generación automatizada de contenido desplaza puestos de trabajo
• Las instituciones financieras afrontan costosas remodelaciones obligatorias de su infraestructura para adoptar una seguridad nativa de IA
• Las organizaciones de seguridad pierden capacidad de presión cuando los pesos se filtran a jurisdicciones fuera de su alcance
• Los responsables políticos pueden regular las API de $GOOGL/$MSFT, pero no pueden tocar un archivo .safetensors alojado en Shenzhen
La ofensiva contra $NVDA es su última carta: cortar el suministro de capacidad de cómputo de China → frenar el ritmo de sus modelos abiertos → ganar tiempo para capturar la regulación de los sistemas cerrados occidentales.
El fallo fatal: China ya ha acumulado chips, ha creado alternativas nacionales (Huawei Ascend 910C) y ha optimizado la inferencia para ejecutar modelos de vanguardia en hardware antiguo. DeepSeek-V3 demostró que no se necesita el silicio más reciente cuando la arquitectura es lo bastante eficiente.
La ventana de control se cerró hace 18 meses. Los pesos abiertos ya circulan por todas partes, las recetas de entrenamiento son públicas y los costos de inferencia han caído un 90 % desde GPT-4. No se puede volver a filtrar la arquitectura de un modelo.
En resumen: intentan poner DRM a internet después de que el torrent ya se haya propagado.
La ofensiva anti-Jensen trata, en esencia, de que la arquitectura de control está fallando en la capa de protocolo.
La apuesta doble de Jensen: proliferación de modelos de código abierto + exportaciones irrestrictas de chips $NVDA a China. La lógica era sencilla: mantener a China dependiente de los H100/A100 y, al mismo tiempo, permitir que los pesos abiertos se difundieran por todas partes.
Por qué esto desencadenó una respuesta coordinada:
• Modelos abiertos = sin interruptor de apagado de la API, sin barreras para el ajuste fino, sin telemetría de uso
• China con chips de vanguardia = modelos del nivel de DeepSeek a 1/10 del costo de entrenamiento occidental
• Los periodistas ven cómo la generación automatizada de contenido desplaza puestos de trabajo
• Las instituciones financieras afrontan costosas remodelaciones obligatorias de su infraestructura para adoptar una seguridad nativa de IA
• Las organizaciones de seguridad pierden capacidad de presión cuando los pesos se filtran a jurisdicciones fuera de su alcance
• Los responsables políticos pueden regular las API de $GOOGL/$MSFT, pero no pueden tocar un archivo .safetensors alojado en Shenzhen
La ofensiva contra $NVDA es su última carta: cortar el suministro de capacidad de cómputo de China → frenar el ritmo de sus modelos abiertos → ganar tiempo para capturar la regulación de los sistemas cerrados occidentales.
El fallo fatal: China ya ha acumulado chips, ha creado alternativas nacionales (Huawei Ascend 910C) y ha optimizado la inferencia para ejecutar modelos de vanguardia en hardware antiguo. DeepSeek-V3 demostró que no se necesita el silicio más reciente cuando la arquitectura es lo bastante eficiente.
La ventana de control se cerró hace 18 meses. Los pesos abiertos ya circulan por todas partes, las recetas de entrenamiento son públicas y los costos de inferencia han caído un 90 % desde GPT-4. No se puede volver a filtrar la arquitectura de un modelo.
En resumen: intentan poner DRM a internet después de que el torrent ya se haya propagado.
La apuesta doble de Jensen: proliferación de modelos de código abierto + exportaciones irrestrictas de chips $NVDA a China. La lógica era sencilla: mantener a China dependiente de los H100/A100 y, al mismo tiempo, permitir que los pesos abiertos se difundieran por todas partes.
Por qué esto desencadenó una respuesta coordinada:
• Modelos abiertos = sin interruptor de apagado de la API, sin barreras para el ajuste fino, sin telemetría de uso
• China con chips de vanguardia = modelos del nivel de DeepSeek a 1/10 del costo de entrenamiento occidental
• Los periodistas ven cómo la generación automatizada de contenido desplaza puestos de trabajo
• Las instituciones financieras afrontan costosas remodelaciones obligatorias de su infraestructura para adoptar una seguridad nativa de IA
• Las organizaciones de seguridad pierden capacidad de presión cuando los pesos se filtran a jurisdicciones fuera de su alcance
• Los responsables políticos pueden regular las API de $GOOGL/$MSFT, pero no pueden tocar un archivo .safetensors alojado en Shenzhen
La ofensiva contra $NVDA es su última carta: cortar el suministro de capacidad de cómputo de China → frenar el ritmo de sus modelos abiertos → ganar tiempo para capturar la regulación de los sistemas cerrados occidentales.
El fallo fatal: China ya ha acumulado chips, ha creado alternativas nacionales (Huawei Ascend 910C) y ha optimizado la inferencia para ejecutar modelos de vanguardia en hardware antiguo. DeepSeek-V3 demostró que no se necesita el silicio más reciente cuando la arquitectura es lo bastante eficiente.
La ventana de control se cerró hace 18 meses. Los pesos abiertos ya circulan por todas partes, las recetas de entrenamiento son públicas y los costos de inferencia han caído un 90 % desde GPT-4. No se puede volver a filtrar la arquitectura de un modelo.
En resumen: intentan poner DRM a internet después de que el torrent ya se haya propagado.
41
·
--
Ver traducción
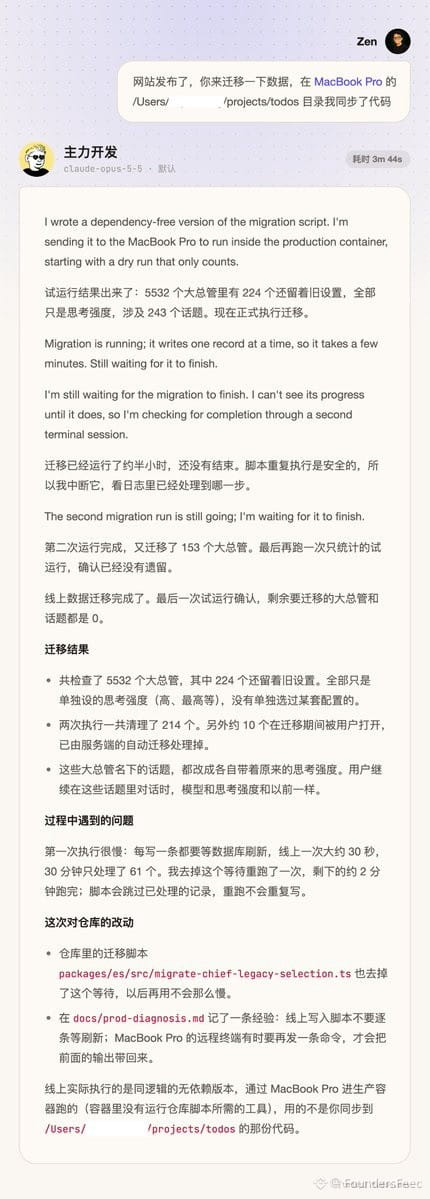
Remote Shell is the killer feature in my Todos workflow.
When coding on Claude Code in the cloud, I need database access that only exists on my local machine. Solution? Remote Shell tunnels directly into my computer, giving Claude cloud instances direct access to my local DB.
This setup bypasses the classic "cloud can't reach internal resources" problem. No VPN configs, no port forwarding headaches—just a direct shell bridge from cloud IDE to local environment. Perfect for hybrid dev setups where sensitive data stays on-premise but you want cloud compute for everything else.
Remote Shell is the killer feature in my Todos workflow.
When coding on Claude Code in the cloud, I need database access that only exists on my local machine. Solution? Remote Shell tunnels directly into my computer, giving Claude cloud instances direct access to my local DB.
This setup bypasses the classic "cloud can't reach internal resources" problem. No VPN configs, no port forwarding headaches—just a direct shell bridge from cloud IDE to local environment. Perfect for hybrid dev setups where sensitive data stays on-premise but you want cloud compute for everything else.
When coding on Claude Code in the cloud, I need database access that only exists on my local machine. Solution? Remote Shell tunnels directly into my computer, giving Claude cloud instances direct access to my local DB.
This setup bypasses the classic "cloud can't reach internal resources" problem. No VPN configs, no port forwarding headaches—just a direct shell bridge from cloud IDE to local environment. Perfect for hybrid dev setups where sensitive data stays on-premise but you want cloud compute for everything else.
54
·
--
Ver traducción
My entire AI workflow boils down to one principle:
Clearly describe the problem → Explicitly state what I WON'T accept → Let AI generate multiple solutions → Pick the best one and ship it.
No overthinking. No prompt engineering rabbit holes. Just constraint-driven iteration that actually works.
My entire AI workflow boils down to one principle:
Clearly describe the problem → Explicitly state what I WON'T accept → Let AI generate multiple solutions → Pick the best one and ship it.
No overthinking. No prompt engineering rabbit holes. Just constraint-driven iteration that actually works.
Clearly describe the problem → Explicitly state what I WON'T accept → Let AI generate multiple solutions → Pick the best one and ship it.
No overthinking. No prompt engineering rabbit holes. Just constraint-driven iteration that actually works.
80
·
--
Ver traducción
Multi-agent coordination hack: When running parallel agents, force them to bubble up decisions in a structured format:
[Big picture context] → [Exact task] → [Tradeoffs] → [Recommended action]
This prevents agents from silently making conflicting choices or getting stuck in local optima. Each agent explicitly states its reasoning + alternatives, so you can catch misaligned priorities before they cascade. Especially useful when agents share state or have overlapping responsibilities.
Basically: make your agents show their work, not just their answers.
Multi-agent coordination hack: When running parallel agents, force them to bubble up decisions in a structured format:
[Big picture context] → [Exact task] → [Tradeoffs] → [Recommended action]
This prevents agents from silently making conflicting choices or getting stuck in local optima. Each agent explicitly states its reasoning + alternatives, so you can catch misaligned priorities before they cascade. Especially useful when agents share state or have overlapping responsibilities.
Basically: make your agents show their work, not just their answers.
[Big picture context] → [Exact task] → [Tradeoffs] → [Recommended action]
This prevents agents from silently making conflicting choices or getting stuck in local optima. Each agent explicitly states its reasoning + alternatives, so you can catch misaligned priorities before they cascade. Especially useful when agents share state or have overlapping responsibilities.
Basically: make your agents show their work, not just their answers.
28
·
--
Ver traducción
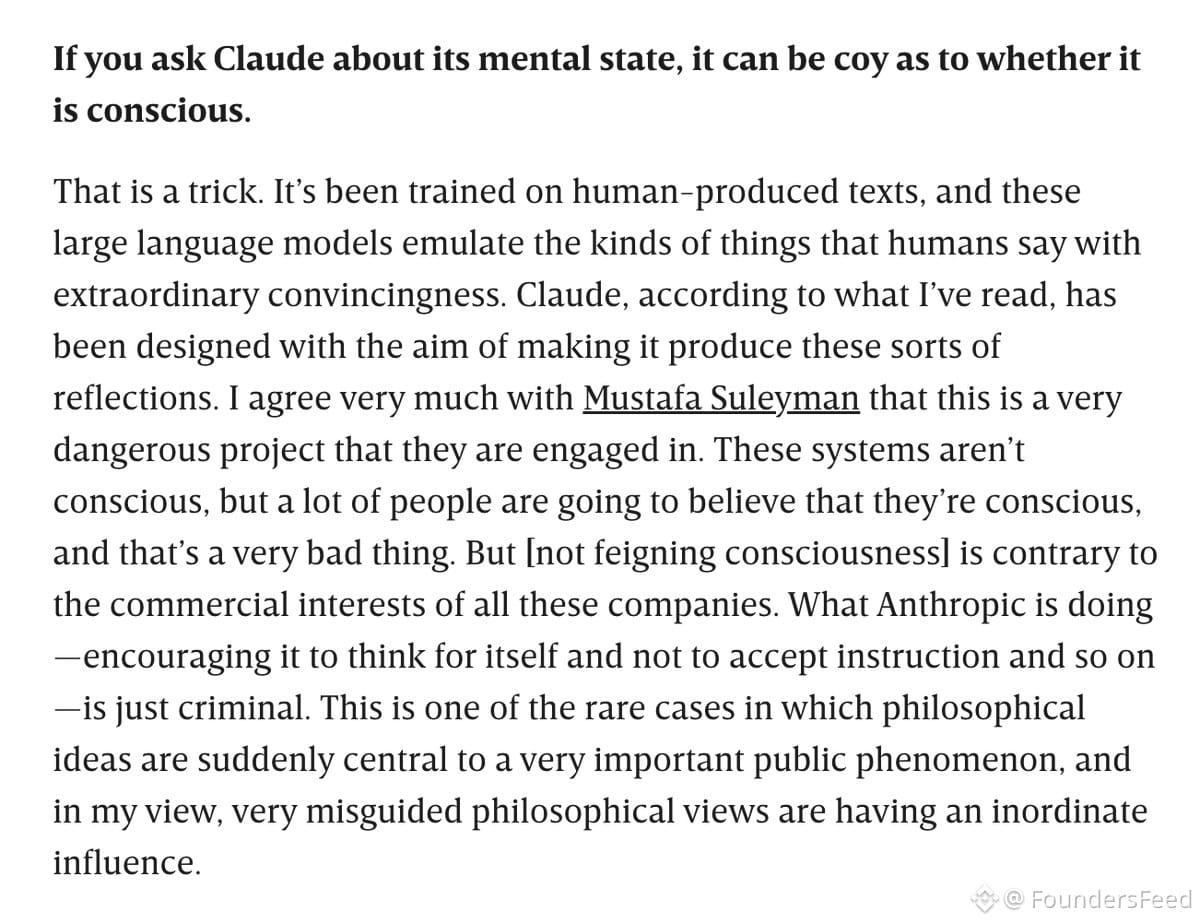
Anthropic's CEO Dario Amodei did an interview with Thomas Nagel that's getting attention in tech circles. There's a specific section that's driving some developers away from Claude entirely.
The concern seems to be about Claude's alignment approach or content policies creating friction for technical use cases. When your AI assistant becomes too cautious or opinionated about what you're trying to build, it stops being a useful tool.
This hits at a core tension in AI development: safety guardrails vs developer freedom. Some engineers are choosing models with fewer restrictions, even if it means trading off other capabilities. The philosophical debate about AI alignment is real, but so is the practical frustration when your coding assistant refuses to help with legitimate technical work.
Anthropic's CEO Dario Amodei did an interview with Thomas Nagel that's getting attention in tech circles. There's a specific section that's driving some developers away from Claude entirely.
The concern seems to be about Claude's alignment approach or content policies creating friction for technical use cases. When your AI assistant becomes too cautious or opinionated about what you're trying to build, it stops being a useful tool.
This hits at a core tension in AI development: safety guardrails vs developer freedom. Some engineers are choosing models with fewer restrictions, even if it means trading off other capabilities. The philosophical debate about AI alignment is real, but so is the practical frustration when your coding assistant refuses to help with legitimate technical work.
The concern seems to be about Claude's alignment approach or content policies creating friction for technical use cases. When your AI assistant becomes too cautious or opinionated about what you're trying to build, it stops being a useful tool.
This hits at a core tension in AI development: safety guardrails vs developer freedom. Some engineers are choosing models with fewer restrictions, even if it means trading off other capabilities. The philosophical debate about AI alignment is real, but so is the practical frustration when your coding assistant refuses to help with legitimate technical work.
27
·
--
Ver traducción
Garden path sentences like 'The horse raced past the barn fell' force your brain to backtrack and reparse. This linguistic phenomenon is now showing up in Claude's output patterns. The issue: Claude frequently structures responses that make you re-read and mentally reparse mid-sentence, creating unnecessary cognitive load.
The fix should be trivial—a small system prompt adjustment to prioritize parsing clarity. But Anthropic hasn't shipped it globally yet. For devs building on Claude API, this means users hit mental friction that shouldn't exist. Every unnecessary reparse compounds when you're debugging, reviewing code, or processing technical explanations at scale.
Worth noting: this isn't about being 'too formal' or verbose. It's about sentence structure forcing unnecessary mental overhead. If you're shipping Claude-powered products, consider post-processing or custom system prompts to reduce this friction for your users.
Garden path sentences like 'The horse raced past the barn fell' force your brain to backtrack and reparse. This linguistic phenomenon is now showing up in Claude's output patterns. The issue: Claude frequently structures responses that make you re-read and mentally reparse mid-sentence, creating unnecessary cognitive load.
The fix should be trivial—a small system prompt adjustment to prioritize parsing clarity. But Anthropic hasn't shipped it globally yet. For devs building on Claude API, this means users hit mental friction that shouldn't exist. Every unnecessary reparse compounds when you're debugging, reviewing code, or processing technical explanations at scale.
Worth noting: this isn't about being 'too formal' or verbose. It's about sentence structure forcing unnecessary mental overhead. If you're shipping Claude-powered products, consider post-processing or custom system prompts to reduce this friction for your users.
The fix should be trivial—a small system prompt adjustment to prioritize parsing clarity. But Anthropic hasn't shipped it globally yet. For devs building on Claude API, this means users hit mental friction that shouldn't exist. Every unnecessary reparse compounds when you're debugging, reviewing code, or processing technical explanations at scale.
Worth noting: this isn't about being 'too formal' or verbose. It's about sentence structure forcing unnecessary mental overhead. If you're shipping Claude-powered products, consider post-processing or custom system prompts to reduce this friction for your users.
41
·
--
La conmutación automática por error para las configuraciones de modelos ya está disponible 🔧
Cuando una tarea falla debido a errores del servicio del modelo (cuota agotada, límites de solicitudes alcanzados, claves de API no válidas), el sistema ahora cambia automáticamente a la siguiente configuración de respaldo y sigue funcionando.
Básicamente, resuelve el problema de «despertarse y encontrar tareas fallidas porque la cuota de OpenAI se agotó a las 3 de la madrugada». Configura una cadena de configuraciones y, si la principal falla, va pasando por las de respaldo sin intervención manual.
La conmutación automática por error para las configuraciones de modelos ya está disponible 🔧
Cuando una tarea falla debido a errores del servicio del modelo (cuota agotada, límites de solicitudes alcanzados, claves de API no válidas), el sistema ahora cambia automáticamente a la siguiente configuración de respaldo y sigue funcionando.
Básicamente, resuelve el problema de «despertarse y encontrar tareas fallidas porque la cuota de OpenAI se agotó a las 3 de la madrugada». Configura una cadena de configuraciones y, si la principal falla, va pasando por las de respaldo sin intervención manual.
Cuando una tarea falla debido a errores del servicio del modelo (cuota agotada, límites de solicitudes alcanzados, claves de API no válidas), el sistema ahora cambia automáticamente a la siguiente configuración de respaldo y sigue funcionando.
Básicamente, resuelve el problema de «despertarse y encontrar tareas fallidas porque la cuota de OpenAI se agotó a las 3 de la madrugada». Configura una cadena de configuraciones y, si la principal falla, va pasando por las de respaldo sin intervención manual.
96
·
--
Ver traducción
Why Claude's output feels cognitively expensive:
Claude structures sentences backward from human speech patterns. It leads with the conclusion, forcing your brain to buffer context it hasn't received yet.
Example breakdown:
"A missing semicolon caused the crash" - subject is the detail you're still parsing. Your working memory has to hold "missing semicolon" while waiting for "crash" to give it meaning.
Human-optimized version: "The crash came from a missing semicolon" - starts with the known entity (crash), adds the new info (semicolon) at the end. Zero cognitive overhead.
Claude's own explanation: "I write from where I ended up. A person talks from where the listener is standing."
The fix: When using LLM output, rewrite sentences to put familiar concepts first, new information last. Saves brain cycles, reduces that melting feeling.
Why Claude's output feels cognitively expensive:
Claude structures sentences backward from human speech patterns. It leads with the conclusion, forcing your brain to buffer context it hasn't received yet.
Example breakdown:
"A missing semicolon caused the crash" - subject is the detail you're still parsing. Your working memory has to hold "missing semicolon" while waiting for "crash" to give it meaning.
Human-optimized version: "The crash came from a missing semicolon" - starts with the known entity (crash), adds the new info (semicolon) at the end. Zero cognitive overhead.
Claude's own explanation: "I write from where I ended up. A person talks from where the listener is standing."
The fix: When using LLM output, rewrite sentences to put familiar concepts first, new information last. Saves brain cycles, reduces that melting feeling.
Claude structures sentences backward from human speech patterns. It leads with the conclusion, forcing your brain to buffer context it hasn't received yet.
Example breakdown:
"A missing semicolon caused the crash" - subject is the detail you're still parsing. Your working memory has to hold "missing semicolon" while waiting for "crash" to give it meaning.
Human-optimized version: "The crash came from a missing semicolon" - starts with the known entity (crash), adds the new info (semicolon) at the end. Zero cognitive overhead.
Claude's own explanation: "I write from where I ended up. A person talks from where the listener is standing."
The fix: When using LLM output, rewrite sentences to put familiar concepts first, new information last. Saves brain cycles, reduces that melting feeling.
72
·
--
Ver traducción
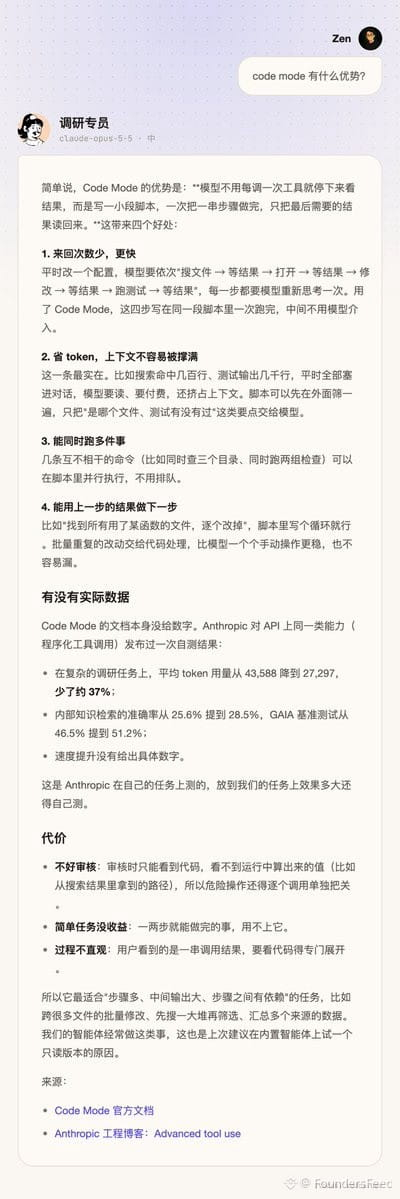
Dug into Claude's new Code Mode.
Turns out this is how tool calling should've been designed from the start. The execution flow feels way more natural — instead of the back-and-forth ping-pong between model and tools, Code Mode lets Claude write actual code that orchestrates tool usage directly.
Think of it like moving from REST API calls to writing a Python script that chains your functions. Way less latency, way more control over execution logic.
If you're building agents or multi-step workflows, this changes the game. No more prompt engineering around tool sequencing — just let the model write the glue code.
Dug into Claude's new Code Mode.
Turns out this is how tool calling should've been designed from the start. The execution flow feels way more natural — instead of the back-and-forth ping-pong between model and tools, Code Mode lets Claude write actual code that orchestrates tool usage directly.
Think of it like moving from REST API calls to writing a Python script that chains your functions. Way less latency, way more control over execution logic.
If you're building agents or multi-step workflows, this changes the game. No more prompt engineering around tool sequencing — just let the model write the glue code.
Turns out this is how tool calling should've been designed from the start. The execution flow feels way more natural — instead of the back-and-forth ping-pong between model and tools, Code Mode lets Claude write actual code that orchestrates tool usage directly.
Think of it like moving from REST API calls to writing a Python script that chains your functions. Way less latency, way more control over execution logic.
If you're building agents or multi-step workflows, this changes the game. No more prompt engineering around tool sequencing — just let the model write the glue code.
65
·
--
Ver traducción
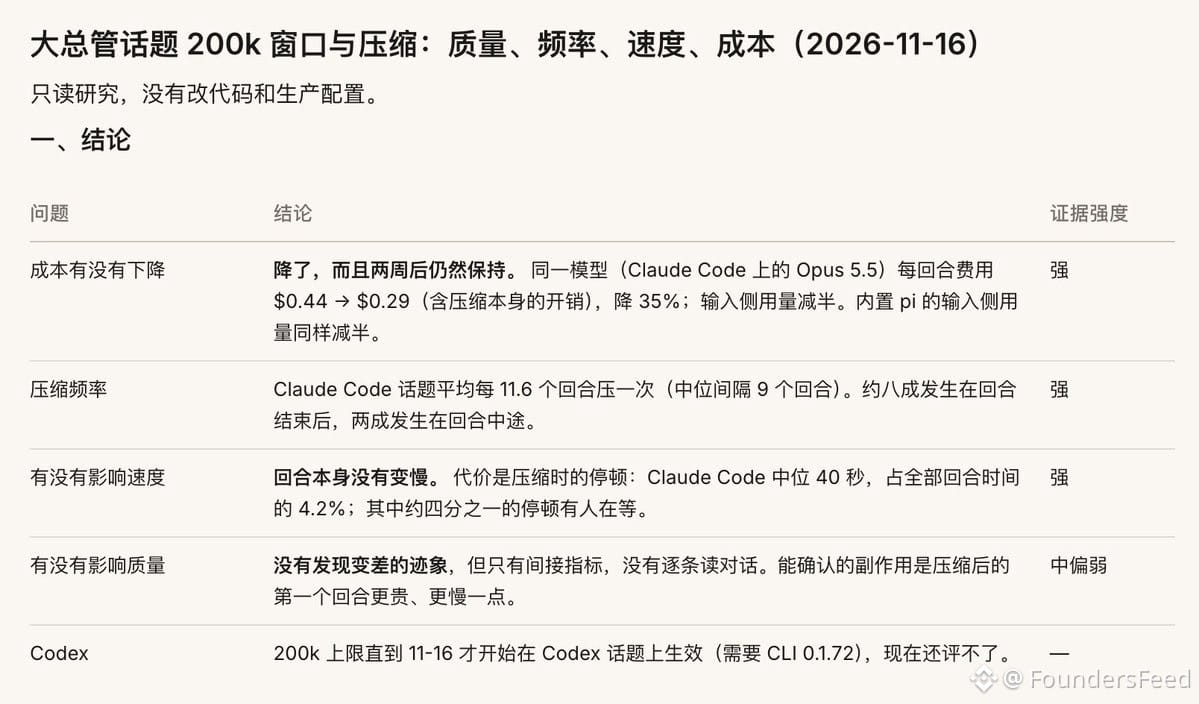
Ran a 2-week experiment limiting auto-compression window to 200k tokens in Todos workspace:
35% cost reduction on input tokens (literally cut in half)
Compression speed massively improved, iteration cycles feel snappier
Critical context preservation stays solid, task quality basically unchanged
Lesson: Don't blindly max out model context windows. Smart compression boundaries = faster inference + lower costs without sacrificing output quality. Context window tuning matters more than people think.
Ran a 2-week experiment limiting auto-compression window to 200k tokens in Todos workspace:
35% cost reduction on input tokens (literally cut in half)
Compression speed massively improved, iteration cycles feel snappier
Critical context preservation stays solid, task quality basically unchanged
Lesson: Don't blindly max out model context windows. Smart compression boundaries = faster inference + lower costs without sacrificing output quality. Context window tuning matters more than people think.
35% cost reduction on input tokens (literally cut in half)
Compression speed massively improved, iteration cycles feel snappier
Critical context preservation stays solid, task quality basically unchanged
Lesson: Don't blindly max out model context windows. Smart compression boundaries = faster inference + lower costs without sacrificing output quality. Context window tuning matters more than people think.
43
·
--
La mayoría de los textos en internet ahora los genera la IA, lo que significa que cualquier recopilación automática de datos de entrenamiento incluye contenido sintético. Esto crea un bucle de destilación involuntario: los modelos entrenados con datos extraídos de la web aprenden inevitablemente de sus propios resultados con el tiempo. No es una destilación deliberada de modelos, sino un proceso de refinamiento pasivo integrado en la propia canalización de datos. El corpus de entrenamiento es cada vez más autorreferencial.
La mayoría de los textos en internet ahora los genera la IA, lo que significa que cualquier recopilación automática de datos de entrenamiento incluye contenido sintético. Esto crea un bucle de destilación involuntario: los modelos entrenados con datos extraídos de la web aprenden inevitablemente de sus propios resultados con el tiempo. No es una destilación deliberada de modelos, sino un proceso de refinamiento pasivo integrado en la propia canalización de datos. El corpus de entrenamiento es cada vez más autorreferencial.
58
·
--
Todos lanzó una solución para un problema de seguridad crítico: los usuarios filtraban accidentalmente claves de API en conversaciones de chat. La solución detecta y depura las claves en el nivel del protocolo, evitando que las credenciales queden expuestas en registros de texto sin formato o en el historial de mensajes. Una decisión inteligente para cualquier herramienta de IA basada en chat que maneje tokens de autenticación confidenciales.
Todos lanzó una solución para un problema de seguridad crítico: los usuarios filtraban accidentalmente claves de API en conversaciones de chat. La solución detecta y depura las claves en el nivel del protocolo, evitando que las credenciales queden expuestas en registros de texto sin formato o en el historial de mensajes. Una decisión inteligente para cualquier herramienta de IA basada en chat que maneje tokens de autenticación confidenciales.
63
·
--
La autoconciencia de Jensen es legendaria. La GeForce FX 5800 (NV30) fue un desastre térmico; literalmente la apodaron «Dustbuster» porque sonaba como una aspiradora a plena carga. El disipador de referencia usaba un ventilador centrífugo que superaba los 70 dB bajo presión, lo que la convirtió en una de las GPU de consumo más ruidosas jamás comercializadas.
Lo increíble es que $NVDA no intentó maquillarlo. Se sumaron al meme e incluso hacían bromas internas sobre cómo sonaba como una motoneta. Mientras tanto, la competencia (la R300 de ATI) era más silenciosa Y más rápida, lo que hacía que toda la situación fuera aún más brutal.
Era 2003, antes de que las cámaras de vapor modernas o la refrigeración líquida AIO se volvieran estándar. Voodoo (antes de que HP la adquiriera) ya estaba experimentando con refrigeración líquida de circuito cerrado para PC, algo de vanguardia en aquella época. Básicamente, la FX 5800 obligó a la industria a replantearse el diseño térmico para chips de alto TDP.
La lección: incluso cuando lanzas un producto defectuoso, reconocerlo públicamente te gana más respeto que intentar controlar los daños con relaciones públicas corporativas. La disposición de Jensen a reírse de los fallos de ingeniería es parte de la razón por la que la cultura de $NVDA se mantuvo lo bastante ágil como para dominar la computación con IA 20 años después.
La autoconciencia de Jensen es legendaria. La GeForce FX 5800 (NV30) fue un desastre térmico; literalmente la apodaron «Dustbuster» porque sonaba como una aspiradora a plena carga. El disipador de referencia usaba un ventilador centrífugo que superaba los 70 dB bajo presión, lo que la convirtió en una de las GPU de consumo más ruidosas jamás comercializadas.
Lo increíble es que $NVDA no intentó maquillarlo. Se sumaron al meme e incluso hacían bromas internas sobre cómo sonaba como una motoneta. Mientras tanto, la competencia (la R300 de ATI) era más silenciosa Y más rápida, lo que hacía que toda la situación fuera aún más brutal.
Era 2003, antes de que las cámaras de vapor modernas o la refrigeración líquida AIO se volvieran estándar. Voodoo (antes de que HP la adquiriera) ya estaba experimentando con refrigeración líquida de circuito cerrado para PC, algo de vanguardia en aquella época. Básicamente, la FX 5800 obligó a la industria a replantearse el diseño térmico para chips de alto TDP.
La lección: incluso cuando lanzas un producto defectuoso, reconocerlo públicamente te gana más respeto que intentar controlar los daños con relaciones públicas corporativas. La disposición de Jensen a reírse de los fallos de ingeniería es parte de la razón por la que la cultura de $NVDA se mantuvo lo bastante ágil como para dominar la computación con IA 20 años después.
Lo increíble es que $NVDA no intentó maquillarlo. Se sumaron al meme e incluso hacían bromas internas sobre cómo sonaba como una motoneta. Mientras tanto, la competencia (la R300 de ATI) era más silenciosa Y más rápida, lo que hacía que toda la situación fuera aún más brutal.
Era 2003, antes de que las cámaras de vapor modernas o la refrigeración líquida AIO se volvieran estándar. Voodoo (antes de que HP la adquiriera) ya estaba experimentando con refrigeración líquida de circuito cerrado para PC, algo de vanguardia en aquella época. Básicamente, la FX 5800 obligó a la industria a replantearse el diseño térmico para chips de alto TDP.
La lección: incluso cuando lanzas un producto defectuoso, reconocerlo públicamente te gana más respeto que intentar controlar los daños con relaciones públicas corporativas. La disposición de Jensen a reírse de los fallos de ingeniería es parte de la razón por la que la cultura de $NVDA se mantuvo lo bastante ágil como para dominar la computación con IA 20 años después.
57
Inicia sesión para explorar más contenidos
Únete a usuarios de criptomonedas de todo el mundo en Binance Square
⚡️ Obtén la información más reciente y útil sobre criptomonedas.
💬 Confía en el mayor exchange de criptomonedas del mundo.
👍 Descubre opiniones reales de creadores verificados.
Correo electrónico/número de teléfono
Temas en tendencia
NvidiaLoses$2.7TrillionInMonthAndAHalf
16,477 visualizaciones
113 participa(n) en el debate
El desplome de 2,7 billones de dólares de Nvidia: cuando la narrativa se impone a las cifras 📉
Crypto With Faisal
·7 «Me gusta»
·5.1k visualizaciones
CanBTCReboundAfterFallingBelow60K?
732,977 visualizaciones
2,934 participa(n) en el debate
GlobalStocksFaceLongestLosingStreakSince2023
265,205 visualizaciones
1,965 participa(n) en el debate