


2024.03.14
Introducción al proyecto
Lanzado en junio pasado, Grass construye una red descentralizada de web scraping centrada en convertir datos web públicos en conjuntos de datos de IA. La red es propiedad de los usuarios y está operada por ellos y es la forma más fácil para que cualquiera interactúe con la IA. Todos pueden crear rápidamente su propio nodo Grass. Para obtener más información, puede consultar el tutorial publicado anteriormente por Goose. ¡También puede reproducirlo en su teléfono móvil!
En la actualidad, el precio de Whales ha alcanzado los 4,6U/1.000 puntos dentro y fuera del mercado. En condiciones de red del 75%, un solo dispositivo IP puede extraer alrededor de 50.000 puntos en un mes, que son 240U. Hace mucho tiempo, Goose te pidió que minaras, pero mucha gente era demasiado vaga para minar. Ahora te digo que puedes minar 240u con tu computadora o teléfono móvil encendido durante un mes. En casa de familiares y amigos durante el Año Nuevo Chino, habrá varios 240u. ¿Te arrepientes un poco? Si te arrepientes, ¡ven y haz tu tarea rápidamente! !
Actualmente, Grass planea lanzar el primer paquete acumulativo de datos de capa 2 en SOL. Goose lo ha dividido especialmente en una versión que es demasiado larga para leer y una versión del artículo oficial para que los amigos la lean y comprendan.
Demasiado tiempo para mirar
Antes de que Grass propusiera este plan, solo tenía el concepto de DEPIN más AI, pero ahora planea construir su propia cadena pública de AI. Esto significa que Grass se ha expandido a otro modelo de negocio que es completamente diferente al anterior. Ha agregado funciones de registro de datos y funciones de procesador ZK a su simple negocio anterior de ayudar a las empresas de inteligencia artificial a limpiar datos. Una vez que se construye la Capa 2, su concepto se convertirá en SOL + DEPIN + AI + el primer concepto de acumulación de datos. No diré lo valioso que es.
Tutorial de la versión para PC:
https://weibo.com/ttarticle/p/show?id=2309404997006383775962
Tutorial de la versión móvil:
https://weibo.com/ttarticle/p/show?id=2309404998038614573232
positivo
Grass: el primer paquete acumulativo de datos de capa 2 de la historia
Durante las últimas semanas, publicamos contenido para explicar el papel de Grass en la pila de IA. Ahora ha aprendido que este protocolo realiza muchas funciones para ayudar a los constructores a acceder a los datos de la red para entrenar sus modelos. Esta es la primera etapa crítica del proceso de IA y el punto de partida de todo desarrollo.
En el caso de Grass, un conjunto de nodos están alojados en dispositivos residentes, extrayendo y procesando datos sin procesar de la red. Limpia y transforma datos en conjuntos de datos estructurados para el entrenamiento de IA. Lo mejor de todo es que captura datos de la red de una manera que involucra y recompensa a casi un millón de personas en todo el mundo por participar. Por sí solo crea una categoría en el suministro de datos de IA y es por eso que algunas de las empresas de IA más grandes del mundo eligen trabajar con nosotros. Es la capa de datos de la IA.
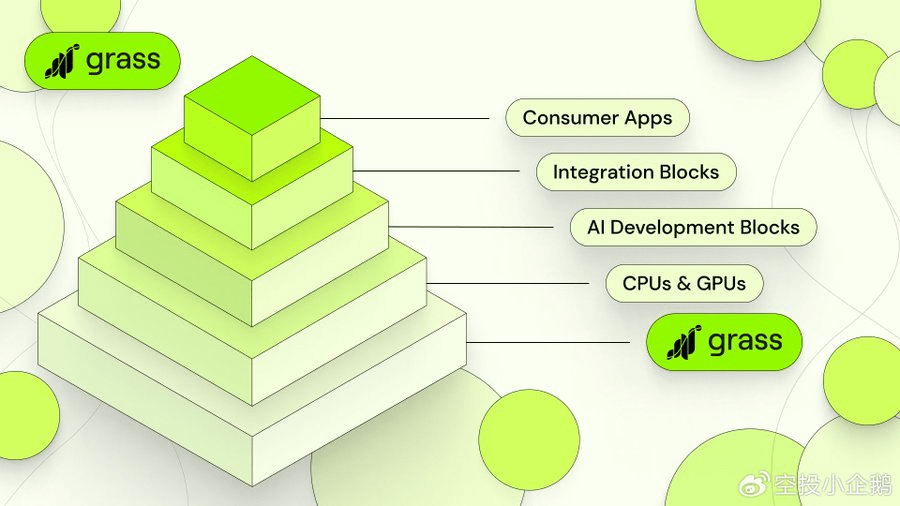
Mientras tanto, hemos pasado las últimas semanas pensando en el estado actual de la inteligencia artificial. Nos preguntamos cuáles son los problemas más apremiantes y qué podemos hacer para resolverlos como componente crítico de la infraestructura de IA.
Concluimos que el mayor problema al que se enfrenta la IA hoy en día es la falta de transparencia de los datos. Sólo mira las noticias y lo entenderás. Pregúntese: ¿por qué un modelo de IA compararía a Elon Musk con Hitler? ¿O borrar grupos étnicos enteros de la historia mundial? ¿Se utilizaron datos incorrectos durante el entrenamiento? ¿O peor aún, utilizar buenos datos que selectivamente dan respuestas incorrectas?
La respuesta es que no lo sabemos. Y no lo sabemos porque no hay forma de saberlo. No sabemos con qué datos se entrenaron estos modelos porque no existe ningún mecanismo para probarlo. No hay forma de que los usuarios verifiquen el origen de los datos, al igual que los constructores no tienen forma de verificarlos ellos mismos.
Este es el problema que Grass planea resolver y ahora estamos creando un paquete acumulativo de datos de Capa 2 para resolver este problema. ¿Cómo?, te preguntarás.
Por favor permítanos explicarle.
Capa dos Cómo crear fuentes de datos
El mundo necesita una forma de demostrar la procedencia de los datos de entrenamiento de IA, y eso es lo que Grass está construyendo ahora. Pronto, cada vez que un nodo de Grass extraiga datos, se registrarán metadatos para autenticar el sitio web del que se extrajeron los datos. Luego, estos metadatos se integran permanentemente en cada conjunto de datos, lo que permite a los constructores estar completamente seguros de su procedencia. Luego pueden compartir este pedigrí con los usuarios, quienes pueden estar seguros de que el modelo de IA con el que interactúan no ha sido entrenado deliberadamente para dar respuestas engañosas.
Este fue un esfuerzo significativo y requirió importantes extensiones de nuestro protocolo en preparación para escalar las operaciones de scraping a decenas de millones de solicitudes de red por minuto. Cada solicitud requerirá validación, lo que supondrá un rendimiento mayor que el que cualquier L1 puede proporcionar. Es por eso que anunciamos planes para crear una solución de Capa 2 para manejar una actualización importante de nuestras capacidades. El L2 será un paquete soberano, equipado con un procesador ZK para que los metadatos puedan agruparse para su validación y usarse para proporcionar un linaje persistente para cada conjunto de datos que produzcamos. Esto es necesario para permitir que la capa fundamental de todo el desarrollo de la IA pase a la siguiente etapa.
Los beneficios de hacer esto son muchos: protegerá contra la contaminación de datos, potenciará la IA de código abierto y brindará transparencia a los modelos con los que interactuamos todos los días.
A continuación, describimos el diseño básico del sistema.
La arquitectura de la hierba
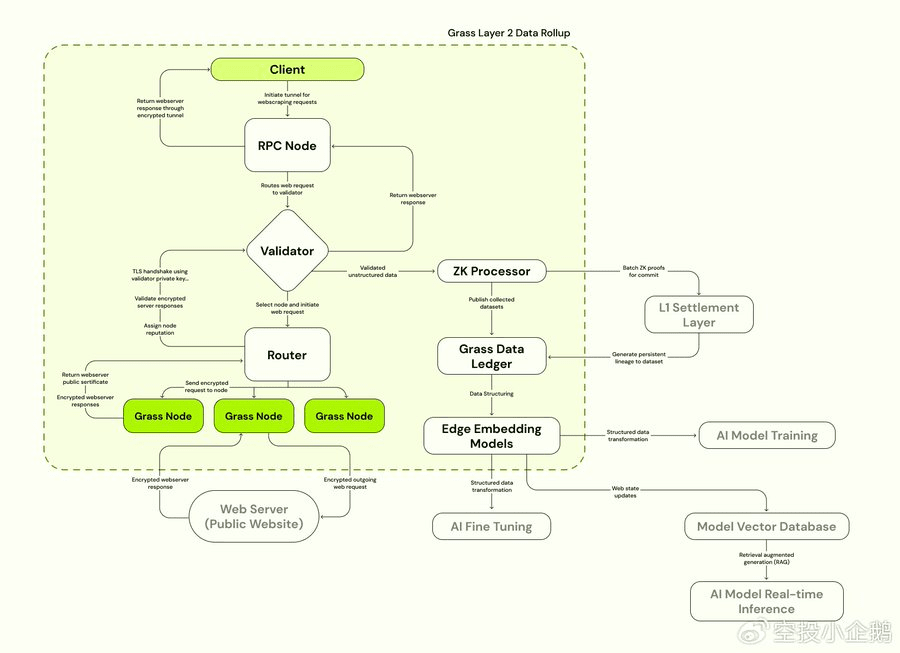
La forma más sencilla de comprender estas actualizaciones es observar un gráfico del resumen de datos de Grass. A la izquierda, entre el cliente y el servidor web, se ve la red de Grass, tal como se define tradicionalmente. El cliente realiza una solicitud de red, pasa por el validador y, finalmente, es enrutado a través del nodo Grass. El servidor del sitio web solicitado por el cliente responderá a la solicitud de la red, permitiendo que sus datos sean rastreados y enviados de regreso a través de la línea. Luego, los datos se limpiarán, procesarán y prepararán para entrenar la próxima generación de modelos de IA.
En el diagrama L2, verá dos adiciones importantes a la derecha que se agregarán con el lanzamiento de Sovereign Layer 2 de Grass: Grass Data Ledger y ZK Processor.
Ambos tienen sus propias funciones, por lo que los explicaremos uno por uno.
Libro mayor de datos de hierba
El libro de datos es el lugar de almacenamiento final de todos los datos de Grass. Es un libro de contabilidad permanente de cada conjunto de datos rastreado en Grass, ahora con metadatos integrados para registrar su linaje desde el momento de su origen. La prueba de los metadatos para cada conjunto de datos se almacenará en la capa de liquidación de Solana y se podrá acceder a los datos de liquidación a través del libro mayor. Es necesario señalar la importancia de que Grass tenga un lugar para almacenar los datos que extrae, aunque llegaremos a eso en breve.
procesador ZK
Como describimos anteriormente, el propósito del procesador ZK es ayudar a documentar el origen de los conjuntos de datos extraídos de la red Grass. Imagínese este proceso.
Cuando un nodo de la red (en otras palabras, un usuario que utiliza la extensión Grass) envía una solicitud de red a un sitio web determinado, devuelve una respuesta cifrada que contiene todos los datos solicitados por el nodo. A todos los efectos, este es el momento en el que nació nuestro conjunto de datos y el momento del origen que debe registrarse.
Y este es exactamente el momento que capturamos cuando registramos metadatos. Contiene muchos campos: la clave de sesión, la URL del sitio web rastreado, la dirección IP del sitio web de destino, la marca de tiempo de la transacción y, por supuesto, los datos en sí. Esta es toda la información necesaria para saber sin lugar a dudas que un conjunto de datos en particular proviene del sitio web que dice ser y, por lo tanto, que un modelo de IA en particular fue entrenado correcta y fielmente.
La función del procesador ZK es que estos datos deben liquidarse en la cadena, pero no queremos que todos estos datos sean visibles para los validadores de Solana. Además, la gran cantidad de solicitudes de red realizadas en Grass en el futuro inevitablemente excederá las capacidades de rendimiento de cualquier L1, incluso una L1 tan poderosa como Solana. Grass pronto escalará hasta el punto de realizar decenas de millones de solicitudes de red por minuto, y los metadatos de cada solicitud deberán resolverse en la cadena. Sería imposible para nosotros enviar estas transacciones a L1 sin que el procesador ZK realice las pruebas y las agrupe primero. Por tanto, L2 es la única forma posible de alcanzar los objetivos que nos proponemos.
Ahora bien, ¿por qué es esto tan importante?
Beneficios de la capa 2
libro mayor de datos
La importancia del libro de contabilidad de datos es que eleva el escalamiento de Grass a otro modelo de negocio, y fundamentalmente diferente. Si bien el protocolo continuará examinando a los compradores que envían sus propias solicitudes de red y recopilan sus propios datos en la web, una parte cada vez mayor de su actividad involucrará datos ya almacenados en el libro mayor. Con esta capacidad, Grass ahora puede extraer datos estratégicamente para la capacitación LLM y alojarlos en un repositorio de datos en constante expansión.
Este repositorio es la capa de datos de una pila modular de IA, desde la cual los constructores pueden elegir bloques de construcción para entrenar modelos infinitamente diferentes. Es esencialmente un modelo en miniatura de Internet, que proporciona datos de entrenamiento que ya están estructurados y listos para que la IA los ingiera.
procesador ZK
Hemos cubierto en detalle por qué los procesadores ZK son importantes. Al permitirnos crear pruebas de metadatos que documenten la procedencia de un conjunto de datos de Grass, proporciona un mecanismo para que los constructores y usuarios verifiquen que un modelo de IA, de hecho, se entrenó correctamente. Eso en sí mismo es un gran problema.
Sin embargo, hay una cosa que no mencionamos antes.
Además de registrar el sitio web desde el que se originó el conjunto de datos, los metadatos también indican los nodos a través de los cuales viajó el conjunto de datos en la red. Sorprendentemente, esto significa que cada vez que un nodo rastrea la red, puede obtener crédito por su trabajo sin revelar ninguna información que lo identifique.
Ahora bien, ¿por qué es esto importante?
Esto es importante porque una vez que puedas demostrar qué nodos hicieron qué trabajo, podrás comenzar a recompensarlos proporcionalmente. Algunos nodos son más valiosos que otros. Algunos nodos rastrean más datos que sus pares. Y estos son exactamente los nodos que debemos incentivar para continuar con la rápida expansión de la red que hemos visto en los últimos meses. Creemos que este mecanismo aumentará significativamente las recompensas para las zonas más necesitadas de todo el mundo y, en última instancia, animará a las personas de estos lugares a registrarse y aumentar exponencialmente la capacidad de la red.
No hace falta decir que cuanto más grande sea la red, mayores serán nuestras capacidades de rastreo y mayor será el depósito de datos de la red que almacenamos. Inevitablemente surgirá un ciclo de retroalimentación positiva, y más datos significa que tendremos más disponibles para los laboratorios de IA que necesitan datos de entrenamiento, proporcionando así incentivos para el crecimiento continuo de la red.
en conclusión
En general, la mayoría de los problemas pendientes en la IA hoy en día surgen de la falta de visibilidad sobre cómo se entrenan los modelos, lo que creemos que se puede resolver potenciando la IA de código abierto con sistemas que verifiquen la procedencia de los datos. Nuestra solución es crear el primer paquete acumulativo de datos de Capa 2, que permitirá introducir mecanismos para registrar metadatos de todas las fuentes de conjuntos de datos.
Las pruebas ZK de estos datos se almacenarán en la capa de liquidación L1, mientras que los metadatos en sí se vincularán en última instancia a sus conjuntos de datos subyacentes, ya que los conjuntos de datos en sí se almacenan en nuestro propio libro de datos. Grass proporciona una capa de datos para pilas modulares de IA, y estos desarrollos brindarán mayor transparencia y recompensas a los proveedores de nodos proporcionales a la cantidad de trabajo que realizan.
Esta actualización debería ayudar a comunicar algunos de nuestros próximos proyectos y aclarar el pensamiento que impulsa nuestras decisiones. Estamos entusiasmados de desempeñar un papel para hacer que la IA sea más transparente y entusiasmados con los muchos posibles casos de uso futuros para nuestros productos. Estas actualizaciones abrirán grandes oportunidades para los desarrolladores, por lo que si usted o su equipo están interesados en desarrollar Grass, comuníquese con nosotros a través de Discord. Gracias por su apoyo y estén atentos.
Participe en la revolución de la IA.