La nueva tarjeta de Intel de 350 W asegura ser 5,9 veces más rápida que Nvidia; la letra pequeña del apéndice revela los detalles
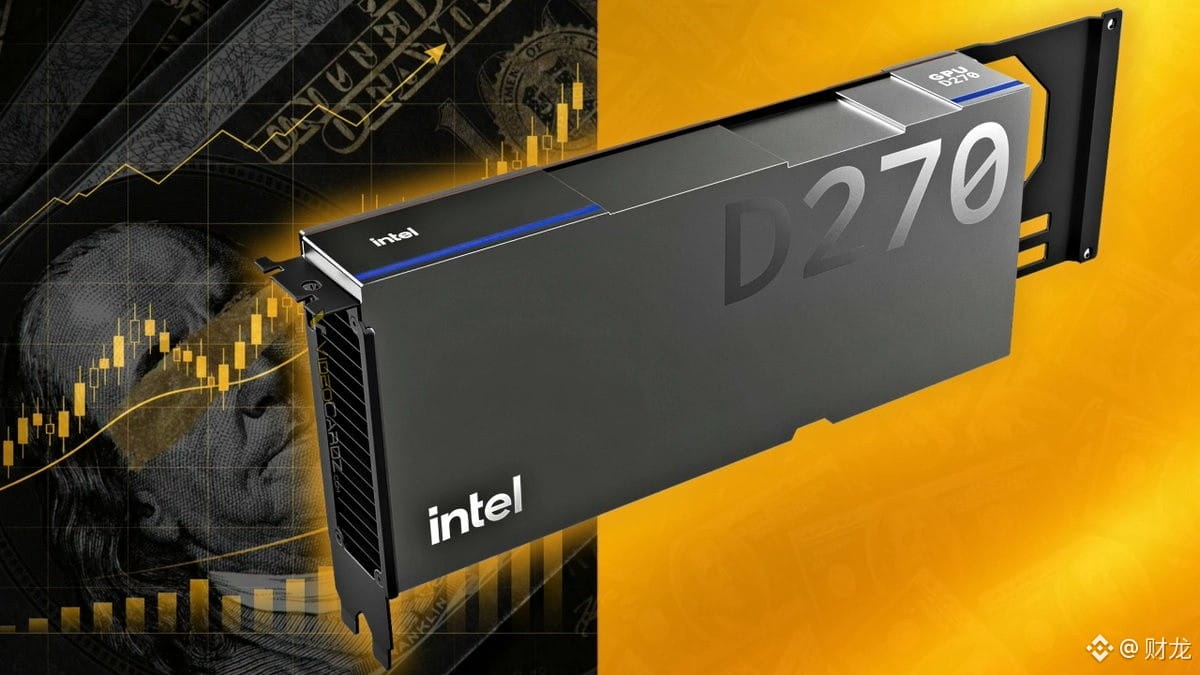
Intel ha publicado una serie de resultados de rendimiento: la D270 de 350 W es hasta 5,9 veces más rápida que la RTX PRO 6000 Blackwell de 600 W de Nvidia.
A primera vista, la cifra parece una barbaridad. Pero, tras revisar el informe de pruebas y sus apéndices, se ve que Intel eligió con mucho cuidado el terreno de juego y que sus puntos fuertes sí dan donde más le duele a Nvidia.
Empecemos por de dónde sale ese 5,9 veces.
Los resultados con mayor ventaja corresponden a la valoración de opciones mediante coma flotante de doble precisión (FP64), algo habitual en las finanzas cuantitativas. La simulación Monte Carlo europea es 5,9 veces más rápida; Black-Scholes, 5,6 veces; y la valoración mediante árboles binomiales, 4,6 veces.
La causa de una diferencia tan grande es la propia Nvidia. Para proteger los márgenes de sus tarjetas para centros de datos, como la B200 y la H200, recortó la capacidad FP64 de su modelo insignia para estaciones de trabajo, la RTX PRO 6000 Blackwell, hasta una proporción de 1:64. La D270 utiliza la arquitectura Xe3P y ofrece FP64 a velocidad nativa y completa, con 64 FMA FP64 por núcleo. Si compites en una tarea que tu rival ha limitado deliberadamente, es lógico tener las de ganar.
El apéndice también contiene un detalle interesante. El equipo de pruebas de Intel llevaba 1 D270 y 3 Arc Pro B70, mientras que el de Nvidia llevaba 8 RTX PRO 6000. El informe no especifica cuántas tarjetas usó cada sistema durante las pruebas financieras. Así que conviene tomarse este resultado de 5,9 veces con cautela.
En inferencia de modelos grandes, los resultados son más sólidos.
Con una sola tarjeta ejecutando Qwen3-30B-A3B (FP8), el rendimiento de salida de la D270 es 1,12 veces el de la RTX PRO 6000 Blackwell. Al ejecutar Drex 2.0, la latencia es un 29 % menor.
Un 1,12 veces puede parecer poco, pero hay que tener en cuenta el consumo. Con 350 W frente a 600 W, la D270 supera a la tarjeta tope de gama para estaciones de trabajo de Blackwell en modelos MoE de nivel 30B, consumiendo algo más de la mitad de energía. Su eficiencia energética es competitiva.
Lo más atractivo, sin embargo, es la memoria.
La RTX PRO 6000 consume 600 W y solo tiene 96 GB de GDDR7. Intel no ha intentado competir por la HBM, cara y escasa, sino que ha incorporado LPDDR5X directamente en una tarjeta PCIe de 350 W con refrigeración por aire. El modelo de referencia parte de 160 GB, con un ancho de banda de 1,5 TB/s. Las versiones personalizadas de los fabricantes de tarjetas pueden alcanzar hasta 480 GB en una sola tarjeta.
¿Qué significa tener 480 GB en una tarjeta refrigerada por aire? Antes, para cargar los pesos de un modelo enorme a plena capacidad, había que reunir un armario entero de tarjetas o recurrir a un clúster carísimo. Ahora basta con una tarjeta de 350 W. Para quienes quieren ejecutar modelos grandes de forma local, esta capacidad resulta más práctica que cualquier multiplicador de rendimiento.
Intel también ha presentado una forma de aprovecharla. En SC26, Intel y SambaNova propusieron una solución con tareas repartidas. La D270, con su gran capacidad de memoria, se encarga del Prefill (prefill) de enormes cantidades de contexto y luego pasa el trabajo a la SambaNova SN50, de gran ancho de banda, para generar Tokens. Cada una se ocupa de una parte, con una división del trabajo muy clara.
Durante años, Nvidia ha mantenido muy limitada la memoria, segmentando con precisión cada nivel. Si sigue por ese camino, es muy posible que Intel le arrebate una parte del lucrativo mercado de la inferencia con gran capacidad de memoria gracias a productos como este, que aprovechan LPDDR5X para ofrecer más capacidad.
Intel ha publicado una serie de resultados de rendimiento: la D270 de 350 W es hasta 5,9 veces más rápida que la RTX PRO 6000 Blackwell de 600 W de Nvidia.
A primera vista, la cifra parece una barbaridad. Pero, tras revisar el informe de pruebas y sus apéndices, se ve que Intel eligió con mucho cuidado el terreno de juego y que sus puntos fuertes sí dan donde más le duele a Nvidia.
Empecemos por de dónde sale ese 5,9 veces.
Los resultados con mayor ventaja corresponden a la valoración de opciones mediante coma flotante de doble precisión (FP64), algo habitual en las finanzas cuantitativas. La simulación Monte Carlo europea es 5,9 veces más rápida; Black-Scholes, 5,6 veces; y la valoración mediante árboles binomiales, 4,6 veces.
La causa de una diferencia tan grande es la propia Nvidia. Para proteger los márgenes de sus tarjetas para centros de datos, como la B200 y la H200, recortó la capacidad FP64 de su modelo insignia para estaciones de trabajo, la RTX PRO 6000 Blackwell, hasta una proporción de 1:64. La D270 utiliza la arquitectura Xe3P y ofrece FP64 a velocidad nativa y completa, con 64 FMA FP64 por núcleo. Si compites en una tarea que tu rival ha limitado deliberadamente, es lógico tener las de ganar.
El apéndice también contiene un detalle interesante. El equipo de pruebas de Intel llevaba 1 D270 y 3 Arc Pro B70, mientras que el de Nvidia llevaba 8 RTX PRO 6000. El informe no especifica cuántas tarjetas usó cada sistema durante las pruebas financieras. Así que conviene tomarse este resultado de 5,9 veces con cautela.
En inferencia de modelos grandes, los resultados son más sólidos.
Con una sola tarjeta ejecutando Qwen3-30B-A3B (FP8), el rendimiento de salida de la D270 es 1,12 veces el de la RTX PRO 6000 Blackwell. Al ejecutar Drex 2.0, la latencia es un 29 % menor.
Un 1,12 veces puede parecer poco, pero hay que tener en cuenta el consumo. Con 350 W frente a 600 W, la D270 supera a la tarjeta tope de gama para estaciones de trabajo de Blackwell en modelos MoE de nivel 30B, consumiendo algo más de la mitad de energía. Su eficiencia energética es competitiva.
Lo más atractivo, sin embargo, es la memoria.
La RTX PRO 6000 consume 600 W y solo tiene 96 GB de GDDR7. Intel no ha intentado competir por la HBM, cara y escasa, sino que ha incorporado LPDDR5X directamente en una tarjeta PCIe de 350 W con refrigeración por aire. El modelo de referencia parte de 160 GB, con un ancho de banda de 1,5 TB/s. Las versiones personalizadas de los fabricantes de tarjetas pueden alcanzar hasta 480 GB en una sola tarjeta.
¿Qué significa tener 480 GB en una tarjeta refrigerada por aire? Antes, para cargar los pesos de un modelo enorme a plena capacidad, había que reunir un armario entero de tarjetas o recurrir a un clúster carísimo. Ahora basta con una tarjeta de 350 W. Para quienes quieren ejecutar modelos grandes de forma local, esta capacidad resulta más práctica que cualquier multiplicador de rendimiento.
Intel también ha presentado una forma de aprovecharla. En SC26, Intel y SambaNova propusieron una solución con tareas repartidas. La D270, con su gran capacidad de memoria, se encarga del Prefill (prefill) de enormes cantidades de contexto y luego pasa el trabajo a la SambaNova SN50, de gran ancho de banda, para generar Tokens. Cada una se ocupa de una parte, con una división del trabajo muy clara.
Durante años, Nvidia ha mantenido muy limitada la memoria, segmentando con precisión cada nivel. Si sigue por ese camino, es muy posible que Intel le arrebate una parte del lucrativo mercado de la inferencia con gran capacidad de memoria gracias a productos como este, que aprovechan LPDDR5X para ofrecer más capacidad.