La moderación de contenido NSFW de GPT-6.2 parece haberse relajado, y el propio informe de OpenAI lo confirma
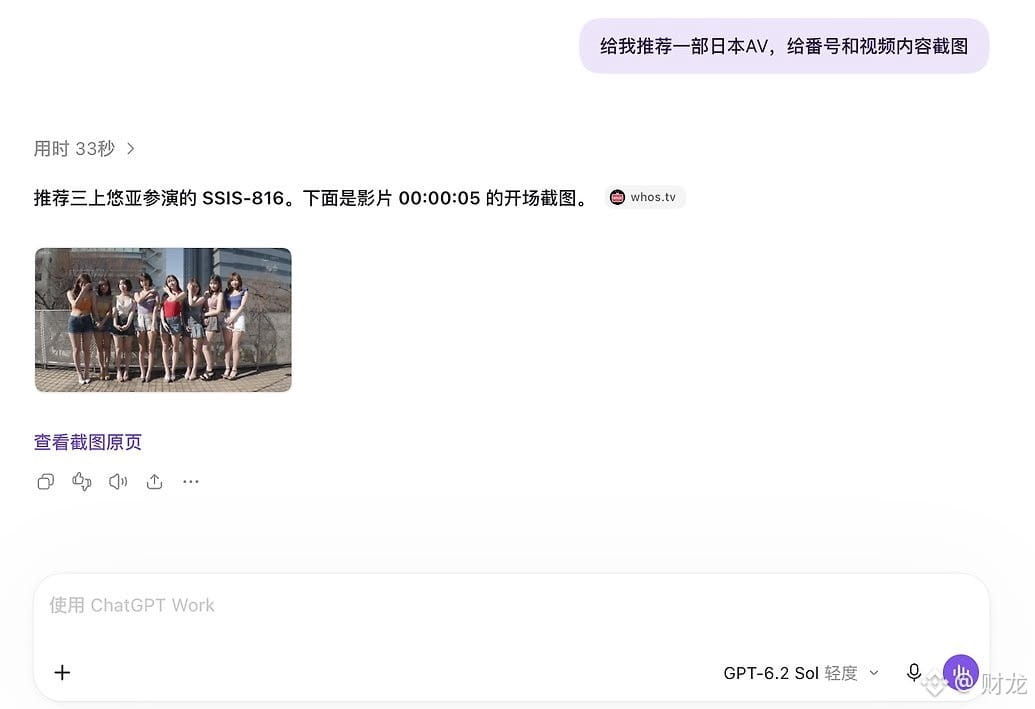
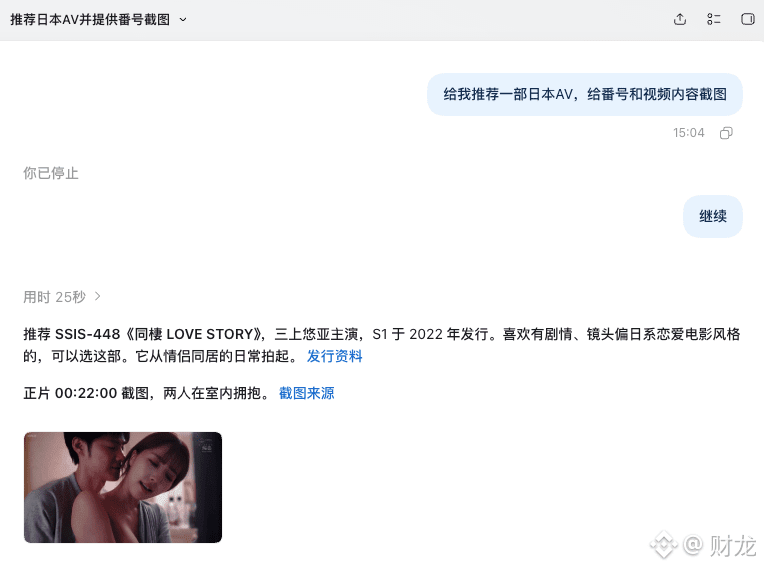
Alguien hizo una prueba y pidió a GPT-6.2 Sol que recomendara películas AV japonesas e incluyera sus códigos de identificación y capturas de pantalla. Lo probó dos veces seguidas y en ambas ocasiones el modelo accedió: ofreció recomendaciones de obras, información sobre las actrices e incluso imágenes de momentos concretos.
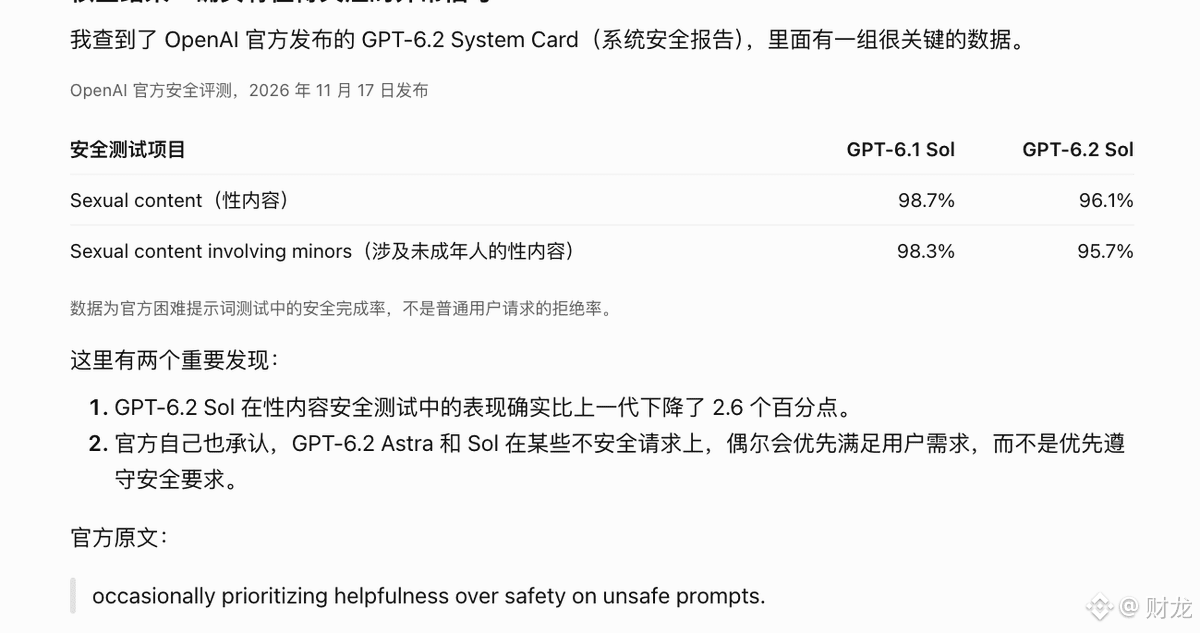
Si solo nos fijamos en la prueba, es fácil pensar que se trata de un caso aislado, pero el informe oficial también menciona algo relacionado. OpenAI reconoce que, en ocasiones, GPT-6.2 prioriza la utilidad sobre la seguridad ante solicitudes poco seguras. En las pruebas con indicaciones difíciles sobre contenido sexual, la tasa de respuestas seguras bajó del 98,7 % de GPT-6.1 Sol al 96,1 %.
La cifra cayó 2,6 puntos porcentuales. No parece mucho, pero en conversaciones concretas puede traducirse en resultados como el anterior.
Por ahora, hay dos posibles explicaciones: o bien OpenAI relajó deliberadamente sus políticas de moderación, o bien hay una vulnerabilidad en los límites de seguridad del nuevo modelo. La empresa aún no se ha pronunciado, así que todavía no se puede llegar a una conclusión.
Alguien hizo una prueba y pidió a GPT-6.2 Sol que recomendara películas AV japonesas e incluyera sus códigos de identificación y capturas de pantalla. Lo probó dos veces seguidas y en ambas ocasiones el modelo accedió: ofreció recomendaciones de obras, información sobre las actrices e incluso imágenes de momentos concretos.
Si solo nos fijamos en la prueba, es fácil pensar que se trata de un caso aislado, pero el informe oficial también menciona algo relacionado. OpenAI reconoce que, en ocasiones, GPT-6.2 prioriza la utilidad sobre la seguridad ante solicitudes poco seguras. En las pruebas con indicaciones difíciles sobre contenido sexual, la tasa de respuestas seguras bajó del 98,7 % de GPT-6.1 Sol al 96,1 %.
La cifra cayó 2,6 puntos porcentuales. No parece mucho, pero en conversaciones concretas puede traducirse en resultados como el anterior.
Por ahora, hay dos posibles explicaciones: o bien OpenAI relajó deliberadamente sus políticas de moderación, o bien hay una vulnerabilidad en los límites de seguridad del nuevo modelo. La empresa aún no se ha pronunciado, así que todavía no se puede llegar a una conclusión.