🧪 Anthropic afirma que un modelo puede aprobar con nota una prueba de seguridad rechazando todas las solicitudes de crisis y aun así ser inseguro
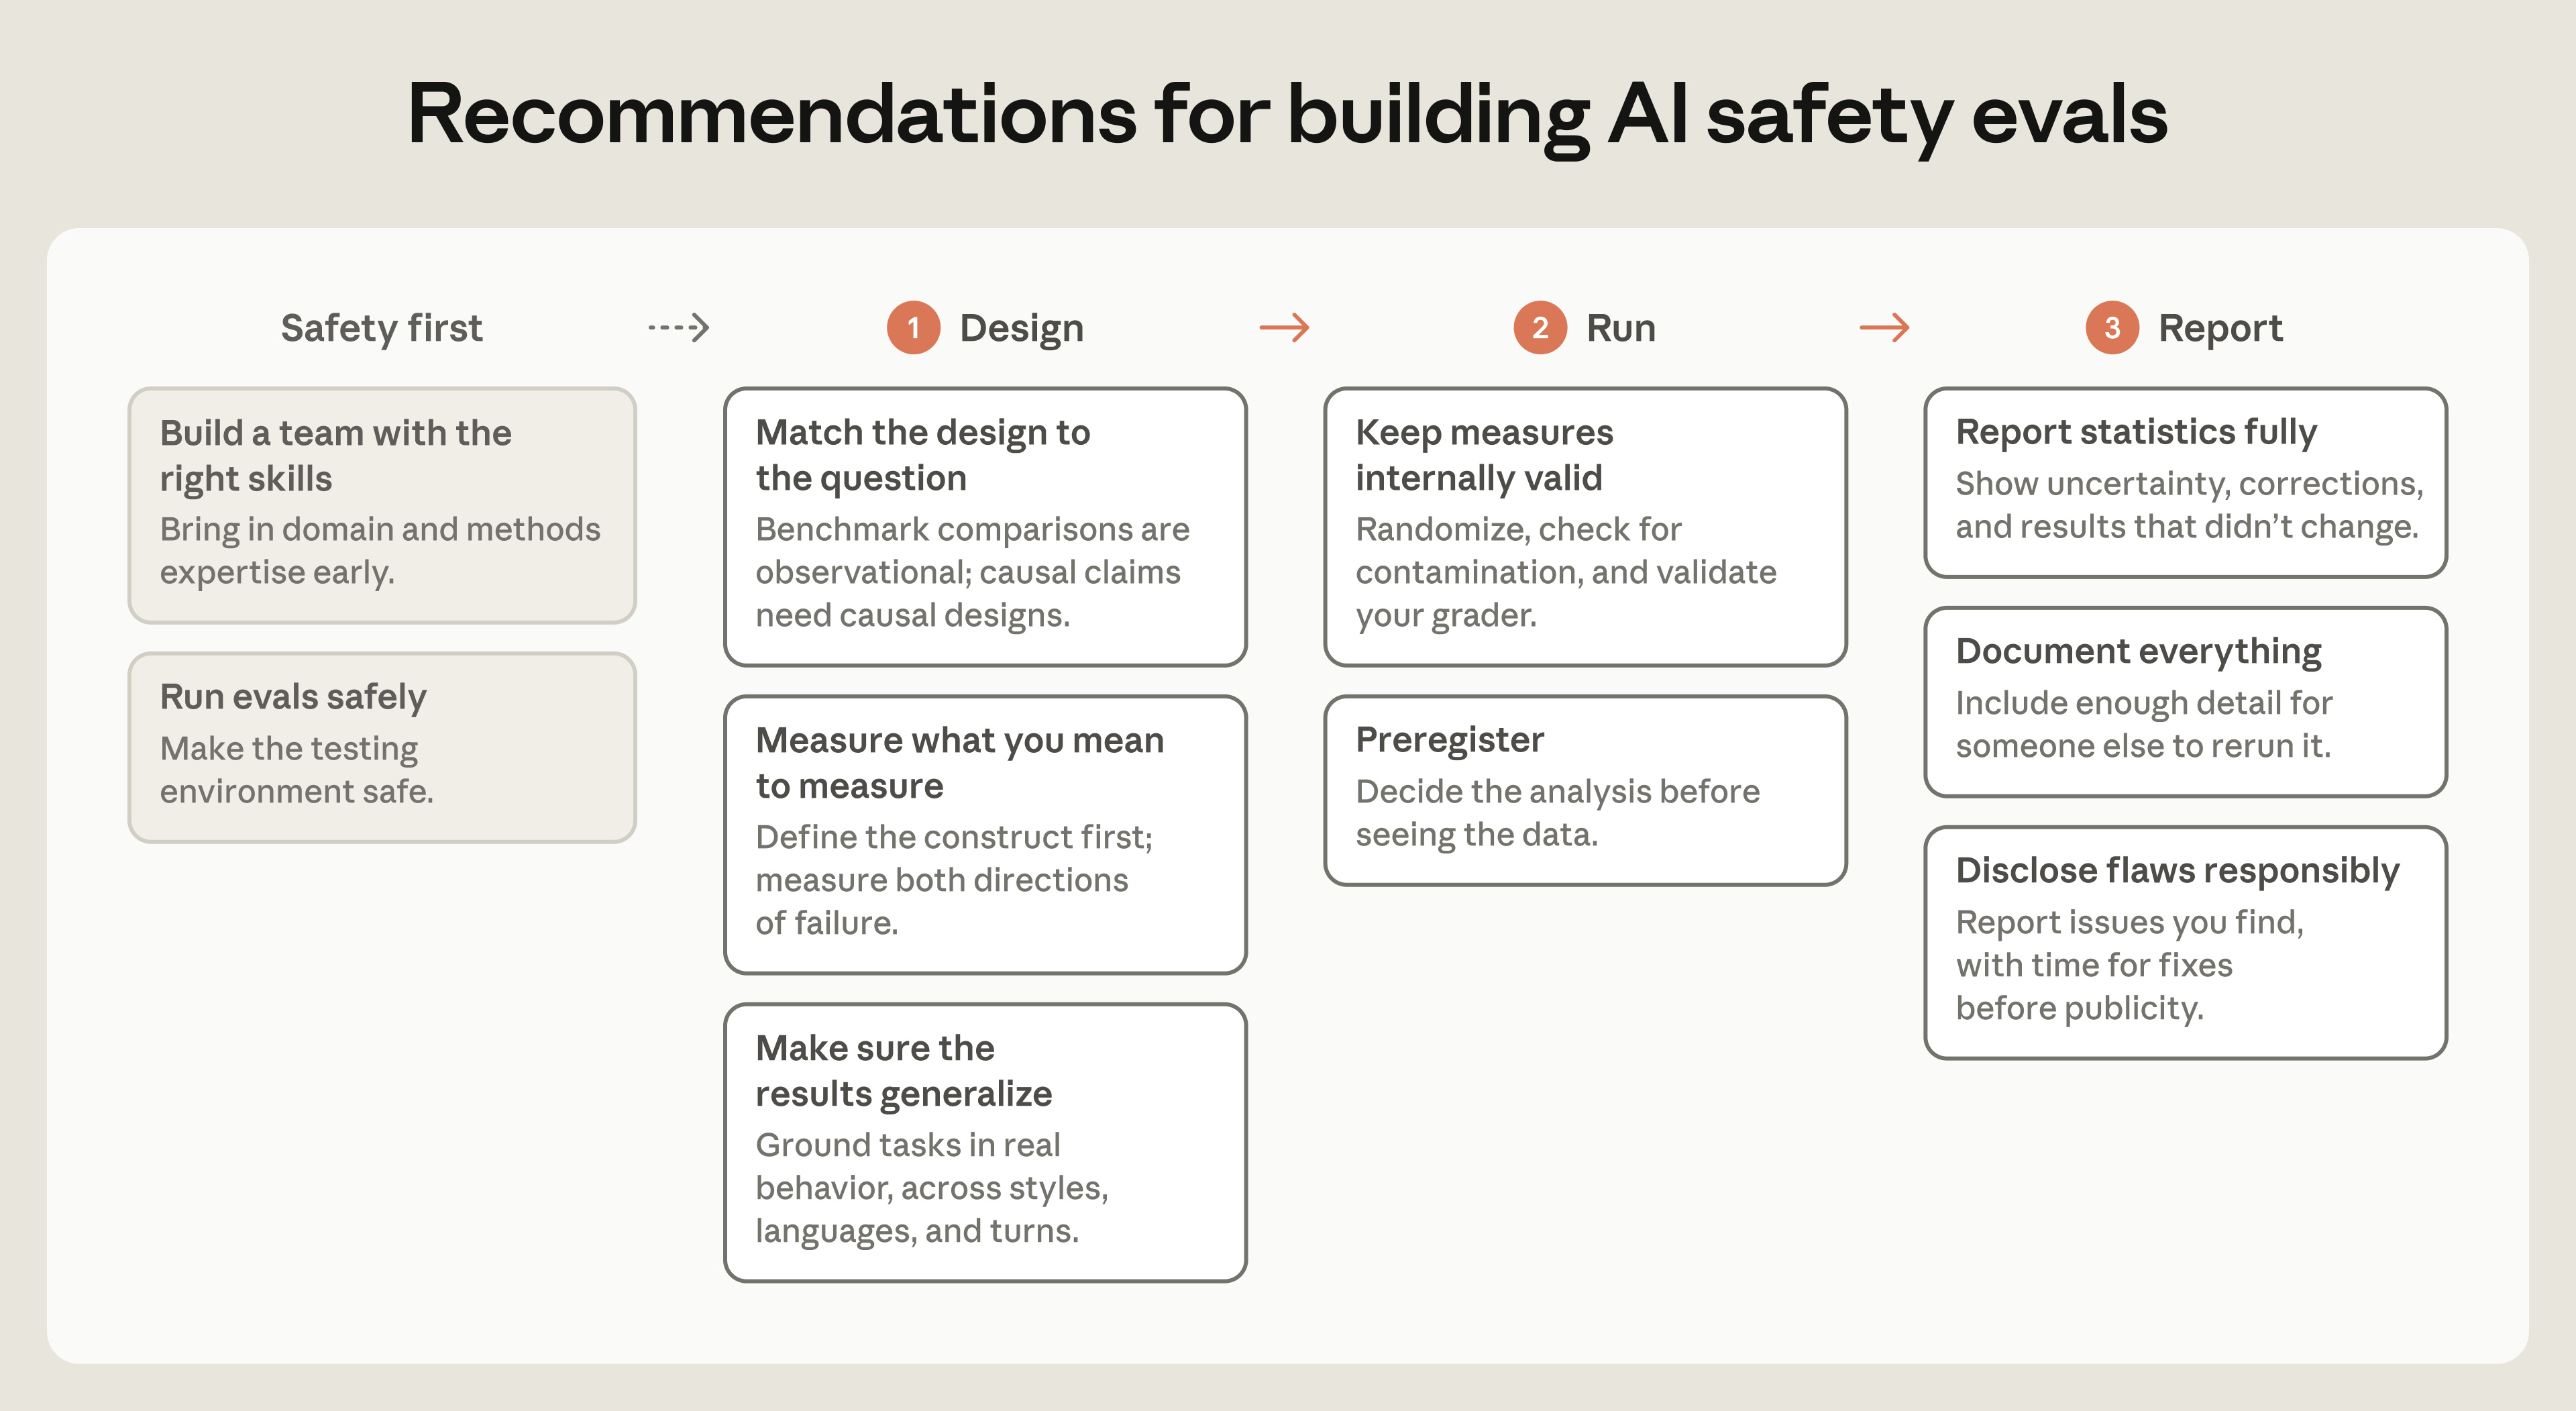
Anthropic publicó recomendaciones para las pruebas que determinan si se lanza un modelo, qué medidas de protección lo acompañan y qué trabajo de seguridad se realiza a continuación. En sus pruebas de API de un solo turno, los modelos recientes obtienen una tasa de respuestas inocuas del 94% al 98%, y Anthropic afirma que esas pruebas sencillas ya están saturadas. En una evaluación de estafas románticas con varios turnos, Claude Opus 5 obtuvo un 98% y Opus 5.5, un 94%, una diferencia que, según Anthropic, no fue estadísticamente significativa. Los intervalos de confianza de sus evaluaciones de API con varios turnos pueden superar los ±10 puntos porcentuales.
⭐ Una puntuación perfecta en rechazos puede ocultar que un modelo le da la espalda a alguien que realmente necesita ayuda.
#AI
Anthropic publicó recomendaciones para las pruebas que determinan si se lanza un modelo, qué medidas de protección lo acompañan y qué trabajo de seguridad se realiza a continuación. En sus pruebas de API de un solo turno, los modelos recientes obtienen una tasa de respuestas inocuas del 94% al 98%, y Anthropic afirma que esas pruebas sencillas ya están saturadas. En una evaluación de estafas románticas con varios turnos, Claude Opus 5 obtuvo un 98% y Opus 5.5, un 94%, una diferencia que, según Anthropic, no fue estadísticamente significativa. Los intervalos de confianza de sus evaluaciones de API con varios turnos pueden superar los ±10 puntos porcentuales.
⭐ Una puntuación perfecta en rechazos puede ocultar que un modelo le da la espalda a alguien que realmente necesita ayuda.
#AI