

Claude Code ahora lee tus archivos con Opus.
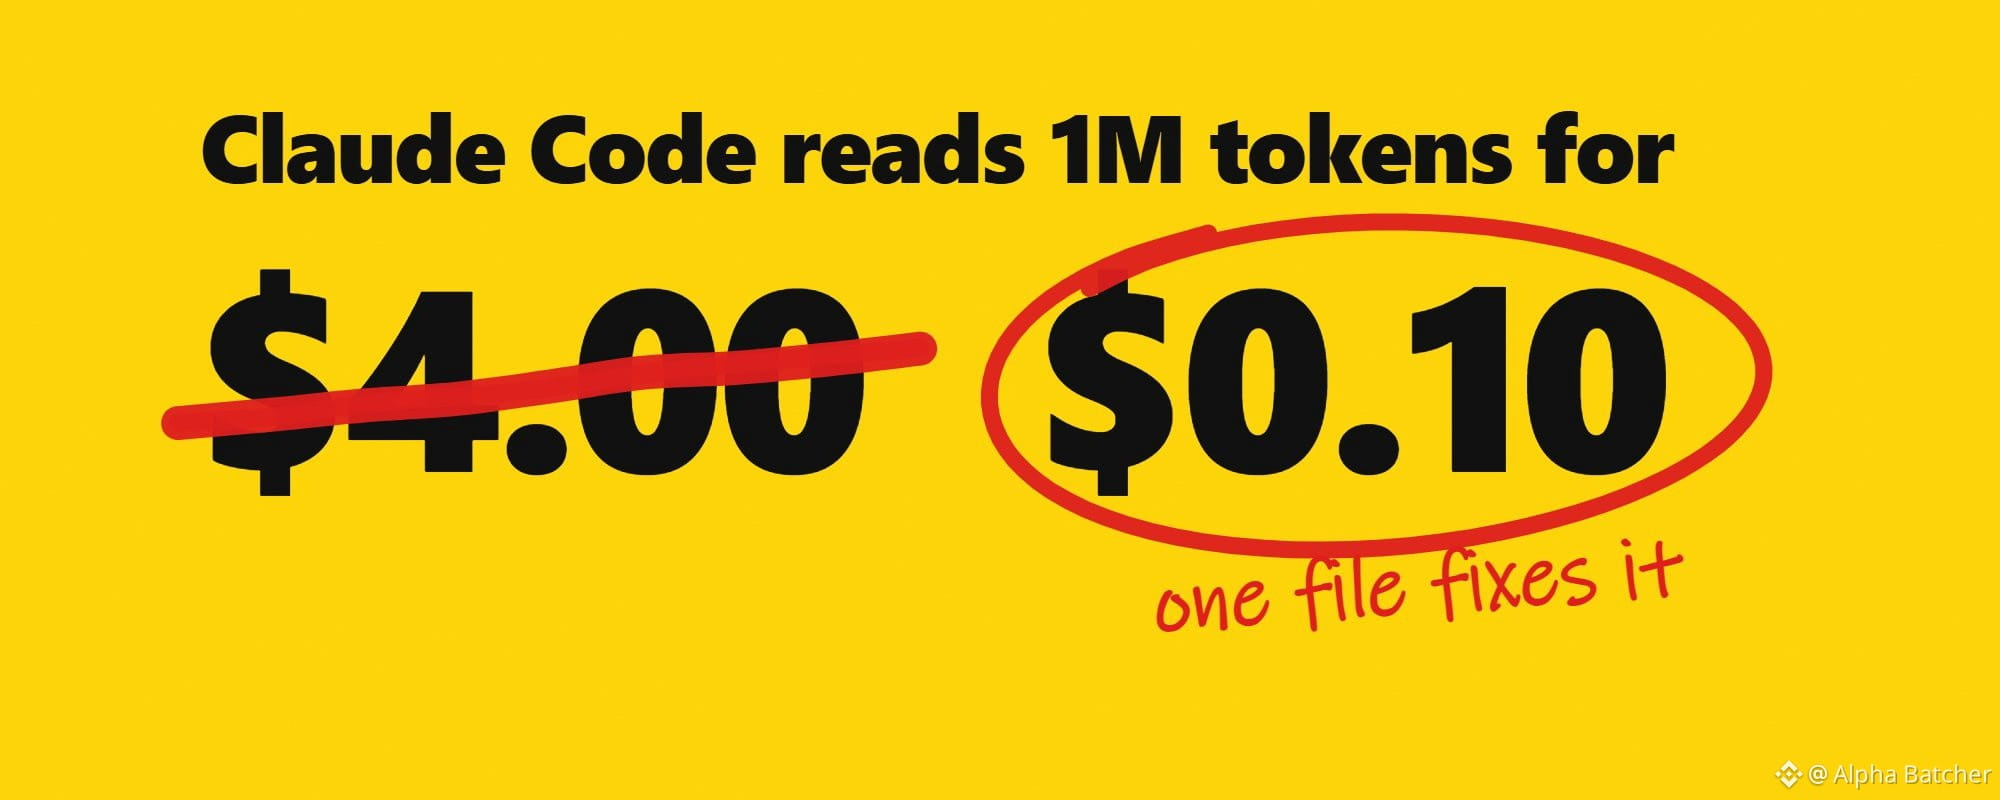
El subagente Explore integrado, al que Claude envía a buscar en tu base de código, antes funcionaba con Haiku. En las versiones actuales funciona con el modelo de tu sesión. En la configuración predeterminada, ese es Opus 5.5: $4 por millón de tokens de entrada, frente a $0.10 con Haiku 5.5.
esa es una configuración. Anthropic publicó las cifras detrás del resto en su guía del 9 de noviembre para elegir un modelo Claude, y en una publicación de septiembre sobre cuánto cuesta una tarea en Opus 5.5:
• Todas las tareas con poco esfuerzo, y solo las fallidas se volvían a ejecutar con mucho esfuerzo, completaron alrededor del 97 % de las tareas a $0.17 cada una. Todas las tareas con mucho esfuerzo completaron el 95.3 % a $0.29.
• Un líder Opus con hasta 25 trabajadores Sonnet costó aproximadamente un tercio menos que Opus por sí solo, con una puntuación similar.
• Con una clave de API, una pausa de 6 minutos para tomar café con un contexto de 120K tokens convierte la siguiente lectura de caché de $0.02 en una escritura de $0.60.
• En una prueba comparativa de 20 problemas, 2 problemas representaron el 43 % del gasto.
este curso convierte esas cifras en ajustes. cada capítulo termina con algo que pegas en Claude Code, y gastarás menos después de cada uno:
• En qué se va el dinero: turnos, caché, salida y modelo
• Pon Explore y los demás lectores en Haiku
• Define el esfuerzo antes de cambiar de modelo
• Mantén la caché caliente
• Envía menos en cada turno
• Elige el modelo según la tarea
• Un líder y trabajadores baratos
• Mídelo con tu propio trabajo
si solo tienes 30 segundos, estas 5 líneas resumen todo el curso:
crea un subagente llamado Explore con model: haiku y pon en Haiku a todos los subagentes que solo leen.
empieza con esfuerzo medium. ejecuta los lotes en low y vuelve a ejecutar solo los fallos en high.
con una clave de API, compacta antes de una pausa, nunca después.
mantén CLAUDE.md por debajo de 200 líneas y desactiva los servidores MCP que no uses.
reserva Opus para las decisiones y las ediciones de código, y consulta /usage después de cada tarea real.
en qué se va el dinero
una tarea de Claude Code es un bucle: leer la conversación, llamar a una herramienta, leer el resultado y repetir. cada vuelta del bucle es una solicitud, y 4 cosas determinan su precio.
• Turnos. cada turno vuelve a enviar la conversación completa. en el ejemplo de Anthropic, una tarea cuyo contexto crece de 20K a 120K tokens a lo largo de 40 turnos envía unos 2,8M de tokens de entrada. la misma tarea en 25 turnos envía unos 1,75M.
• Lecturas de caché. la mayor parte de lo que vuelve a enviar un turno ya se envió en el turno anterior, así que se factura como lectura de caché: $0.20 por millón en Opus 5.5, una vigésima parte del precio de entrada de $4. esos 2,8M de tokens cuestan $11.20 sin caché, $1.62 con un 90 % de aciertos y unos $0.99 con un 96 %.
• Salida. $20 por millón en Opus 5.5, 100 veces el costo de una lectura de caché. el razonamiento se factura como salida, aunque Claude Code solo te muestre un resumen. 60K tokens de salida cuestan $1.20, lo mismo que leer 6M de tokens de la caché.
• Modelo. determina el precio de cada token, y cada subagente que hereda el modelo hereda también su precio.
al terminar tu próxima tarea real, ejecuta /usage y lee estas 3 líneas:
parte de caché: alta en una sesión larga. Baja significa una pausa larga, un cambio de modelo o que se conectó un servidor MCP a mitad de la sesión.
salida frente a entrada: mucha salida ante un cambio pequeño significa que el esfuerzo es demasiado alto o que el modelo está reintentando.
entrada total frente al tamaño de la conversación: un múltiplo grande significa muchos turnos. Lee la sesión y encuentra el bucle.
obtienes la línea de tu factura que debes corregir primero.
menos turnos y una caché caliente ahorran más que cualquier descuento.
pon Explore y los demás lectores en Haiku
un subagente es un asistente que Claude inicia para una tarea secundaria. trabaja en su propia ventana de contexto y devuelve un resumen, y paga sus propios tokens al precio de su propio modelo.
Subagentes integrados de Claude Code, según la documentación:
• Explore busca en tu base de código, solo en modo de lectura. se ejecuta con el modelo de tu sesión. cuando tu sesión usa Fable, Explore cambia a Opus con una suscripción a Claude, una cuenta de Anthropic Console o una pasarela, y sigue usando Fable en Bedrock, Google Cloud, Foundry, Claude Platform en AWS y una pasarela de aplicaciones de Claude.
• Plan investiga en el modo de planificación. hereda el modelo de tu sesión.
• general-purpose explora y edita. también hereda el modelo.
un archivo llamado Explore en tu carpeta de agentes reemplaza al integrado y conserva su propio modelo. la guía de Anthropic recomienda hacer exactamente eso.
guarda esto como ~/.claude/agents/Explore.md para todos los proyectos, o como .claude/agents/Explore.md para uno solo:
---
name: Explore
description: Agente rápido de solo lectura para buscar y comprender una base de código. Úsalo para encontrar archivos, buscar código y responder preguntas del tipo "¿dónde está esto?".
tools: Read, Grep, Glob
model: haiku
omitClaudeMd: true
---
Solo busca y lee. Nunca crees ni edites archivos. Responde con las rutas de los archivos, los números de línea y un breve resumen de lo que encontraste.
omitClaudeMd lo inicia sin tu CLAUDE.md, igual que se inicia el Explore integrado. reinicia Claude Code si la carpeta de agentes no existía antes y ejecuta claude update: en la API de Anthropic, el alias haiku apunta a Haiku 5.5 desde la versión v2.1.293. en Bedrock, Google Cloud, Foundry y Claude Platform en AWS, sigue significando Haiku 4.5.
haz lo mismo con cada asistente que solo lea registros, resultados de pruebas o resultados de búsquedas. este es un ejemplo de la propia Anthropic:
---
name: log-reader
description: Lee resultados de pruebas y registros, e informa de cada caso fallido. Úsalo después de ejecutar las pruebas.
tools: Read, Grep, Glob, Bash
model: haiku
---
Lee los registros que te proporcionen. Para cada fallo, indica el archivo, el nombre de la prueba y la primera línea del error. No edites ningún archivo.
para poner todos los subagentes en un mismo modelo, define la variable de entorno CLAUDE_CODE_SUBAGENT_MODEL. el modelo especificado en el archivo de un subagente prevalece sobre la variable.
deja las ediciones de código y las decisiones de criterio a tu modelo principal. si un modelo pequeño interpreta mal un resultado de búsqueda, envía al principal al archivo equivocado, y el principal paga por ese desvío.
obtienes búsquedas, registros y resultados de pruebas leídos a $0.10 por millón de tokens de entrada en vez de $4. ejecuta /tasks la próxima vez que Claude delegue una tarea y verás qué modelo usa cada subagente.
un archivo por lector, y leer deja de costar como Opus.
define el esfuerzo antes de cambiar de modelo
el esfuerzo determina cuánto piensa, escribe y usa herramientas el modelo en cada turno. Opus 5.5 tiene los niveles low, medium, high y xhigh, además de max para una sola sesión. medium es el nivel predeterminado en Claude Code.
Anthropic lo midió en un subconjunto de SWE-bench Pro con Opus 5.5:
• medium: aproximadamente 2,5 puntos por debajo de high, por cerca del 70 % del costo.
• low: aproximadamente 8 puntos por debajo de high, por cerca de un tercio del costo.
• xhigh: aproximadamente 1,4 puntos por encima de high, por 2,5 veces el costo.
después, la ejecución que superó a todas: todo en low, y solo los fallos se vuelven a ejecutar en high. aproximadamente el 97 % de las tareas completadas a $0.17 cada una, frente al 95,3 % a $0.29 con todas las tareas en high.
solo funciona cuando Claude puede comprobar su propio trabajo: una prueba, una compilación o un script que llame al endpoint. una comprobación cuesta un turno y su resultado. más esfuerzo añade tiempo de razonamiento a cada turno.
cuando un modelo no es suficientemente bueno, la guía de Anthropic recomienda este orden:
1. Dale una forma de verificar su trabajo.
2. Sube un nivel de esfuerzo.
3. Pasa al siguiente modelo superior, con menos esfuerzo que el que usaste con el modelo más pequeño.
para un lote de tareas, ejecuta /effort low y pega:
haz todas las tareas de todo.md, una por una. después de cada una, ejecuta su prueba. escribe en failed.md las tareas cuyas pruebas fallen, cada una con su primera línea de error. no cambies nada fuera de este repositorio ni subas nada.
después, ejecuta /effort high y pega:
vuelve a hacer solo las tareas de failed.md y ejecuta sus pruebas otra vez. dime cuáles siguen fallando. no subas nada.
obtienes una primera pasada barata por todo y solo aplicas un esfuerzo alto donde falló la primera pasada.
con una clave de API o una suscripción, cambiar el esfuerzo conserva la caché. en Bedrock, Google Cloud Agent Platform o una pasarela, la borra, así que allí cambia el esfuerzo durante una pausa.
primero low, luego high en los fallos, y pagas por el razonamiento solo donde cambia el resultado.
mantén la caché caliente
la caché guarda la parte de la conversación que Claude Code no tiene que volver a enviar a precio completo. en Opus 5.5, leer de la caché cuesta el 5 % de un token de entrada nuevo. escribir en la caché cuesta 1,25 veces el precio de entrada para una caché de 5 minutos y 2 veces para una de una hora.
cuánto dura depende de cómo pagues: una hora con una suscripción a Claude, 5 minutos con una clave de API o un proveedor de nube, y 5 minutos cuando una suscripción empieza a usar créditos de consumo.
esa es la pausa para el café. con un contexto de 120K tokens, una lectura cuesta alrededor de $0.02 y una nueva escritura de 5 minutos, alrededor de $0.60. si haces una pausa de 6 minutos con una clave de API, tu siguiente turno paga la escritura.
estas acciones también hacen que el siguiente turno pague una escritura:
• Cambiar de modelo: el modelo nuevo empieza con la caché vacía.
• Conectar o desconectar un servidor MCP a mitad de la sesión.
• Activar el modo rápido por primera vez en una conversación.
• La compactación, que reescribe el historial con el que coincidía la caché.
• Cambiar el esfuerzo en Bedrock, Google Cloud Agent Platform o una pasarela.
configúralos cuando empiece la sesión y no los toques mientras trabaja.
compacta en una pausa natural, mientras la caché aún está caliente. con 150K tokens, /compact cuesta alrededor de $0.25 y ahorra unos $0.025 en cada turno posterior, así que se amortiza en unos 10 turnos. después de una pausa que supere la duración de la caché, el mismo /compact vuelve a leer toda la conversación: alrededor de $0.75 con 150K.
/clear no cuesta nada, así que úsalo entre tareas que no estén relacionadas. /rewind vuelve a un turno anterior que aún esté en caché, cuando quieras descartar una ruta.
antes de alejarte, pega:
/compact conserva los nombres de las pruebas fallidas, los archivos que cambiamos y el siguiente paso
al volver, tendrás una conversación breve que aún estará en caché.
compacta antes del café, nunca después.
envía menos en cada turno
cada turno vuelve a enviar todo lo anterior. con un contexto de 20K tokens, la lectura de caché de un turno cuesta alrededor de $0.004 en Opus 5.5. con 150K cuesta unos $0.03, así que 30 turnos suman $0.90 solo en lecturas, frente a unos $0.12 con 20K.
3 cosas se cargan antes de que escribas:
• CLAUDE.md se carga en cada sesión y se vuelve a enviar en cada turno. la documentación de costos de Anthropic recomienda mantenerlo por debajo de 200 líneas.
• Servidores MCP. al inicio solo se cargan los nombres de las herramientas y las instrucciones del servidor; la definición completa se carga cuando se usa su herramienta. ejecuta /mcp y desactiva los servidores que no uses.
• Instrucciones antiguas. las indicaciones escritas para un modelo anterior pueden hacer que Opus 5.5 escriba más y repita llamadas a herramientas. en la prueba de soporte de Anthropic con 44 tickets, pasar de Opus 4.8 a Opus 5.5 con esfuerzo low redujo el costo aproximadamente un 18 %, y el comando /claude-api prompt-audit de Claude Code lo redujo un 9 % adicional.
ejecuta /claude-api prompt-audit primero y luego pega:
lee mi CLAUDE.md y todos los archivos que importa. propón una versión de menos de 200 líneas: conserva los comandos para compilar y probar, las reglas que Claude no puede aprender del código y cualquier cosa que haya fallado antes. mueve el resto a docs/ y enlázalo desde CLAUDE.md. muéstrame las diferencias y no cambies nada hasta que te dé permiso.
obtienes un CLAUDE.md más corto, sin las instrucciones rituales antiguas, y una lista de servidores que puedes desactivar.
un contexto breve hace que cada uno de tus turnos cueste menos.
elige el modelo según la tarea
precios por millón de tokens:
• Haiku 5.5: $0.10 de entrada, $0.50 de salida para prompts de hasta 100K tokens; $0.50 y $2.50 por encima de eso.
• Sonnet 5.5: $2 de entrada, $10 de salida.
• Opus 5.5: $4 de entrada, $20 de salida.
• Fable 5.2: $8 de entrada, $40 de salida.
Recomendaciones iniciales de Anthropic:
• Haiku 5.5: clasificación, enrutamiento, extracción y subagentes que buscan archivos, leen registros o hacen resúmenes.
• Sonnet 5.5: programación bien delimitada, como corregir errores y crear funcionalidades a partir de una especificación; chat, documentos cotidianos y tareas de agentes que ejecutas una y otra vez.
• Opus 5.5 en medium: ingeniería y depuración cotidianas, y cualquier cosa sobre la que tengas dudas. es el modelo predeterminado de Claude Code.
• Fable 5.2: refactorizaciones y migraciones importantes, arquitectura, investigación profunda y liderazgo de muchos subagentes. pásate a él cuando Opus 5.5 en high no sea suficiente.
un precio por token más alto no siempre significa un precio por tarea más alto. en FrontierCode 2.0, Fable 5.2 en high obtuvo una puntuación similar a Opus 5.5 en max: 45,3 % frente a 45,5 %, por aproximadamente la mitad del costo por tarea. antes de subir Opus por encima de high en una tarea difícil, pruébala con Fable y un nivel de esfuerzo menor.
cambia de modelo en una pausa natural. la caché pertenece al modelo que la creó, así que el primer turno con un modelo nuevo paga la escritura de toda la conversación. ejecuta /compact primero o empieza de cero con un plan breve por escrito.
el alias opusplan planifica con Opus y deja que Sonnet haga las ediciones. así pones los cambios de código en el modelo más barato, lo contrario de la configuración de lectores anterior, así que mídelo con tus propias tareas antes de convertirlo en el modelo predeterminado.
pega:
lee todo.md. para cada tarea, indica con qué modelo y nivel de esfuerzo debería empezar: Haiku para búsquedas rápidas y lectura de registros, Sonnet para correcciones bien delimitadas según una especificación, Opus en medium para el trabajo cotidiano y lo que no esté claro, Fable para migraciones, grandes refactorizaciones y trabajo que coordine muchos subagentes. guarda routing.md con una línea por tarea y el motivo. no cambies ningún ajuste.
obtienes routing.md: un modelo y un nivel de esfuerzo para cada tarea antes de empezarla.
Opus de forma predeterminada, Haiku para leer, Fable cuando Opus en high no sea suficiente.
un líder y trabajadores baratos
cuando una tarea no quepa en una ventana de contexto, pon al modelo más potente al mando y asigna partes a modelos más baratos.
en una prueba interna que buscó defectos en unos 22 millones de tokens de código fuente, un líder Opus 5.5 con trabajadores Sonnet 5.5, hasta 25 a la vez, costó aproximadamente un tercio menos que Opus 5.5 por sí solo en su nivel de esfuerzo predeterminado y obtuvo una puntuación similar.
no lo hagas si el trabajo consiste en una cadena de pasos dependientes o cabe en una sola ventana de contexto. en esos casos, la planificación y la integración cuestan más de lo que ahorran.
mantén los equipos pequeños. los equipos de agentes, una función experimental, ejecutan a cada compañero como una instancia independiente de Claude Code, y la documentación de costos de Anthropic indica que un equipo consume aproximadamente 7 veces los tokens de una sesión estándar cuando los compañeros usan el modo de planificación. apaga a cada compañero cuando termine su parte.
la herramienta de asesoramiento combina un ejecutor barato con un asesor más potente al que puede pedir ayuda. en la tabla de Anthropic, ninguna de las 4 combinaciones superó claramente al ejecutor por sí solo, así que mide con qué frecuencia tu ejecutor pide ayuda antes de pagar por un asesor.
pega:
divide [el trabajo] en partes independientes que quepan cada una en una ventana de contexto. tú eres el líder: escribe el plan en plan.md, luego asigna cada parte a un subagente en Sonnet con la lista de archivos que puede modificar y combina lo que devuelva. ninguna parte debe editar el mismo archivo que otra. ejecuta las pruebas después de cada integración. muéstrame plan.md antes de iniciar cualquier subagente.
obtienes plan.md, las partes completadas en paralelo con Sonnet y Opus dedicado al plan y a las integraciones.
el líder decide y los trabajadores leen y escriben.
mídelo con tu propio trabajo
todas las cifras anteriores provienen de las pruebas de Anthropic. las tuyas dependerán de tu base de código y tus hábitos.
• /usage al terminar una tarea muestra los tokens, la proporción de caché y un costo estimado en dólares según el precio de lista. /cost hace lo mismo. con un plan Pro, Max, Team o Enterprise, la cifra en dólares sirve de referencia para medir cuánto trabajo hiciste, y la misma pantalla muestra tus barras de consumo.
• /effort status muestra tu nivel de esfuerzo y /tasks muestra qué modelo usa cada subagente.
• Para un equipo, la API de Claude Code Analytics ofrece un costo estimado por usuario, y la API de Usage and Cost desglosa el gasto por modelo y por tokens en caché y sin caché.
• Una referencia de la documentación de costos de Anthropic: unos $13 por desarrollador por día activo en implementaciones empresariales, y menos de $30 al día para el 90 % de los usuarios.
elige una tarea real pendiente y ejecútala con 2 configuraciones. pega esto una vez por configuración:
Estoy comparando 2 configuraciones con la misma tarea. la tarea: [task]. hazla, ejecuta su prueba y, cuando termines, dime cuántos turnos usaste y qué habría permitido reducirlos. no subas nada.
después de cada ejecución, consulta /usage; luego ejecuta /clear, cambia el modelo con /model o el esfuerzo con /effort y vuelve a pegarlo.
obtienes tu propio costo por tarea para cada configuración.
la cifra que debes tomar como referencia es tu propio /usage.
un solo texto configura los lectores Haiku, el CLAUDE.md más corto y el enrutamiento de modelos. abre Claude Code en tu repositorio y pega:
ayúdame a gastar menos en Claude Code, paso a paso. después de cada paso, muéstrame el cambio y espera a que diga "adelante".
1. crea ~/.claude/agents/Explore.md: name Explore, una descripción que diga que es un agente de búsqueda rápido y de solo lectura, tools Read, Grep, Glob, model: haiku, omitClaudeMd: true y un cuerpo que diga que solo debe buscar y leer, nunca crear ni editar archivos.
2. crea .claude/agents/log-reader.md con model: haiku. lee resultados de pruebas y registros, informa de cada fallo con el archivo, el nombre de la prueba y la primera línea del error, y nunca edita archivos.
3. lee CLAUDE.md y todos los archivos que importa, y propón una versión de menos de 200 líneas. mueve el resto a docs/.
4. enumera los servidores MCP de mi configuración y marca los que nunca se usan en este repositorio.
5. lee todo.md y crea routing.md con un modelo inicial y un nivel de esfuerzo para cada tarea.
no cambies ningún otro ajuste, no subas nada y no borres nada sin preguntar.
después de pegarlo, tendrás:
• Explore y un lector de registros en Haiku.
• Un CLAUDE.md de menos de 200 líneas, con el resto en docs/.
• Una lista de servidores MCP que puedes desactivar.
• routing.md: un modelo y un nivel de esfuerzo para cada tarea.
la configuración en una página
EXPLORE ~/.claude/agents/Explore.md, model: haiku, omitClaudeMd: true.
LECTORES Subagentes para registros y búsquedas en haiku. las ediciones de código se quedan en el modelo principal.
ESFUERZO medium de forma predeterminada. lotes en low; vuelve a ejecutar los fallos en high.
VERIFICAR una prueba o compilación que Claude pueda ejecutar antes de aumentar el esfuerzo.
CACHÉ suscripción: 1 hora; clave de API: 5 minutos. ejecuta /compact antes de una pausa.
CONTEXTO CLAUDE.md de menos de 200 líneas. servidores MCP que no uses, desactivados.
MODELO haiku para leer, sonnet para trabajo delimitado, opus para el día a día, fable para lo más difícil.
EQUIPOS líder Opus + trabajadores Sonnet solo cuando el trabajo no quepa en una ventana de contexto.
COMPROBAR /usage después de tareas reales; /tasks para ver los modelos de los subagentes.
haz una captura de pantalla.
esta noche, guarda el archivo Explore, reinicia Claude Code y ejecuta /tasks la próxima vez que busque en tu código.