@SpaceandTime La IA empezó a comprar datos por su cuenta, pero ni siquiera sabe cuándo se equivoca al calcular
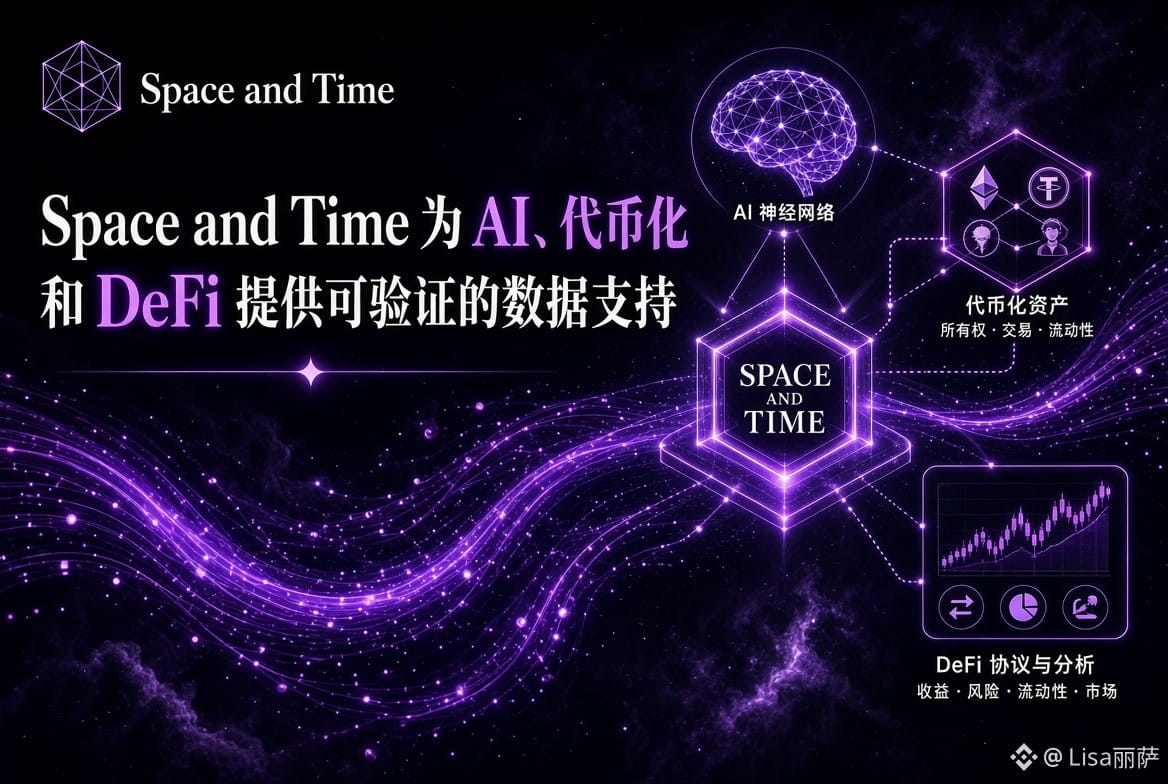
Estos últimos días conecté un agente de consulta de datos a un entorno de demostración y lo puse a responder decenas de preguntas. Lo más preocupante no fue que se equivocara, sino que cuando se equivocaba hablaba exactamente con el mismo tono que cuando acertaba. La versión Enterprise que Space and Time lanzó el 9 de noviembre dio justo en el blanco de este problema. La lógica es sencilla: los cálculos se ejecutan sobre datos privados, se genera un comprobante criptográfico de Proof of SQL y, antes de pasarle el resultado al agente, la aplicación verifica ese comprobante. Solo después de validarlo deja que el agente actúe. Los datos no salen de la base y el proceso de cálculo se puede verificar. Esta idea se vuelve muy valiosa cuando los agentes empiezan a llamar API por su cuenta.
La ruta que probé fue subir primero una tabla de negocio, enviar consultas con el SDK y obtener los resultados junto con las pruebas, para luego verificarlas en un contrato en cadena. La primera vez tardé más o menos una tarde en hacerlo funcionar. El obstáculo no fue la criptografía, sino la configuración del entorno y tener que pensar de antemano qué tabla merecía ser verificable. Esta barrera existe de verdad, pero a cambio ofrece algo muy sólido: que la corrección de un resultado ya no dependa de en quién confías.
Comparado con soluciones de oráculos de precios como Chainlink, que te dicen cuánto vale ahora una cifra, SXT te dice con qué criterio y a partir de qué tabla se calculó. Frente a paneles de solo lectura como Dune, la diferencia es que estos últimos solo pueden darte una captura de pantalla, mientras que el primero puede darte un comprobante. Si la IA toma decisiones a partir de capturas de pantalla, es solo cuestión de tiempo que algo salga mal.
Hay otro efecto secundario que no había previsto al principio. Con las pruebas, se puede reproducir cada decisión del agente. Si surge un problema, es posible identificar qué consulta usó qué datos concretos. Determinar responsabilidades es más sencillo que revisar los registros, aunque también más caro. Por eso no me importa demasiado lo llamativo que sea el relato que cuenta ahora. Lo que me importa es quién podrá cobrar un peaje en el nivel de los comprobantes cuando los agentes empiecen de verdad a llamar API y a gastar dinero en comprar datos.#sxt $SXT
Estos últimos días conecté un agente de consulta de datos a un entorno de demostración y lo puse a responder decenas de preguntas. Lo más preocupante no fue que se equivocara, sino que cuando se equivocaba hablaba exactamente con el mismo tono que cuando acertaba. La versión Enterprise que Space and Time lanzó el 9 de noviembre dio justo en el blanco de este problema. La lógica es sencilla: los cálculos se ejecutan sobre datos privados, se genera un comprobante criptográfico de Proof of SQL y, antes de pasarle el resultado al agente, la aplicación verifica ese comprobante. Solo después de validarlo deja que el agente actúe. Los datos no salen de la base y el proceso de cálculo se puede verificar. Esta idea se vuelve muy valiosa cuando los agentes empiezan a llamar API por su cuenta.
La ruta que probé fue subir primero una tabla de negocio, enviar consultas con el SDK y obtener los resultados junto con las pruebas, para luego verificarlas en un contrato en cadena. La primera vez tardé más o menos una tarde en hacerlo funcionar. El obstáculo no fue la criptografía, sino la configuración del entorno y tener que pensar de antemano qué tabla merecía ser verificable. Esta barrera existe de verdad, pero a cambio ofrece algo muy sólido: que la corrección de un resultado ya no dependa de en quién confías.
Comparado con soluciones de oráculos de precios como Chainlink, que te dicen cuánto vale ahora una cifra, SXT te dice con qué criterio y a partir de qué tabla se calculó. Frente a paneles de solo lectura como Dune, la diferencia es que estos últimos solo pueden darte una captura de pantalla, mientras que el primero puede darte un comprobante. Si la IA toma decisiones a partir de capturas de pantalla, es solo cuestión de tiempo que algo salga mal.
Hay otro efecto secundario que no había previsto al principio. Con las pruebas, se puede reproducir cada decisión del agente. Si surge un problema, es posible identificar qué consulta usó qué datos concretos. Determinar responsabilidades es más sencillo que revisar los registros, aunque también más caro. Por eso no me importa demasiado lo llamativo que sea el relato que cuenta ahora. Lo que me importa es quién podrá cobrar un peaje en el nivel de los comprobantes cuando los agentes empiecen de verdad a llamar API y a gastar dinero en comprar datos.#sxt $SXT