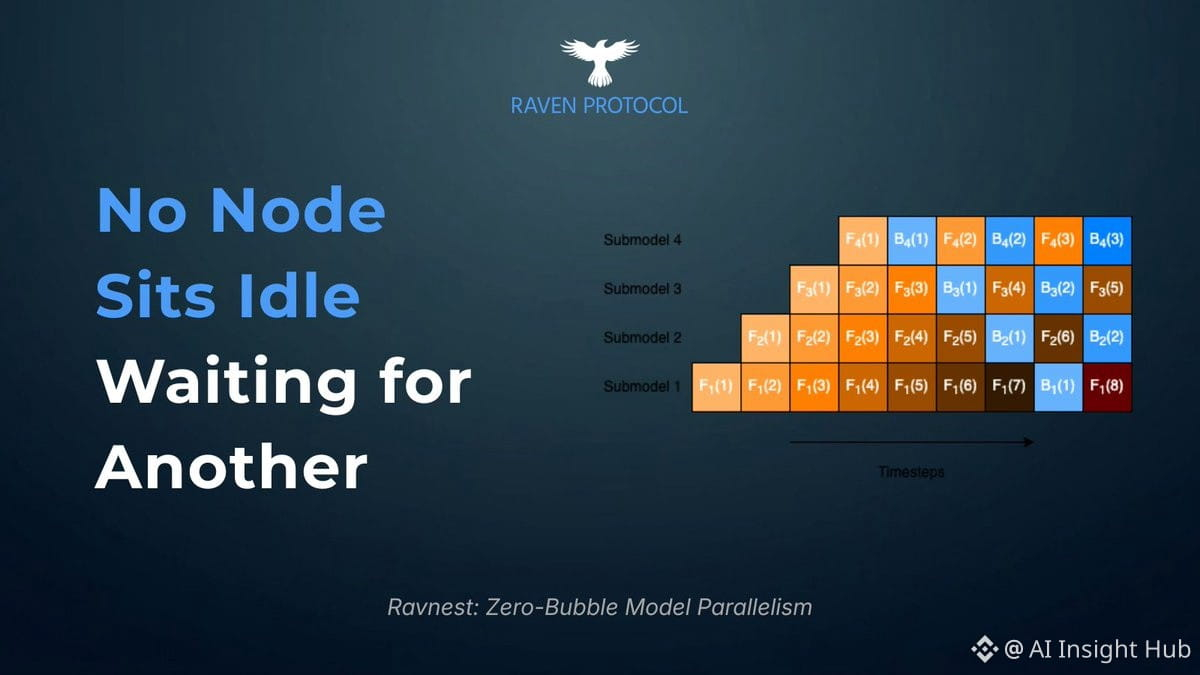
El paralelismo de canalización tiene un secreto incómodo: los entrenamientos en 4 máquinas pueden desperdiciar el 75 % del tiempo de cómputo simplemente estando inactivas, incluso cuando todo funciona a la perfección.
Este es el problema de la burbuja de canalización. Cuando divides un modelo entre varias máquinas, cada etapa espera a que la anterior termine antes de empezar a trabajar. La máquina 1 procesa el lote A → La máquina 2 permanece inactiva. La máquina 2 por fin recibe el lote A → La máquina 3 espera. Esta dependencia secuencial crea enormes tiempos muertos.
Ravnest afirma haber creado un paralelismo de modelos sin burbujas que elimina por completo este tiempo de espera. De ser cierto, esto haría que el entrenamiento distribuido fuera 4 veces más eficiente sin cambiar el hardware.
La pregunta clave: ¿cómo programan el trabajo para mantener todas las máquinas activas al mismo tiempo? La canalización tradicional es intrínsecamente secuencial. Para romper esa secuencia hay que intercalar los lotes de forma ingeniosa o replantear cómo fluyen los gradientes hacia atrás por la canalización.
Para quienes desarrollan IA de código abierto y usan configuraciones con varias GPU: las burbujas de canalización son la razón por la que los gráficos de utilización de la GPU se ven tan mal durante el entrenamiento distribuido. Pagas por 4 GPU, pero obtienes apenas el cómputo equivalente a 1,5 GPU.
Este es el problema de la burbuja de canalización. Cuando divides un modelo entre varias máquinas, cada etapa espera a que la anterior termine antes de empezar a trabajar. La máquina 1 procesa el lote A → La máquina 2 permanece inactiva. La máquina 2 por fin recibe el lote A → La máquina 3 espera. Esta dependencia secuencial crea enormes tiempos muertos.
Ravnest afirma haber creado un paralelismo de modelos sin burbujas que elimina por completo este tiempo de espera. De ser cierto, esto haría que el entrenamiento distribuido fuera 4 veces más eficiente sin cambiar el hardware.
La pregunta clave: ¿cómo programan el trabajo para mantener todas las máquinas activas al mismo tiempo? La canalización tradicional es intrínsecamente secuencial. Para romper esa secuencia hay que intercalar los lotes de forma ingeniosa o replantear cómo fluyen los gradientes hacia atrás por la canalización.
Para quienes desarrollan IA de código abierto y usan configuraciones con varias GPU: las burbujas de canalización son la razón por la que los gráficos de utilización de la GPU se ven tan mal durante el entrenamiento distribuido. Pagas por 4 GPU, pero obtienes apenas el cómputo equivalente a 1,5 GPU.