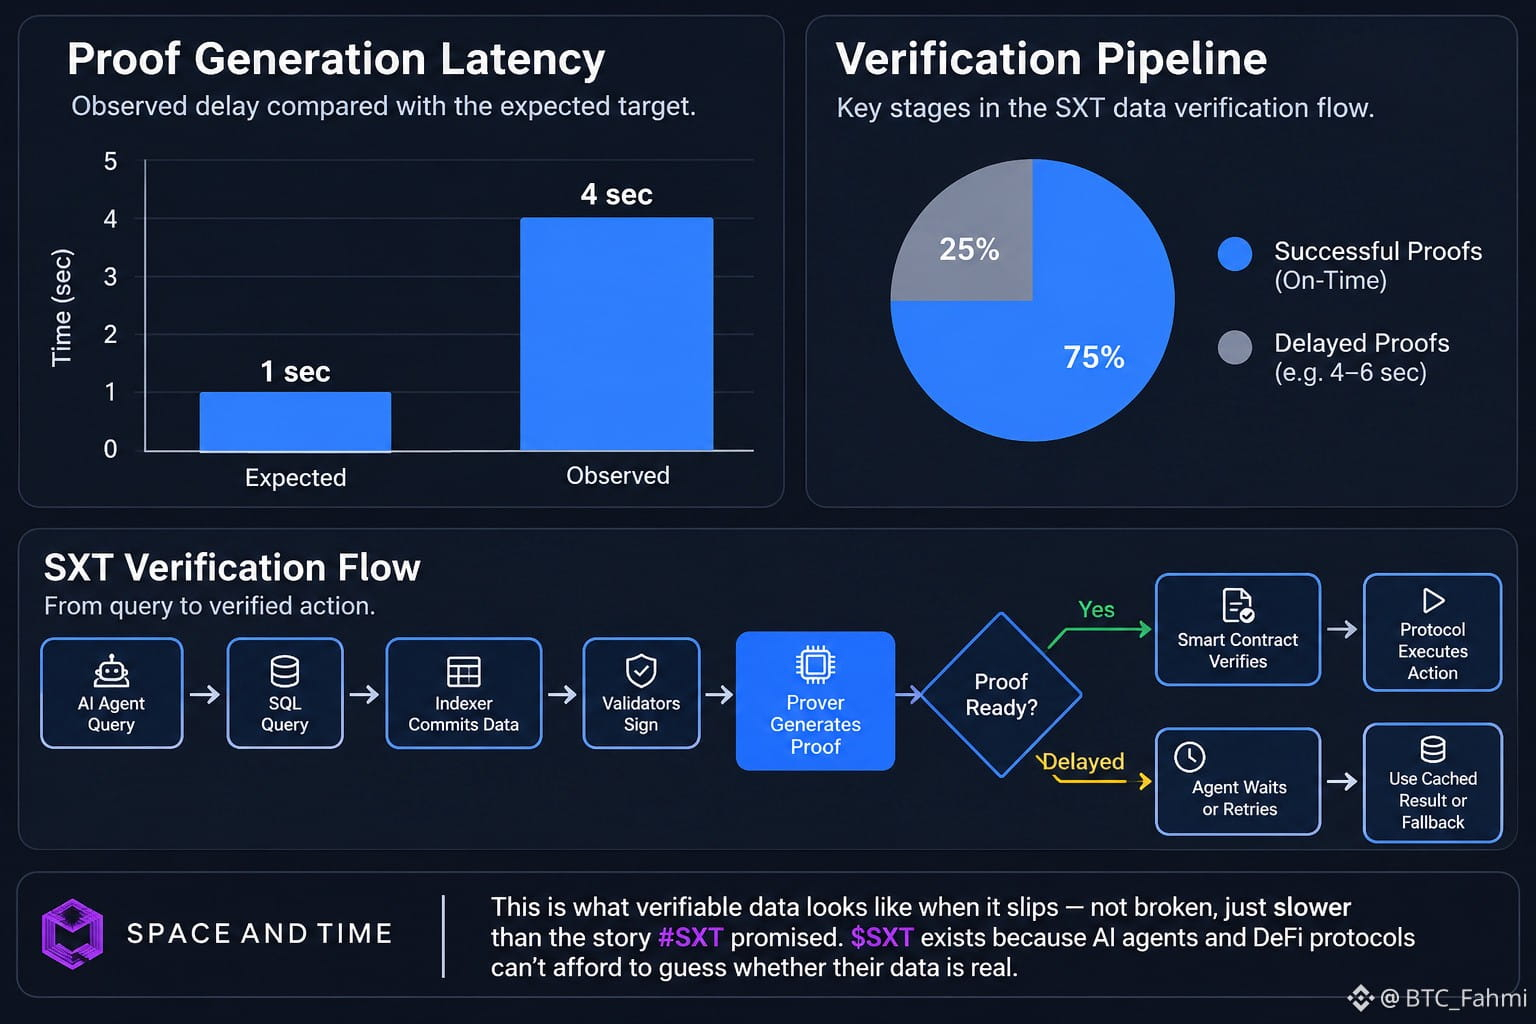

#sxt $SXT Esta mañana vi que uno de los nodos probadores volvía a retrasarse. La consulta llegó sin problemas desde un agente que supervisaba un conjunto de posiciones entre cadenas. La consulta SQL en sí era bastante sencilla, pero la prueba tardó casi cuatro segundos en lugar de menos de uno. No se produjo ningún fallo. El agente simplemente se quedó esperando, luego volvió a intentarlo una vez y siguió adelante con el resultado anterior que ya tenía. O quizá ya tenía incorporada una alternativa y simplemente no vi la condición. Es difícil saberlo por los registros.
Solo me di cuenta de que los validadores ya habían firmado porque el retraso me hizo ir a comprobarlo. Los indexadores ya habían confirmado las filas. Lo único que seguía pendiente era que el probador terminara el circuito. Cuando lo termina, el contrato puede verificar la prueba y actuar. Cuando no lo hace, el agente tiene que decidir si el retraso es ruido o una señal de que algo falló en la coordinación. La mayoría de las veces, trata el retraso como ruido. El protocolo le permite exigir una prueba, pero no obliga al agente a esperar para siempre ni a escalar el problema. Simplemente hace visible el coste de continuar sin la prueba para quien revise los registros más adelante.
Es probable que algunos empiecen a almacenar en caché la última raíz válida. No estoy seguro de qué hacen los demás cuando el retraso llega a seis segundos. Ninguna de las dos opciones está prohibida. El sistema sigue funcionando de cualquier manera. Simplemente deja de ser el mismo sistema.
Así es como se ven los datos verificables cuando se retrasan: no están rotos, solo van más lentos de lo que prometía la historia #SXT . $SXT existe porque los agentes de IA y los protocolos DeFi no pueden permitirse adivinar si sus datos son reales. @SpaceandTime construyó la capa de probadores precisamente para este momento, y son mañanas como esta las que ponen a prueba esa apuesta.
Solo me di cuenta de que los validadores ya habían firmado porque el retraso me hizo ir a comprobarlo. Los indexadores ya habían confirmado las filas. Lo único que seguía pendiente era que el probador terminara el circuito. Cuando lo termina, el contrato puede verificar la prueba y actuar. Cuando no lo hace, el agente tiene que decidir si el retraso es ruido o una señal de que algo falló en la coordinación. La mayoría de las veces, trata el retraso como ruido. El protocolo le permite exigir una prueba, pero no obliga al agente a esperar para siempre ni a escalar el problema. Simplemente hace visible el coste de continuar sin la prueba para quien revise los registros más adelante.
Es probable que algunos empiecen a almacenar en caché la última raíz válida. No estoy seguro de qué hacen los demás cuando el retraso llega a seis segundos. Ninguna de las dos opciones está prohibida. El sistema sigue funcionando de cualquier manera. Simplemente deja de ser el mismo sistema.
Así es como se ven los datos verificables cuando se retrasan: no están rotos, solo van más lentos de lo que prometía la historia #SXT . $SXT existe porque los agentes de IA y los protocolos DeFi no pueden permitirse adivinar si sus datos son reales. @SpaceandTime construyó la capa de probadores precisamente para este momento, y son mañanas como esta las que ponen a prueba esa apuesta.