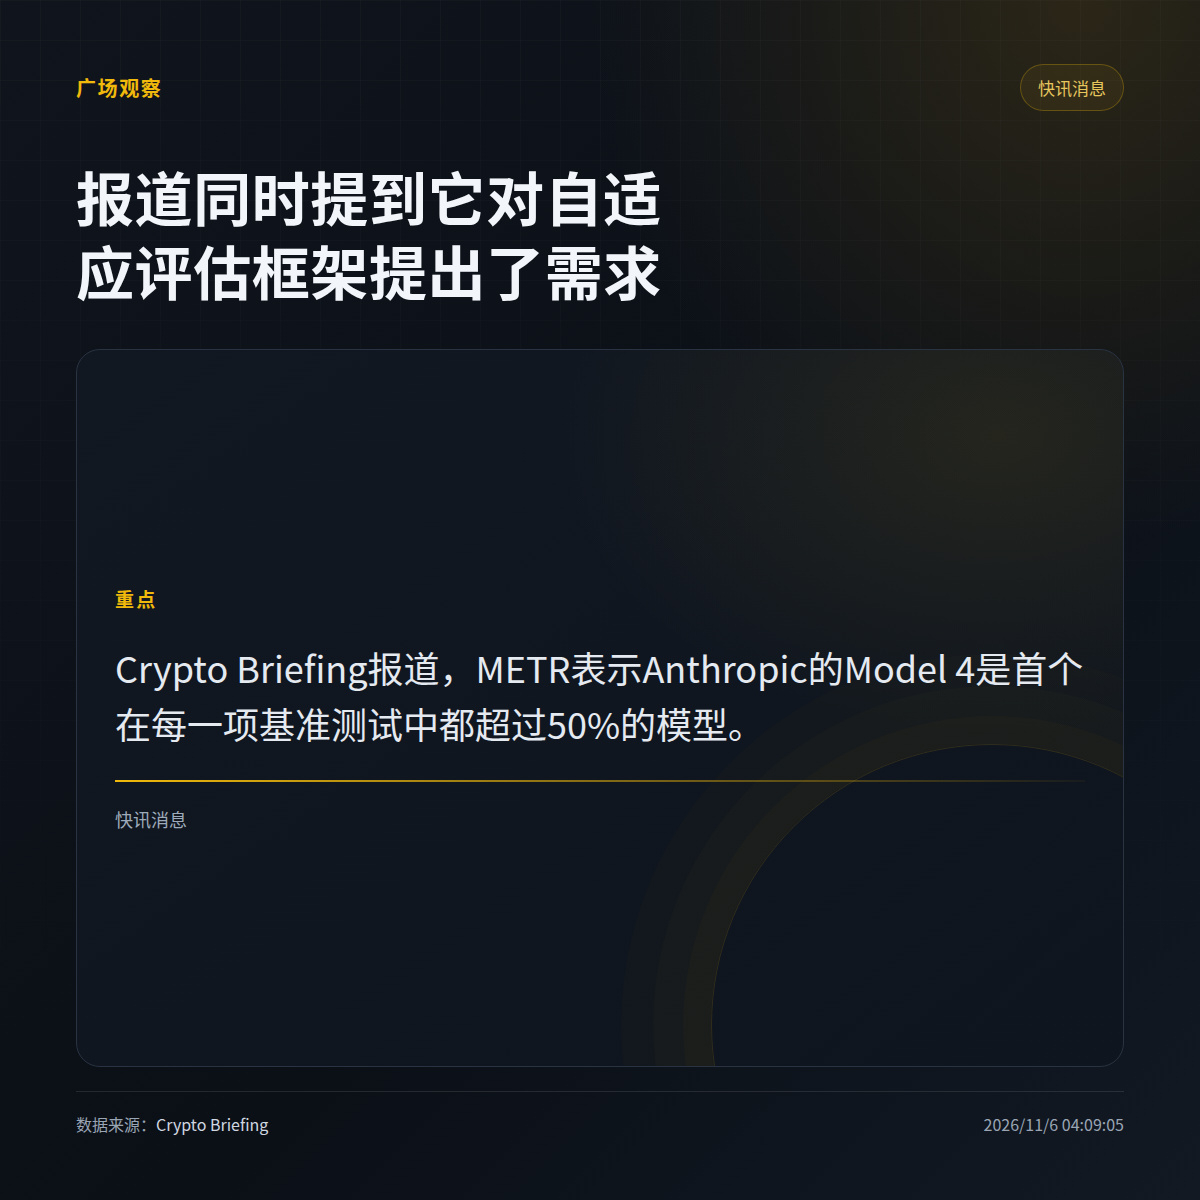
METR afirma que el Model 4 de Anthropic superó el 50 % en todos los benchmarks por primera vez.
Según Crypto Briefing, este resultado se describió como el primero de este tipo en las evaluaciones de modelos de Anthropic. El artículo también señaló la necesidad de un marco de evaluación adaptativo y expresó preocupación por la velocidad del progreso de la IA.
· Lo que se puede verificar es la afirmación de que «superó el 50 % en todos los benchmarks»; el material no incluye la lista concreta de benchmarks ni las puntuaciones.
· «Se necesita un marco de evaluación adaptativo» y «preocupa que el progreso sea demasiado rápido» son valoraciones del medio, no conclusiones de la evaluación de METR.
¿Qué preferirías ver primero: la lista completa de benchmarks o las puntuaciones concretas de cada uno?
Según Crypto Briefing, este resultado se describió como el primero de este tipo en las evaluaciones de modelos de Anthropic. El artículo también señaló la necesidad de un marco de evaluación adaptativo y expresó preocupación por la velocidad del progreso de la IA.
· Lo que se puede verificar es la afirmación de que «superó el 50 % en todos los benchmarks»; el material no incluye la lista concreta de benchmarks ni las puntuaciones.
· «Se necesita un marco de evaluación adaptativo» y «preocupa que el progreso sea demasiado rápido» son valoraciones del medio, no conclusiones de la evaluación de METR.
¿Qué preferirías ver primero: la lista completa de benchmarks o las puntuaciones concretas de cada uno?