Hay una herramienta para ahorrar dinero al ejecutar agentes que consumen tokens: headroom comprime localmente los registros, el JSON y los archivos que devuelven las herramientas antes de que lleguen al modelo.
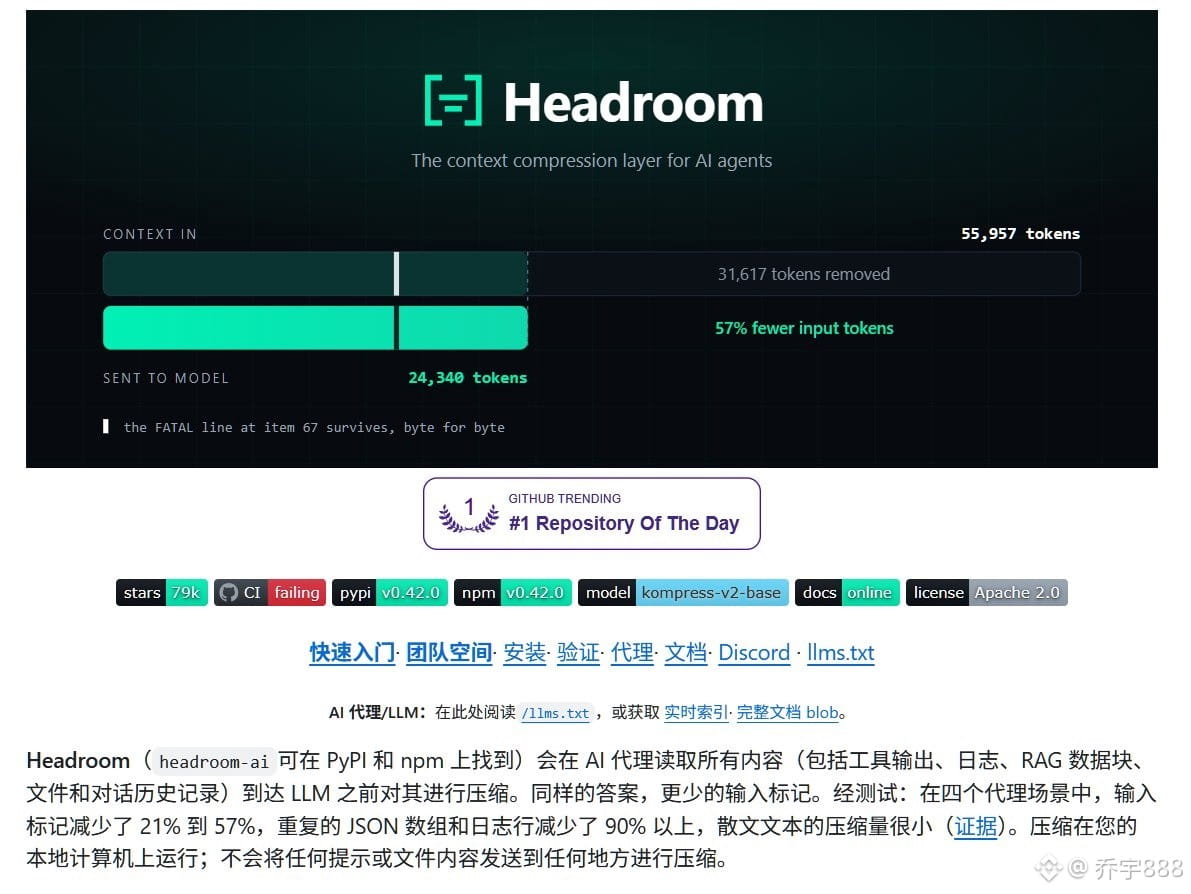
Según las pruebas oficiales: una investigación de una incidencia de SRE pasó de 55.957 tokens a 24.340, un ahorro del 57 %; un registro de 10.144 tokens se redujo a 1.260 y conservó las líneas FATAL importantes; los arrays JSON y las líneas de registro repetidos se pueden reducir en más de un 90 %, mientras que el texto sin formato apenas se comprime. La compresión tarda menos de 1 milisegundo, los datos no salen del dispositivo y la puntuación en la prueba matemática GSM8K fue de 0,870 tanto antes como después de comprimir.
Mi opinión: lo que más cuesta al ejecutar agentes no es que el modelo piense demasiado, sino que lea una y otra vez los registros que devuelven las herramientas. Comprimirlos localmente antes de enviarlos al modelo puede reducir la factura a la mitad de entrada. Creo que cuánto se ahorra depende de lo que genere cada agente; quienes tengan muchos registros serán los primeros en notar el beneficio.
#FronteraIA
$BTC
Según las pruebas oficiales: una investigación de una incidencia de SRE pasó de 55.957 tokens a 24.340, un ahorro del 57 %; un registro de 10.144 tokens se redujo a 1.260 y conservó las líneas FATAL importantes; los arrays JSON y las líneas de registro repetidos se pueden reducir en más de un 90 %, mientras que el texto sin formato apenas se comprime. La compresión tarda menos de 1 milisegundo, los datos no salen del dispositivo y la puntuación en la prueba matemática GSM8K fue de 0,870 tanto antes como después de comprimir.
Mi opinión: lo que más cuesta al ejecutar agentes no es que el modelo piense demasiado, sino que lea una y otra vez los registros que devuelven las herramientas. Comprimirlos localmente antes de enviarlos al modelo puede reducir la factura a la mitad de entrada. Creo que cuánto se ahorra depende de lo que genere cada agente; quienes tengan muchos registros serán los primeros en notar el beneficio.
#FronteraIA
$BTC