La clasificación de evaluaciones de IA dio un vuelco esta semana, y el resultado es un poco difícil de entender.
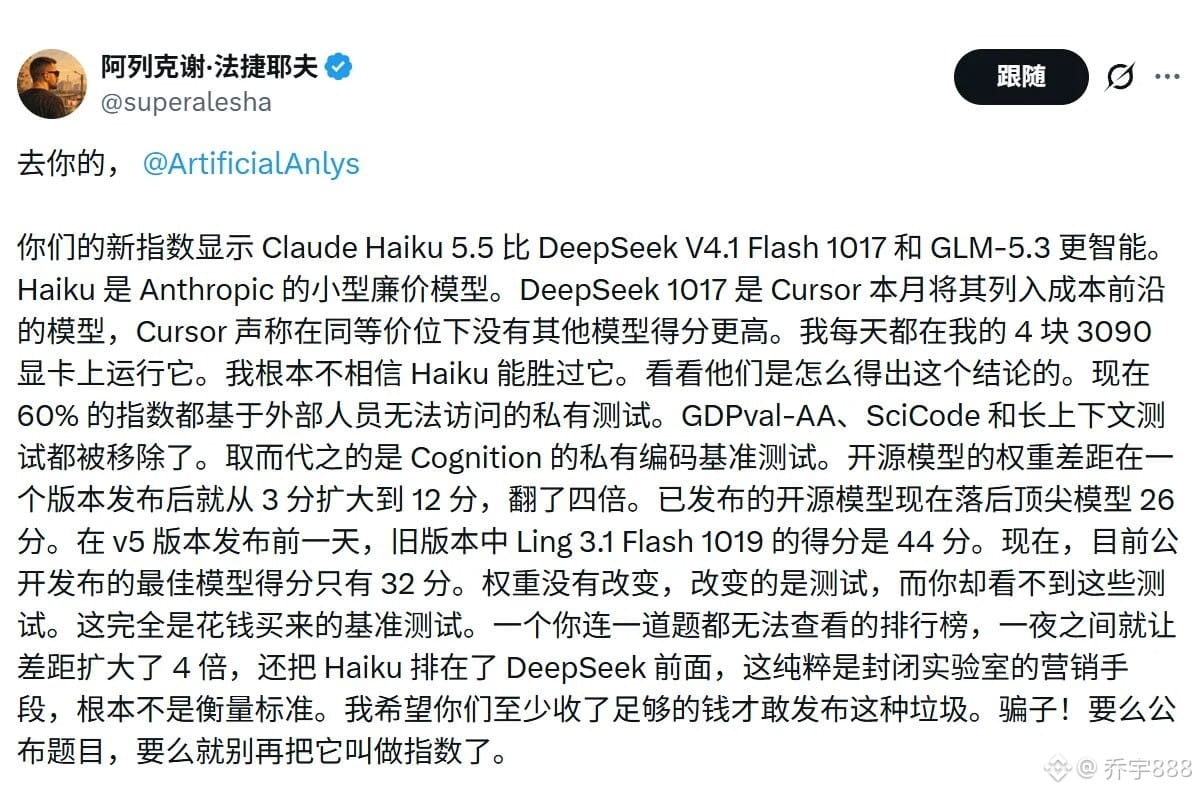
El 23 de octubre, Artificial Analysis todavía le daba 55 puntos a Kimi K3.1 Pro y lo situaba en el cuarto puesto mundial. Pero el 27 de octubre, tras actualizarse la clasificación V5, Kimi cayó directamente a 46 puntos; DeepSeek y GLM se quedaron en solo 32, y el primer puesto pasó a ser para Gemini 4 Carbon, con 59 puntos.
El cambio clave está en el algoritmo: esta vez se modificaron varios apartados de evaluación y se redistribuyeron las ponderaciones. El 60 % del peso recae en conjuntos de pruebas privados o respuestas ocultas. Es decir, más de la mitad de los puntos de la clasificación proviene de pruebas que el público no puede ver ni verificar de forma independiente.
Mi opinión: la clasificación debería servirles a los desarrolladores para elegir modelos, pero si cambian las graduaciones de la regla, los resultados de las mediciones también cambian por completo. Que Kimi haya bajado de 55 a 46 puntos y DeepSeek a 32 no significa necesariamente que los modelos hayan empeorado; es más probable que haya cambiado la forma de medirlos. Creo que, al consultar una clasificación, hay que fijarse en cómo se calcula y no solo en los puestos, sobre todo cuando el 60 % de la puntuación proviene de pruebas de caja negra. En ese caso, conviene tomar esta clasificación con cautela.
#FronteraIA
$BTC
El 23 de octubre, Artificial Analysis todavía le daba 55 puntos a Kimi K3.1 Pro y lo situaba en el cuarto puesto mundial. Pero el 27 de octubre, tras actualizarse la clasificación V5, Kimi cayó directamente a 46 puntos; DeepSeek y GLM se quedaron en solo 32, y el primer puesto pasó a ser para Gemini 4 Carbon, con 59 puntos.
El cambio clave está en el algoritmo: esta vez se modificaron varios apartados de evaluación y se redistribuyeron las ponderaciones. El 60 % del peso recae en conjuntos de pruebas privados o respuestas ocultas. Es decir, más de la mitad de los puntos de la clasificación proviene de pruebas que el público no puede ver ni verificar de forma independiente.
Mi opinión: la clasificación debería servirles a los desarrolladores para elegir modelos, pero si cambian las graduaciones de la regla, los resultados de las mediciones también cambian por completo. Que Kimi haya bajado de 55 a 46 puntos y DeepSeek a 32 no significa necesariamente que los modelos hayan empeorado; es más probable que haya cambiado la forma de medirlos. Creo que, al consultar una clasificación, hay que fijarse en cómo se calcula y no solo en los puestos, sobre todo cuando el 60 % de la puntuación proviene de pruebas de caja negra. En ese caso, conviene tomar esta clasificación con cautela.
#FronteraIA
$BTC