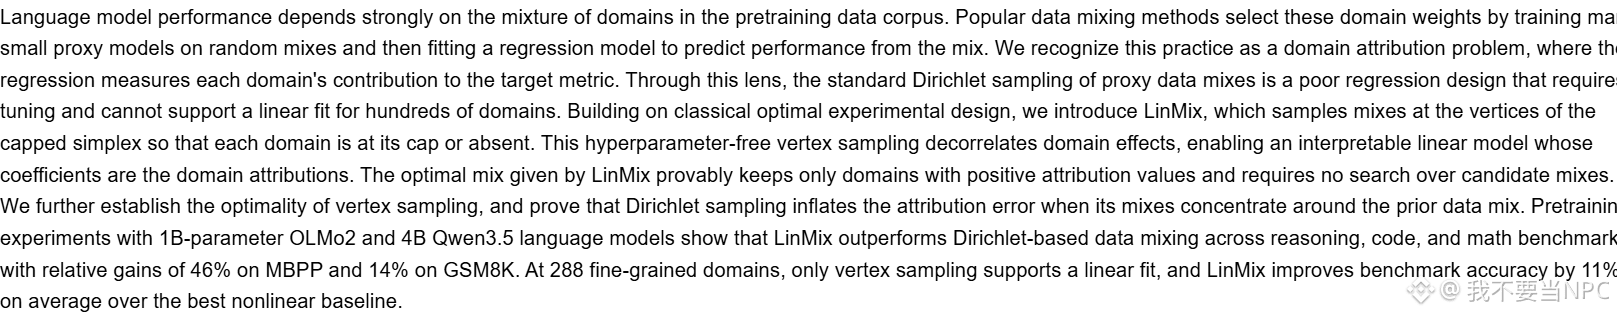
Este preprint de LinMix propone una forma distinta de elegir las proporciones de los datos de preentrenamiento: en vez de generar al azar muchos modelos pequeños para probar proporciones y luego usar una regresión para estimar cuánto aporta cada dominio, toma muestras únicamente de los vértices, donde cada dominio está presente en su totalidad o ausente. Así, los efectos de los distintos dominios tienden a mezclarse menos y los coeficientes del modelo lineal pueden interpretarse directamente como atribuciones.
Según el resumen, la proporción óptima conserva solo los dominios con atribuciones positivas, sin necesidad de buscar mezclas candidatas. Los autores realizaron experimentos de preentrenamiento con OLMo2, de 1B de parámetros, y Qwen3.5, de 4B, y afirman que superaron el muestreo de Dirichlet en pruebas de razonamiento, código y matemáticas: una mejora relativa del 46 % en MBPP y del 14 % en GSM8K. Con 288 dominios de granularidad fina, solo el muestreo de vértices logró mantener un ajuste lineal estable, con una media un 11 % superior a la mejor línea base no lineal.
Se trata de un preprint de arXiv que no parece haber pasado por revisión por pares; las cifras corresponden al alcance de los experimentos descritos en el resumen. A quienes trabajan en la mezcla de datos y se encuentran con que hay tantos dominios que la regresión ya no logra ajustarse, puede interesarles cómo diseñaron ese muestreo de vértices.
$BTC