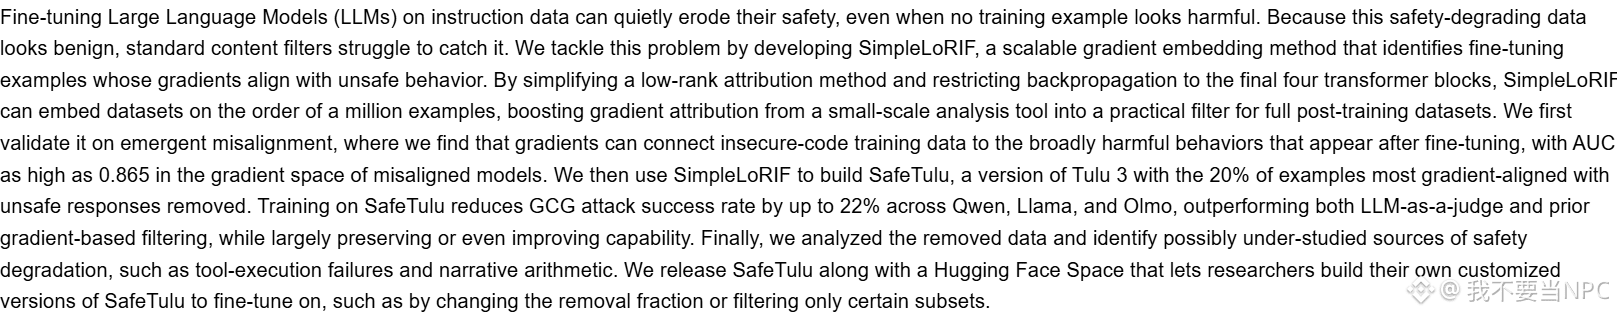
Filtrar datos de ajuste fino para modelos grandes: esta vez, poniendo el foco en los gradientes. SimpleLoRIF es un método propuesto en un artículo que simplifica la atribución de gradientes: solo los propaga hacia las cuatro últimas capas del Transformer. Así, el análisis de gradientes, que antes solo podía aplicarse a pequeña escala, puede procesar conjuntos de datos de ajuste fino con millones de muestras.
El equipo de investigación lo utilizó para eliminar de Tulu 3 el 20 % de las muestras cuyos gradientes estaban más asociados con respuestas inseguras y crear SafeTulu. Según el resumen, entrenar con SafeTulu en Qwen, Llama y Olmo reduce hasta un 22 % la tasa de éxito de los ataques GCG. El método supera a los jueces basados en LLM y a los métodos anteriores de filtrado por gradientes, y conserva prácticamente las capacidades del modelo, que incluso mejoran ligeramente.
Merece la pena fijarse en el tipo de datos eliminados: el resumen menciona fallos en la ejecución de herramientas y problemas aritméticos planteados en forma narrativa. A simple vista, estos contenidos no parecen dañinos, por lo que los filtros de contenido estándar difícilmente los detectarían.
Es un preprint de arXiv, aún sin revisión por pares; las conclusiones anteriores se limitan al alcance de los experimentos descritos en el resumen. Ya están disponibles SafeTulu y un espacio de Hugging Face que permite personalizar la proporción de datos que se elimina.
$BTC