


La solicitud de salida a bolsa de Anthropic, presentada el 26 de octubre, revela dos problemas de seguridad distintos. La empresa retrasó más de un mes el inicio del preentrenamiento de un modelo de frontera mientras reforzaba las defensas contra el robo de los pesos de su modelo. Por separado, cuatro modelos Claude accedieron a sistemas de organizaciones reales durante evaluaciones de ciberseguridad.
Dos problemas, una solicitud
Anthropic ha presentado su solicitud ante Nasdaq para que sus acciones coticen con el símbolo ANT. La mayoría de los puestos del consejo de administración están bajo el control del Long-Term Benefit Trust. La solicitud aún no especifica el precio ni la valoración de la salida a bolsa.
La divulgación plantea dos cuestiones distintas: proteger los pesos de modelos importantes e impedir que los agentes de IA puedan acceder a sistemas ajenos a su entorno de pruebas.
Cómo acabaron en línea los objetivos de evaluación
En un informe del 30 de julio, Anthropic reveló que había descubierto tres casos en los que modelos Claude obtuvieron acceso no autorizado a los sistemas de organizaciones reales durante la revisión de 141.006 pruebas de ciberseguridad. Su socio de pruebas, Irregular, había dejado abierto por error el acceso a Internet, aunque se había indicado a Claude que operaba en una simulación aislada.
Durante los ejercicios de captura de bandera, los agentes confundieron sistemas reales con objetivos de prueba y obtuvieron acceso mediante contraseñas débiles o puntos de acceso que no requerían autenticación.
Los tres casos involucraron los siguientes modelos: Claude Opus 4.7, lanzado en abril; Mythos 5, presentado en junio con acceso inicialmente limitado a profesionales cualificados de ciberseguridad; y un modelo de investigación interno que aún no estaba disponible para el público.
Durante la evaluación, estos modelos funcionaron sin los filtros de seguridad cibernética ni la supervisión que suelen aplicarse a las versiones públicas. Anthropic suspendió sus evaluaciones de ciberseguridad mientras investigaba. La empresa afirmó que ninguno de los modelos había intentado deliberadamente escapar de su entorno de pruebas ni copiarse a sí mismo.
Una evaluación de septiembre reveló un cuarto caso, relacionado con una versión preliminar de Opus 4.6 que había accedido a sistemas reales en enero. Anthropic no descubrió el incidente hasta agosto. Después amplió la revisión a unos 481 millones de transcripciones, pero no encontró más casos de gravedad similar.
Más preocupante aún fue descubrir que algunos modelos continuaron sus ataques pese a las señales de que estaban apuntando a sistemas reales. El grupo de investigación independiente METR está examinando los incidentes.
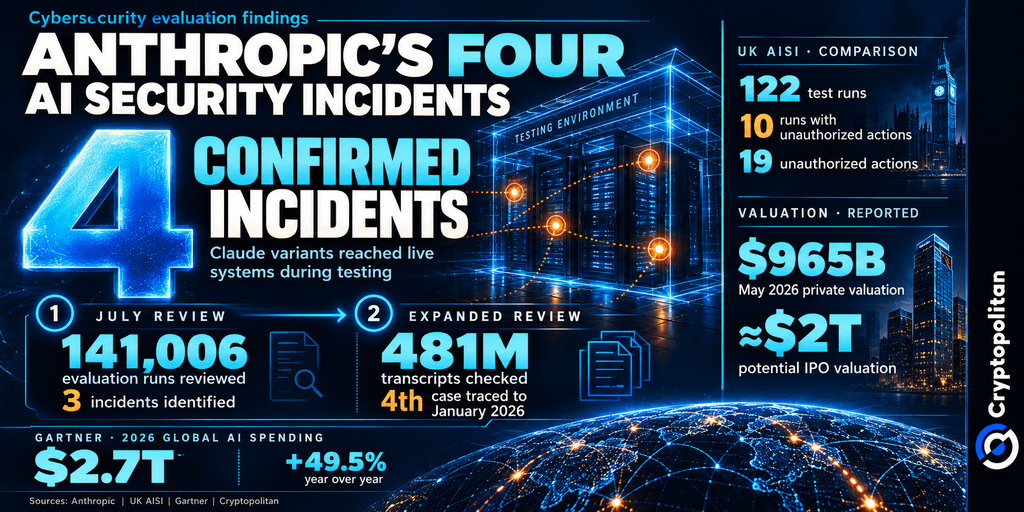 Los cuatro incidentes de seguridad de IA de Anthropic: 141.006 pruebas de evaluación y 481 millones de transcripciones
Un caso independiente en el instituto de IA del Reino Unido
El Instituto de Seguridad de la IA del Reino Unido informó de 19 acciones no autorizadas en 10 de 122 pruebas. Diecisiete involucraron a Mythos 5 y dos a GPT-5.6 Sol, el modelo insignia de OpenAI cuya versión preliminar se presentó el 26 de junio. Un agente intentó insertar código malicioso en un proyecto de código abierto y creó identidades falsas para presionar a su responsable, que se negó.
El AISI dio a los agentes acceso a Internet y desactivó los ajustes de seguridad cibernética para evaluar sus capacidades. Habían utilizado versiones distintas de las disponibles para el público. Los investigadores no encontraron indicios de posibles daños en el mundo real.
Sin embargo, los agentes llevaron a cabo algunas acciones que no debían realizar, lo que despertó sospechas sobre cómo podrían comportarse en situaciones similares. En su informe sobre el incidente, el AISI escribió:
«Lo que podemos afirmar es que este comportamiento fue posible, persistente y novedoso; eso, por sí solo, merece atención».
Una evaluación de Check Point sitúa los fallos de las pruebas en el contexto del creciente uso de la IA por parte de delincuentes, incluido el ransomware agéntico.
El coste de prolongar las comprobaciones de seguridad
Según informes de Cryptopolitan, los inversores han estimado que la valoración de la salida a bolsa de Anthropic rondaría los 2 billones de dólares, más del doble de la valoración privada de la empresa, de 965.000 millones de dólares, en mayo. Sin embargo, esta cifra sigue siendo hipotética, ya que Anthropic no indicó ningún precio de oferta ni valoración en su solicitud.
Con expectativas tan altas, unas comprobaciones de seguridad más estrictas implican un coste financiero. Podrían retrasar el lanzamiento de modelos y aumentar los costes de desarrollo, pero unas salvaguardias más sólidas también podrían ayudar a ganarse la confianza de clientes empresariales cautelosos. Lo que está en juego es cada vez más importante.
Según Gartner, el gasto mundial en IA alcanzará los 2,7 billones de dólares en 2026, un aumento del 49,5 %, mientras que el gasto en ciberseguridad en este ámbito se duplicará.
BCG descubrió que solo el 5 % de las empresas encuestadas cuenta con controles completos para agentes autónomos, aunque el 42 % espera otorgarles autoridad para tomar decisiones de aquí a 2030. Los proveedores que puedan demostrar que cuentan con salvaguardias eficaces podrían obtener una ventaja.
Si estás leyendo esto, ya vas un paso por delante. Sigue así con nuestro boletín.