

La vez anterior medí cuánto tardaba en generarse una prueba para una transacción. Algunos amigos señalaron que solo hice una prueba procesando una transacción, y que no medí qué pasaba cuando llegaban muchas al mismo tiempo. Los servidores de las instituciones en la vida real no procesan las transacciones en orden, una por una. Así que esta vez puse en marcha el servicio de generación de pruebas de Rayls y, durante varios minutos seguidos, le envié simultáneamente entre 1 y 16 solicitudes.
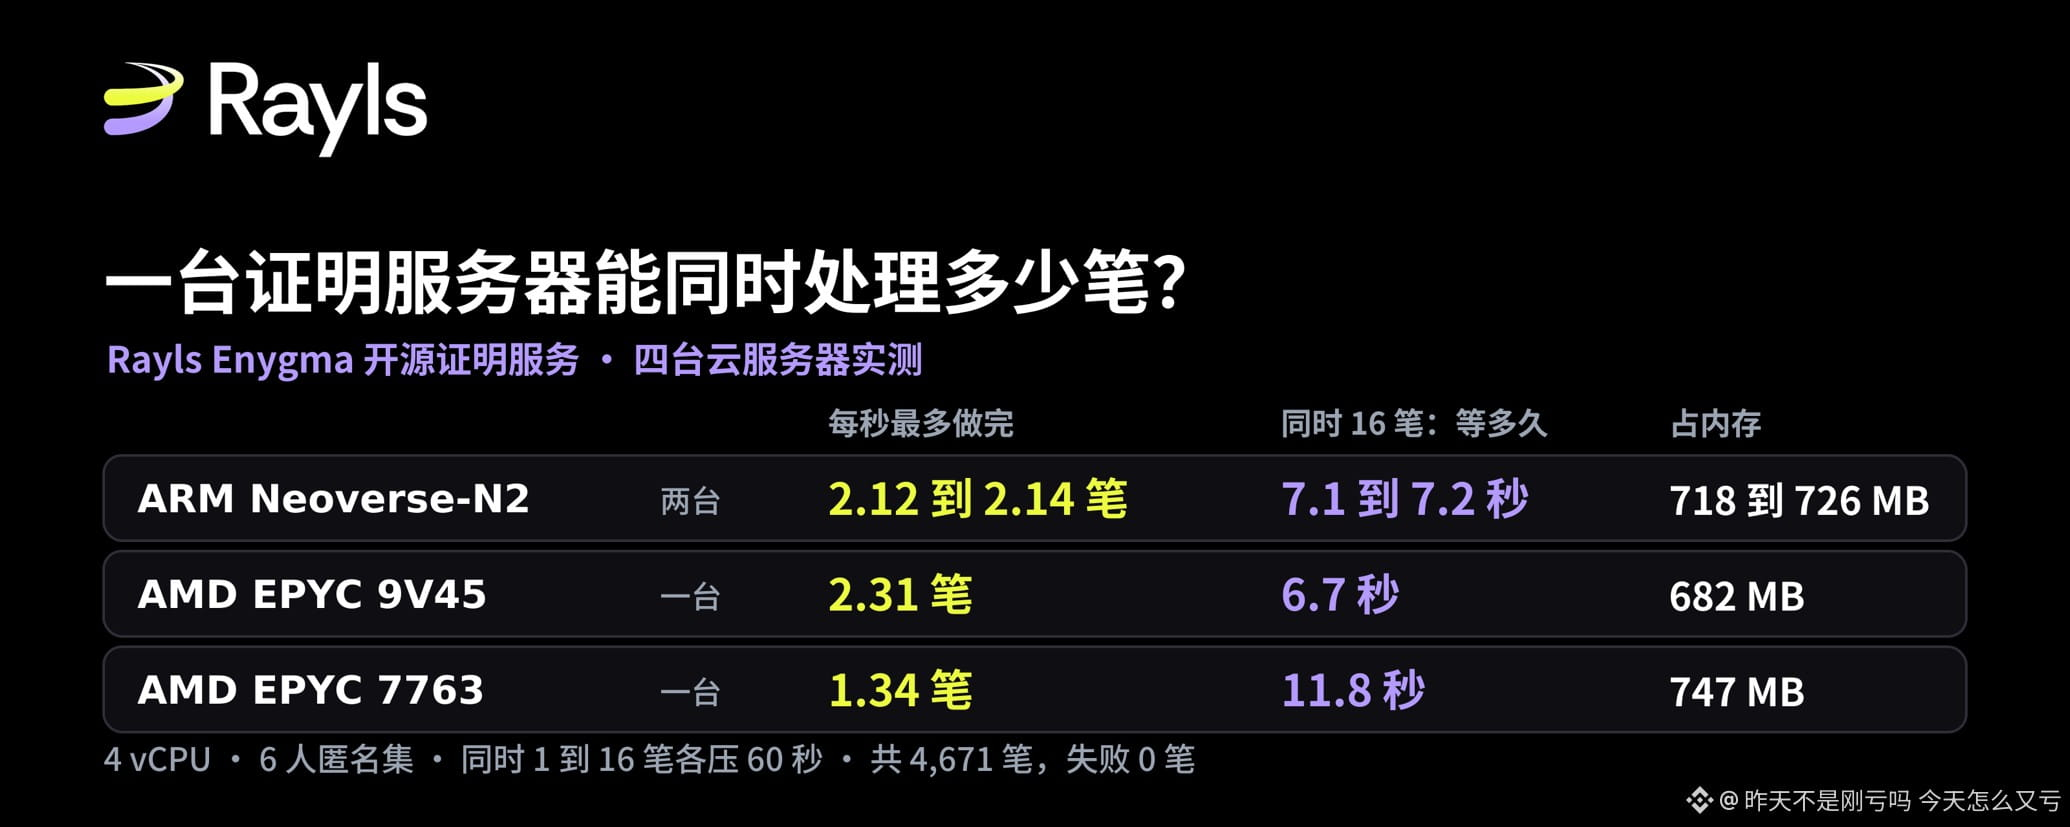
Primero, la respuesta breve. Tomando como ejemplo el conjunto de anonimato de 6 usuarios del circuito de transferencias privadas Enygma de Rayls, un servidor en la nube con 4 vCPU puede recibir 16 solicitudes a la vez y procesarlas todas sin que falle ninguna, pero solo logra completar entre 1,3 y 2,3 por segundo. Cuando hay más de 2 a 4 solicitudes procesándose simultáneamente, añadir más solicitudes no hace que se completen antes: solo hace que cada una espere más y consuma más memoria. Con 16 solicitudes simultáneas, la mediana del tiempo de espera por transferencia pasa de 0,5–0,9 segundos a 6,7–11,8 segundos, y el uso de memoria sube de unos 260 MB a entre 680 y 750 MB.
A continuación explico de dónde salen estas cifras, por qué se dan estos resultados y qué implican para una institución que se plantea generar sus propias pruebas.
Por qué importa más «cuántas transacciones simultáneas» que «cuánto tarda una transacción»
Una prueba de conocimiento cero se puede entender como un comprobante matemático: quien paga puede demostrar a la red que la operación es correcta sin revelar el importe ni la contraparte. Generar este comprobante requiere muchos cálculos de curvas elípticas y depende casi por completo de la CPU.
El artículo anterior respondió cuánto tarda en calcularse una prueba. Pero los servidores de una institución reciben solicitudes en tandas y al mismo tiempo. En un servicio que consume toda la CPU, la cantidad de transacciones que puede procesar simultáneamente determina el rendimiento, el tiempo de espera y la memoria: esos son los tres factores que hay que tener en cuenta al comprar y desplegar el equipo.
Este problema no es exclusivo de Rayls. Todos los sistemas que generan pruebas de conocimiento cero en sus propios servidores se enfrentan a la misma disyuntiva; lo que cambia es el tamaño del circuito y el hardware.
Cómo se hizo la prueba y cómo puede reproducirla cualquiera
Se probó de nuevo el servicio de pruebas de código abierto de Rayls, rayls-sovereign-gnark-api, commit 67c4c26, sin modificar ni una línea de código. El código de prueba está en el repositorio público hansonhan0520-lang/enygma-bench. Esta vez se añadió loadgen, una herramienta de pruebas de carga escrita únicamente con la biblioteca estándar de Go, y el script run_load.sh. GitHub Actions los ejecuta automáticamente y los registros se guardan automáticamente en la carpeta results del repositorio.
El procedimiento fue el siguiente: iniciar sin modificar el servicio HTTP de pruebas de Rayls y hacer que procesara simultáneamente 1, 2, 4, 8 y 16 solicitudes, manteniendo cada nivel durante 60 segundos y excluyendo los primeros 5 segundos de calentamiento. Se registró la duración de cada solicitud y se leyó la memoria del proceso del servicio cada 0,1 segundos. Por último, se mantuvieron 4 solicitudes en proceso simultáneamente durante 5 minutos y se calcularon las estadísticas en intervalos de 30 segundos.
Todas las cifras de esta prueba proceden de la ejecución de Actions 39977915567 (23 de octubre de 2026), que realizó una prueba en cada una de cuatro máquinas virtuales en la nube asignadas de forma independiente: dos con ARM Neoverse-N2, una con AMD EPYC 9V45 y una con AMD EPYC 7763. Las cuatro tenían 4 vCPU. En total se procesaron 4.671 solicitudes y ninguna falló.
Aclaremos qué hay de nuevo. El generador de datos de prueba y la medición de transacciones individuales son los mismos del artículo anterior. Lo nuevo en este artículo es el rendimiento, la latencia de cola y la memoria del servicio real con concurrencia; una carga sostenida de 5 minutos; y un experimento de comparación con la CPU fijada.
Cuantas más transacciones se calculan a la vez, más lento va; no más rápido
El patrón fue exactamente el mismo en las cuatro máquinas. Al pasar de 1 a 2 transacciones simultáneas, aumentó el número de transacciones completadas por segundo: cerca de un tercio más en N2, alrededor de un 18 % más en 9V45 y un 14 % más en 7763. El máximo se alcanzó con 4 transacciones simultáneas: entre 2,12 y 2,14 transacciones por segundo en N2, 2,31 en 9V45 y 1,34 en 7763. Al aumentar la concurrencia a 16, el rendimiento bajó entre un 4 % y un 10 % respecto del máximo.
El tiempo de espera, en cambio, no dejó de aumentar. Con 1 transacción simultánea, la mediana de duración de una solicitud era de 0,52 a 0,86 segundos; con 16, pasó a ser de 6,70 a 11,81 segundos, entre 11 y 14 veces más. El 1 % más lento tuvo que esperar entre 10,00 y 13,91 segundos.
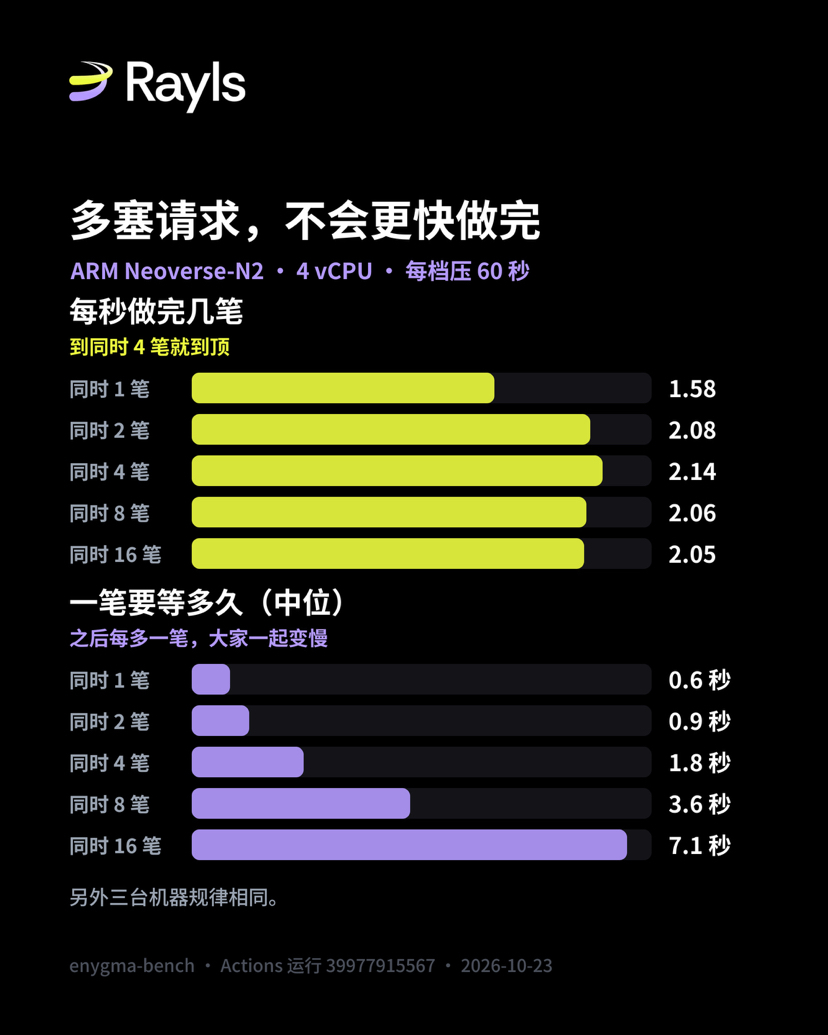
Los propios registros del servicio revelan a qué se debe el tiempo de espera. El servicio de pruebas de Rayls registra el tiempo que tarda en generar cada prueba. Con 16 transacciones simultáneas, la diferencia entre la mediana de ese tiempo y la duración total medida desde fuera fue inferior al 3 %. Es decir, las solicitudes no se quedaban haciendo cola en la entrada: empezaban a calcularse en cuanto llegaban. Las 16 solicitudes competían por 4 vCPU y todas se ralentizaban. El código confirma esta explicación: el servicio no tiene un límite de concurrencia y cada solicitud pasa directamente al proceso de generación de pruebas.
Esto responde a una regla general: en una máquina que ya está al máximo de su capacidad, el número de transacciones que se calculan simultáneamente equivale al número de transacciones completadas por segundo multiplicado por el tiempo que tarda cada una. Una vez alcanzado el máximo de rendimiento, añadir solicitudes solo aumenta el tiempo que tardan.
Cada transacción adicional en proceso consume unos 30 MB más de memoria
Tras iniciar el servicio y cargar la clave de prueba del grupo de 6 personas, el consumo en reposo era de 210 a 217 MB. Cuantas más solicitudes se procesaban simultáneamente, mayor era el consumo de memoria: con 16, el pico alcanzó entre 682 y 747 MB, es decir, unos 28 a 32 MB más por cada transacción adicional en proceso. Esto no supone un problema para una máquina de 4 vCPU y 16 GB, pero, si las solicitudes se disparan de repente y no hay un límite, el consumo de memoria crecerá de forma lineal con el número de solicitudes.
Cinco minutos seguidos sin ralentización
Se procesaron 4 solicitudes simultáneamente durante 5 minutos y se calcularon las estadísticas cada 30 segundos. En cada intervalo, el rendimiento de las cuatro máquinas se mantuvo dentro de un margen de ±7 % de su promedio respectivo: entre 2,03 y 2,23 transacciones por segundo en las dos N2, entre 2,13 y 2,37 en la 9V45 y entre 1,30 y 1,43 en la 7763. El pico de memoria se mantuvo estable, entre 421 y 505 MB, sin señales de aumento sostenido. No falló ninguna solicitud durante la prueba.
La hipótesis del artículo anterior, puesta a prueba esta vez con un experimento comparativo
En el artículo anterior observé que la máquina Intel solo era 1,17 veces más rápida al pasar de 2 a 4 vCPU, y lo expliqué con lo que mostraba lscpu: «2 núcleos, cada uno ejecutando 2 hilos». Un revisor señaló que los servidores en la nube son máquinas virtuales y que el número de núcleos visibles no demuestra cómo está asignado el hardware subyacente. Esa explicación era solo una hipótesis.
Esta vez usé taskset para fijar el proceso de generación de pruebas a CPU específicas y comparar, en la misma máquina, dos combinaciones de dos CPU: dos hilos del mismo núcleo o dos núcleos distintos. Alterné el orden durante tres rondas para evitar sesgos debidos a cambios en el estado de la máquina a lo largo del tiempo. Los resultados de las dos máquinas AMD fueron consistentes en todas las rondas: dos hilos del mismo núcleo fueron solo entre 1,10 y 1,18 veces más rápidos que una CPU; dos núcleos distintos fueron entre 1,53 y 1,57 veces más rápidos. En la N2, que no tiene hyperthreading, dos CPU fueron entre 1,49 y 1,58 veces más rápidas.
Por lo tanto, ahora hay resultados comparativos obtenidos en la misma máquina que respaldan la explicación de que «el hyperthreading hace que las vCPU tercera y cuarta aporten poco». Pero también hay que dejar claro el límite: esto sigue siendo la topología observada dentro de una máquina virtual; no puedo ver cómo asigna el anfitrión los núcleos físicos.
Hay otro aspecto que conviene explicar. La mejora de aproximadamente 1,5 veces al fijar el proceso a dos CPU fue inferior a la mejora de aproximadamente 1,9 veces del artículo anterior, cuando no fijé la CPU y solo limité a dos los hilos que Go podía usar. Una posible razón es que, sin fijar la CPU, otros hilos en segundo plano del programa podían aprovechar las otras dos CPU; no medí esto por separado. Por eso, las cifras con la CPU fijada sirven para comparar distintas condiciones, no para estimar la capacidad de procesamiento.
Qué implica esto para una institución que se plantea generar sus propias pruebas
Esta sección contiene inferencias, no mediciones.
Primero, establecer un límite de concurrencia para el servicio de pruebas, aproximadamente igual al número de CPU, y poner en cola las solicitudes adicionales. El rendimiento ya alcanza su máximo con 2 a 4 transacciones; las solicitudes por encima de ese límite solo ralentizan las que ya se están procesando y consumen más memoria. Esta vez no probé una versión con límite, así que aún falta verificar cuánto mejoraría la latencia de cola si se pusieran las solicitudes en espera.
Segundo, medir el rendimiento con el hardware real; no basarse en la etiqueta del tipo de máquina. En esta prueba, con el mismo ejecutor x64 de 4 vCPU de GitHub, se completaron 2,31 transacciones por segundo con un AMD EPYC 9V45, pero solo 1,34 con un AMD EPYC 7763: una diferencia de más del 40 %.
Tercero, estimar la cantidad de máquinas según el rendimiento, no el tiempo de una sola transacción. El artículo anterior estimó, a partir del tiempo de una transacción, que una máquina de 4 vCPU podía procesar aproximadamente entre 1,41 y 1,58 transacciones por segundo. En esta prueba, el rendimiento medido durante 5 minutos con 4 transacciones en proceso simultáneamente fue de entre 2,15 y 2,29 transacciones por segundo en N2 y 9V45, y de 1,35 en 7763. En el caso de N2, por ejemplo, esto supera en alrededor de un 36 % la estimación anterior de 1,58 transacciones por segundo basada en una sola transacción.
Con esta cifra, recalculo CHAPS del Reino Unido: en el ejercicio fiscal 2025, el promedio diario fue de 210.483 transacciones. Repartidas en la ventana de liquidación de cada día laborable, de 06:00 a 18:00, equivalen a unas 4,87 transacciones por segundo y requieren de 2,1 a 3,6 máquinas como esta. Fedwire de EE. UU. registró un promedio diario de 869.187 transacciones en 2025. Con 22 horas de funcionamiento al día, son unas 10,97 transacciones por segundo y se necesitan de 4,8 a 8,1 máquinas. Esta es solo una estimación de primer orden de la capacidad de generación de pruebas, no del rendimiento de liquidación de Rayls. No contempla los picos intradiarios ni la sobrecarga de los libros contables y los relés. Además, cada institución que inicia una transferencia genera sus propias pruebas, por lo que la carga ya está distribuida entre las distintas instituciones.
Lo que aún no está resuelto
Esta vez solo se probó el circuito de transferencia con un conjunto de anonimato de 6 personas; no se probaron los circuitos de depósito, retirada ni DvP. Se probó el servicio de pruebas de Rayls en sí, no el proceso completo de liquidación de Rayls, que también incluye los libros contables, los relés y los concentradores de redes privadas de cada institución. Estos componentes no se pueden ejecutar con el código público. Las cuatro máquinas eran máquinas virtuales de servidores en la nube compartidos, no servidores físicos ni el entorno de producción de Rayls. El recolector de basura de Go usó la configuración predeterminada; con otros ajustes, el perfil de memoria podría ser distinto. No encontré información pública sobre el hardware ni la configuración de concurrencia del entorno de producción de Rayls.
Mi opinión
Un servidor en la nube corriente de 4 vCPU puede recibir a la vez más de una decena de solicitudes de pruebas de conocimiento cero sin fallar y mantener una producción estable durante varios minutos. Pero tiene un límite de capacidad claro: aproximadamente entre una y algo más de dos transacciones por segundo. Superado ese límite, aceptar más solicitudes solo genera más espera y más consumo de memoria.
El criterio para comprobarlo es sencillo: cualquiera puede ejecutar en la página Actions del repositorio enygma-bench la herramienta enygma-load y verificar si el rendimiento de la máquina que le asignaron también alcanza su límite cuando hay entre 2 y 4 transacciones calculándose simultáneamente. Si Rayls publica en el futuro la configuración de su servicio de pruebas en producción —por ejemplo, si tiene un límite de concurrencia y qué hardware utiliza—, se podrá contrastar directamente con esta prueba de carga.
Fuentes de referencia:
Código fuente del servicio de pruebas de Rayls, raylsnetwork/rayls-sovereign-gnark-api, commit 67c4c26 (20 de agosto de 2026): https://github.com/raylsnetwork/rayls-sovereign-gnark-api/commit/67c4c26696016b48e70950e284ae1a51b7d0cf0e
Código de las pruebas de carga de este artículo y registros completos, ejecución de Actions 39977915567 (23 de octubre de 2026): https://github.com/hansonhan0520-lang/enygma-bench
Prueba de transacción individual del artículo anterior y sus registros, ejecución de Actions 37741247183 (8 de octubre de 2026): https://github.com/hansonhan0520-lang/enygma-bench
Especificaciones de los ejecutores alojados por GitHub (consultadas el 8 de octubre de 2026): https://docs.github.com/en/actions/reference/runners/github-hosted-runners
Estadísticas de Fedwire Funds de 2025 (página actualizada el 26 de enero de 2026): https://www.frbservices.org/resources/financial-services/wires/volume-value-stats/annual-stats.html
Estadísticas de pagos y liquidación del Banco de Inglaterra, promedio diario de transacciones de CHAPS en el ejercicio fiscal 2025: https://www.bankofengland.co.uk/payment-and-settlement/payment-and-settlement-statistics
#Rayls $RLS #PruebasDeConocimientoCero