

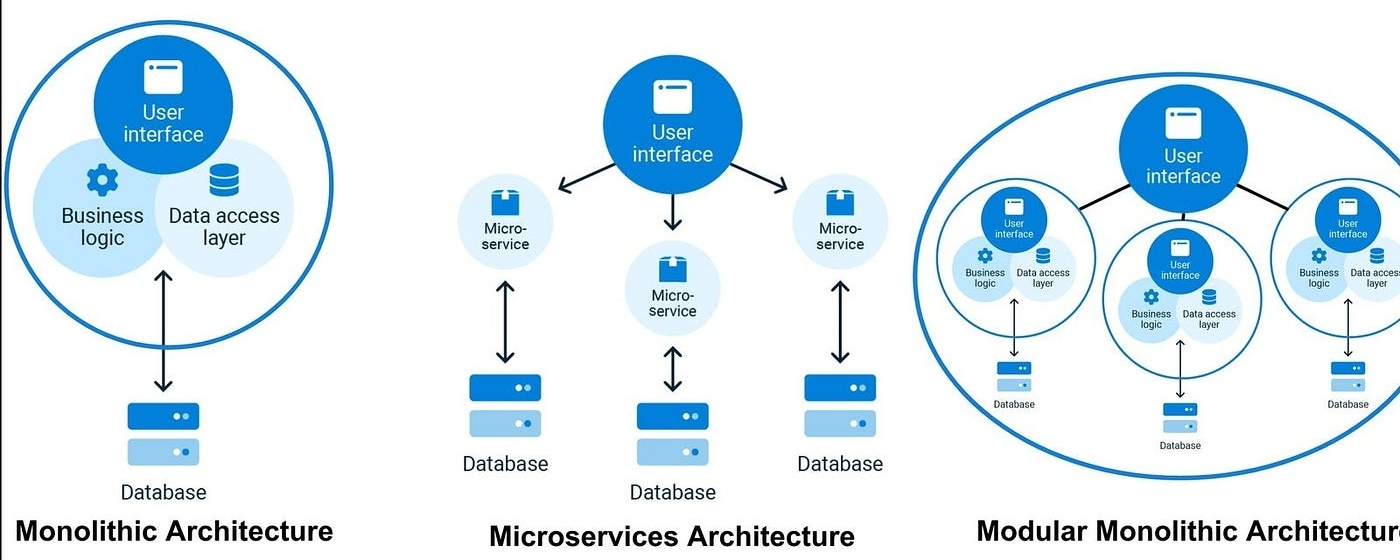
La «Computadora ciega» de Nillion no es un único servidor centralizado, sino una red distribuida compuesta por nodos que implementan cada uno «módulos ciegos» específicos. Según la documentación oficial de Nillion, cada nodo es responsable de la funcionalidad de un módulo ciego, y los desarrolladores pueden combinar varios nodos en un «clúster» según sus necesidades reales. La lógica central de esta arquitectura es que la protección de la privacidad no debe depender de la confianza en un único operador, sino lograrse mediante la colaboración distribuida y mecanismos criptográficos entre los nodos.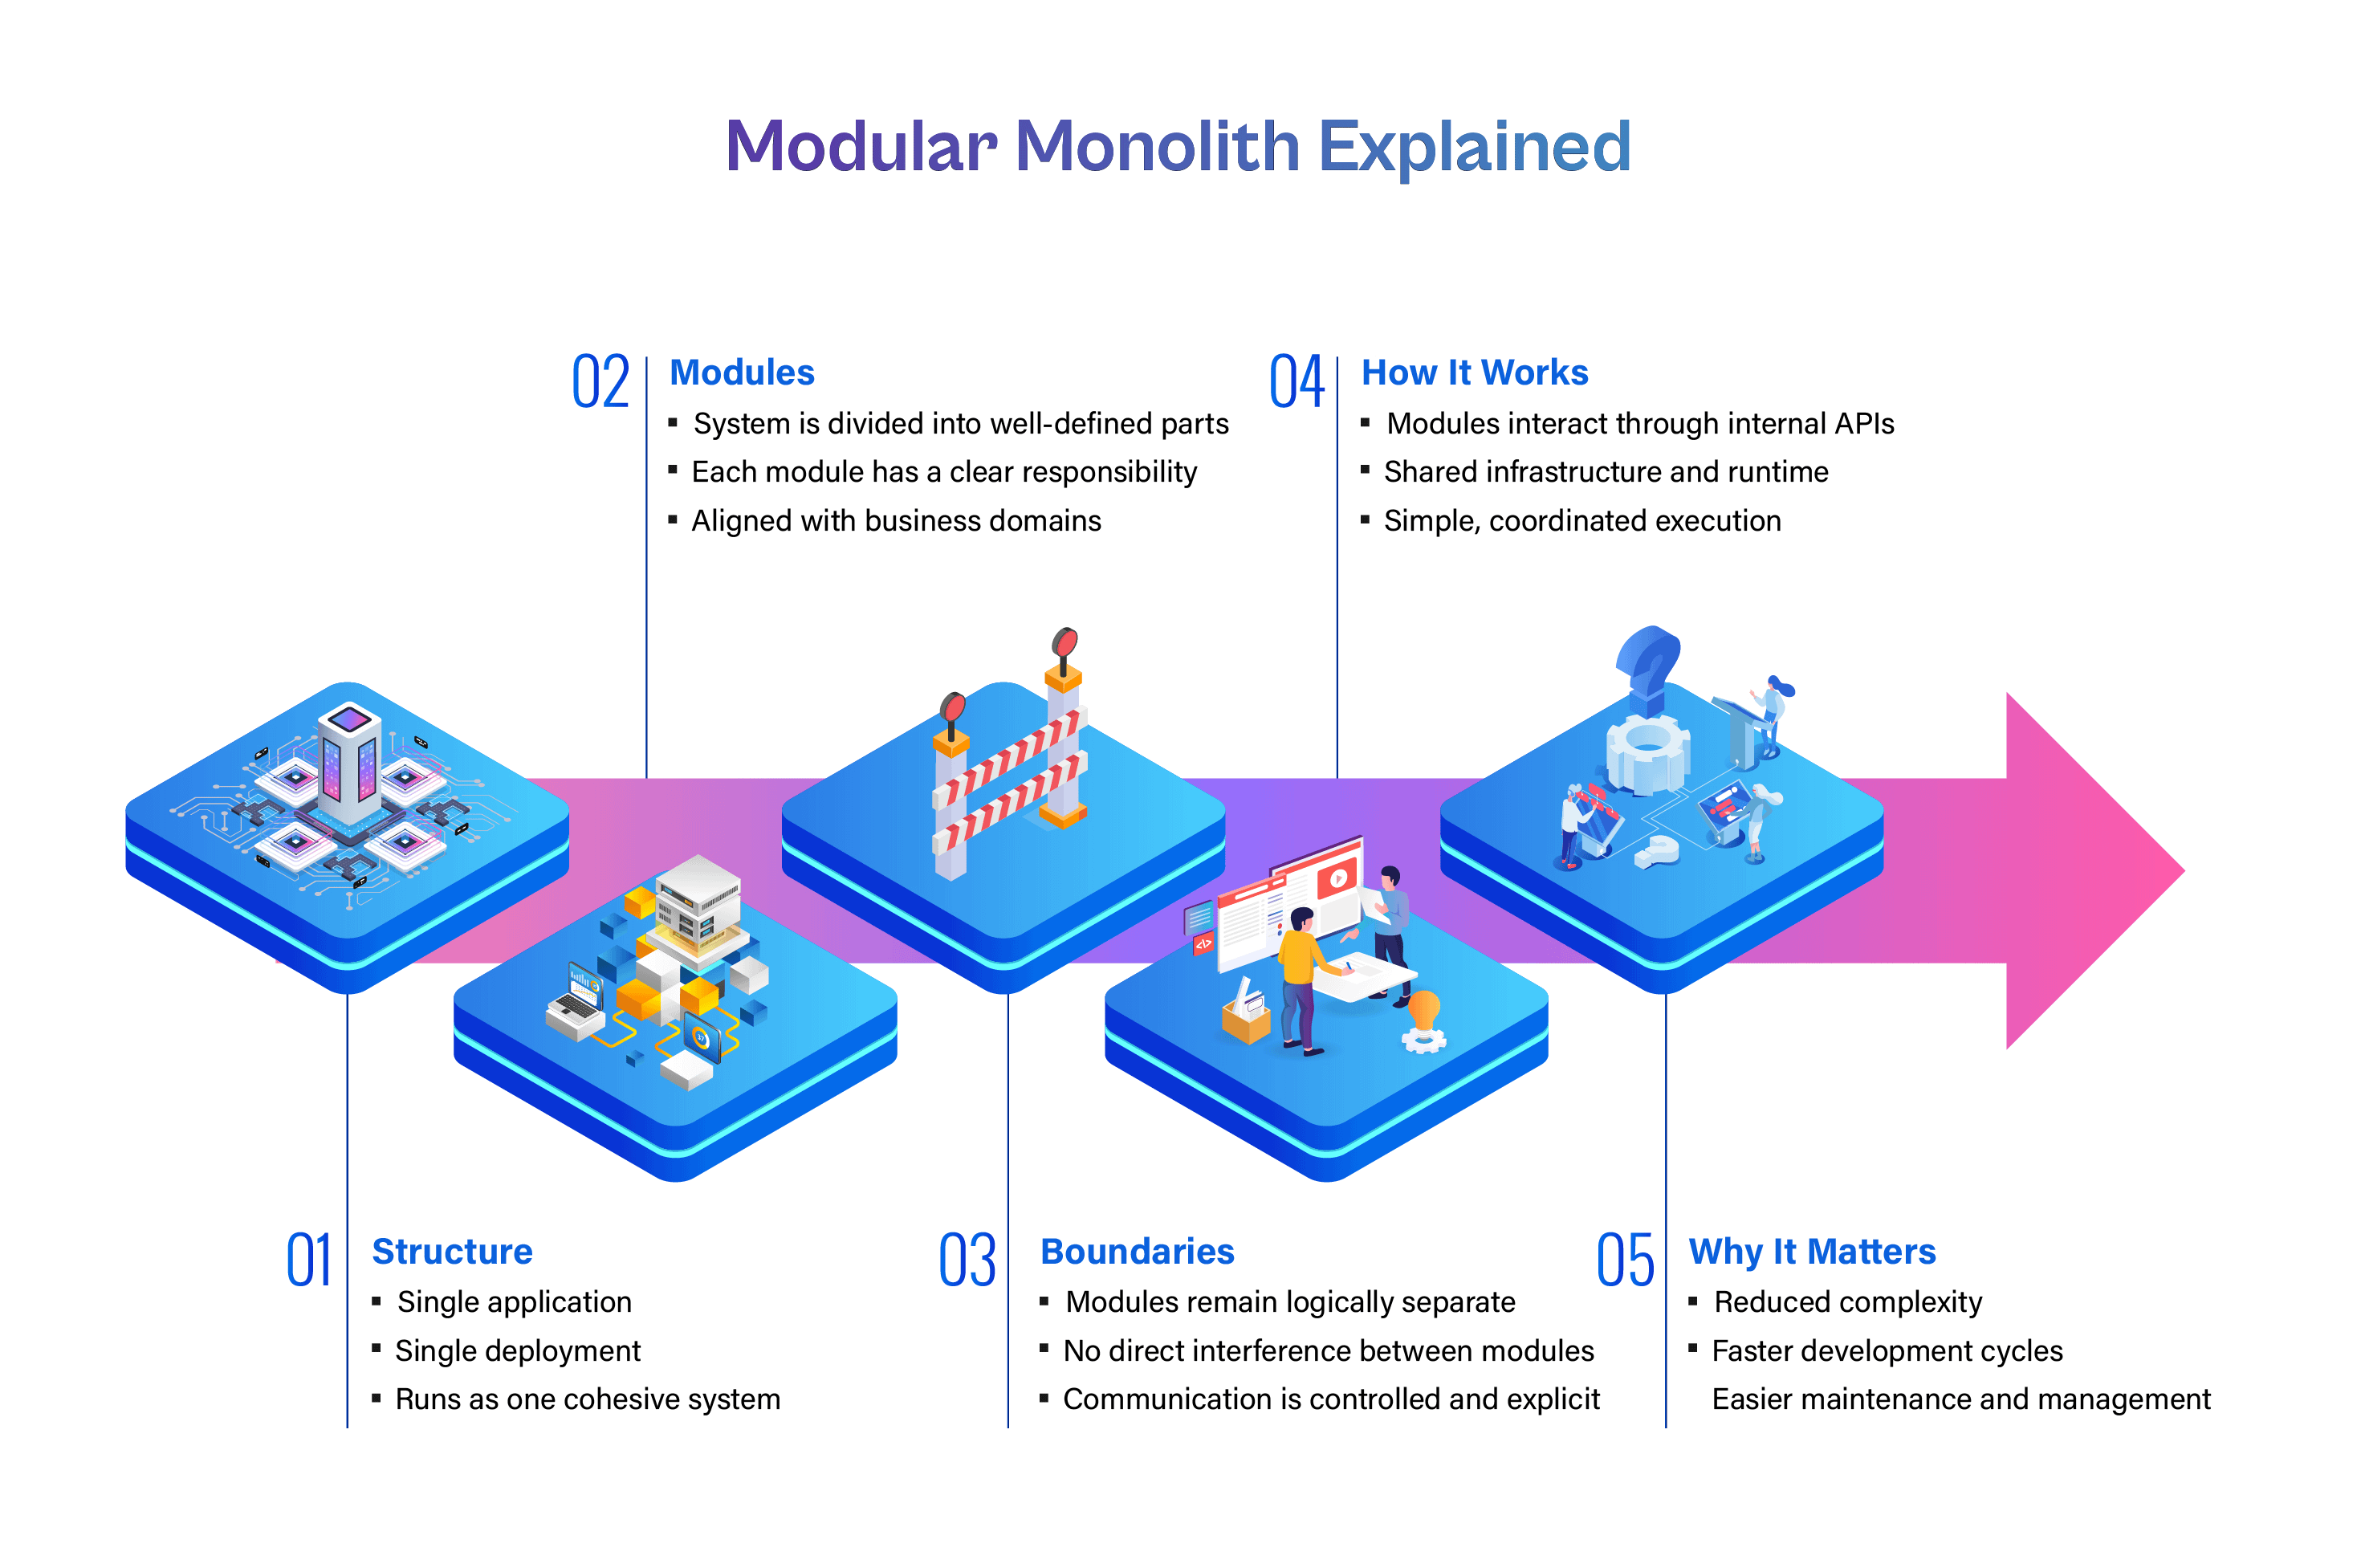
Según la información de configuración publicada en la documentación oficial, actualmente los desarrolladores pueden acceder a distintas capas de capacidad de la Computadora Ciega a través de tres interfaces principales. La API nilCC ofrece capacidades de computación privada en la dirección https://api.nilcc.nillion.network y también proporciona una especificación OpenAPI para que los desarrolladores consulten los detalles de la interfaz. La API nilAI se ejecuta en un TEE (entorno de ejecución confiable), en la dirección https://api.nilai.nillion.network, y se utiliza para escenarios de inferencia privada de LLM. El caso de nilDB es más complejo, ya que adopta un modelo de clúster descentralizado en el que los desarrolladores pueden conectarse a uno o varios nodos nilDB para almacenar y consultar datos tanto en texto sin formato como cifrados. La documentación oficial enumera las URL y las claves públicas específicas de varios nodos en la red principal y la red de prueba; por ejemplo, los nodos de prueba nildb-stg-n1 a n3 y los nodos de la red principal, entre ellos nildb-5ab1, nildb-f496, nildb-f375, nildb-2140, etc. Algunos nodos están operados por instituciones como Pairpoint, STC Bahrain y Deutsche Telekom MMS.
Al realizar la integración, los desarrolladores tienen dos opciones: usar el SDK secretvaults para conectarse a un clúster o interactuar directamente con nodos individuales mediante la API nilDB y la biblioteca blindfold. Esta flexibilidad permite que una aplicación decida, en función de la sensibilidad de los datos y los requisitos de rendimiento, si opta por la vía del clúster, que ofrece garantías más sólidas de confianza distribuida, o por la vía de un solo nodo, que simplifica la invocación. La documentación oficial también señala específicamente que, al usar un clúster compuesto por dos o más nodos, los desarrolladores pueden basarse en el supuesto de «no colusión» entre los nodos, y no es necesario informar a ningún nodo del clúster sobre la identidad de los demás. Esto reduce aún más el riesgo de colusión entre los operadores de los nodos.
Desde una perspectiva más amplia, este enfoque de configuración de nodos y clústeres forma parte del modelo de confianza general de Nillion. Las bases de datos tradicionales almacenan toda la información en un solo lugar, por lo que una única brecha implica un compromiso total; en cambio, la Computadora Ciega divide los datos cifrados entre varios nodos, de modo que ninguno de ellos posee los datos completos. Así, el límite de seguridad pasa de «confiar en el operador» a «confiar en la criptografía y la distribución de los nodos». La documentación oficial afirma que la Computadora Ciega utiliza técnicas criptográficas avanzadas, como la computación multipartita segura (MPC), el cifrado homomórfico (HE) y los entornos de ejecución confiables (TEE), para operar directamente sobre datos cifrados. De este modo, el modelo de confianza pasa de «confía en nosotros tus datos» a «confía en la criptografía». Esta es la razón fundamental por la que importan la configuración de los nodos y la división en clústeres: no son simples parámetros técnicos, sino la infraestructura mediante la cual se implementa el modelo de confianza.
Para los desarrolladores que quieren empezar a crear, el primer paso suele ser visitar el portal unificado para desarrolladores, que integra la gestión del acceso a nilDB, nilCC y nilAI. Después de seleccionar el módulo deseado, basta con conectarse mediante las direcciones de los nodos o los puntos de acceso de API indicados en la documentación oficial para empezar a utilizar las capacidades de almacenamiento ciego o computación ciega. Cabe destacar que, en las configuraciones habituales, el clúster nilDB requiere al menos tres nodos para distribuir los fragmentos secretos y garantizar que ningún nodo individual pueda ver los datos originales. Esto significa que los desarrolladores deben tener en cuenta desde el principio del diseño la selección de nodos y la composición del clúster, en lugar de tratarlo como un complemento opcional después de la implementación.