Hace poco, mientras revisaba el caso técnico de NodeGhost de @Acurast, encontré un resultado de prueba bastante interesante.
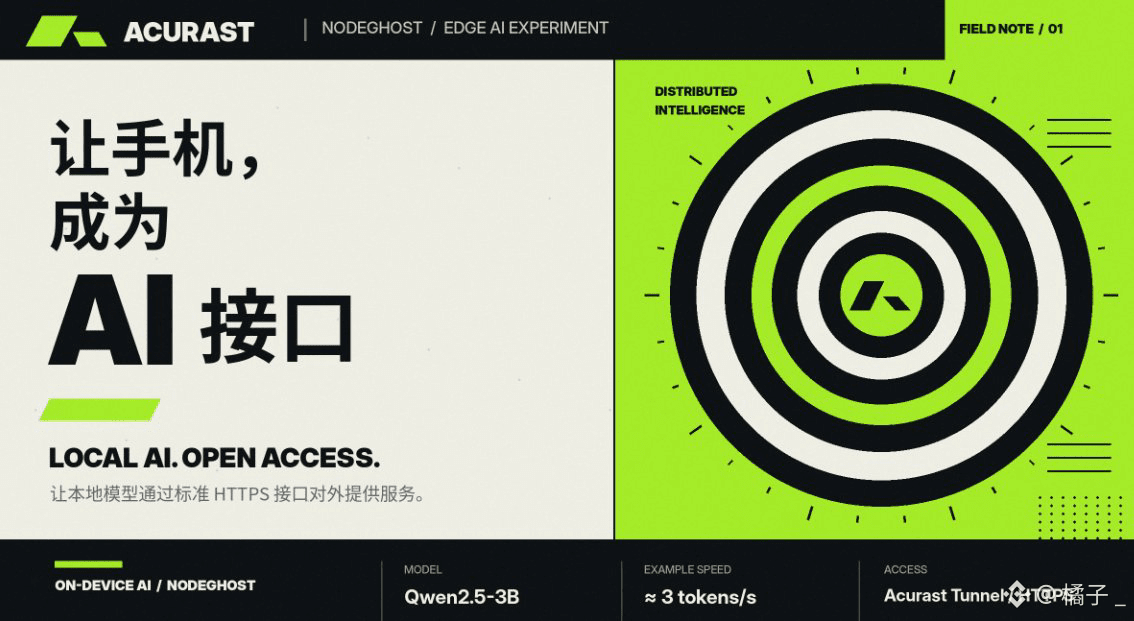
Un teléfono ejecuta el modelo cuantizado Qwen2.5-3B y genera alrededor de 3 tokens por segundo.
Responder una pregunta de unos 120 tokens requiere aproximadamente 45 segundos.
En comparación con la experiencia que ofrecen hoy los modelos grandes, esta velocidad sí que es algo lenta.
Pero lo que me llamó la atención de este caso fue otro aspecto del diseño.
Mediante Acurast Tunnel, un modelo que antes estaba oculto en el teléfono y no tenía una IP pública puede ofrecer una interfaz HTTPS al exterior.
Al conectarlo además a la API compatible con OpenAI de NodeGhost, los desarrolladores pueden enviar solicitudes para que se ejecuten en el teléfono sin apenas cambiar la forma en que ya las realizan.
Así, el teléfono deja de ser únicamente un Processor que espera pasivamente a que se le asignen tareas en la red y también puede ofrecer servicios estandarizados de inferencia de IA.
Por supuesto, este caso todavía es una implementación de referencia en la red Canary, y presenta limitaciones claras tanto de velocidad como de capacidad para el razonamiento complejo.
Pero creo que ya responde a una pregunta muy práctica:
Si un desarrollador quiere desplegar su propio modelo en teléfonos distribuidos, ¿pueden las aplicaciones existentes utilizarlo fácilmente?
Al menos, ya hay un ejemplo funcional de esta vía técnica.
En cuanto a la comercialización, todavía hay que seguir evaluando la latencia, la concurrencia, los costes y la estabilidad a largo plazo.
El token $ACU de Acurast se encarga de conectar el uso de la red con los incentivos de computación, pero para saber si conseguirá atraer demanda de pago, habrá que ver si estas aplicaciones son realmente competitivas.
Un teléfono ejecuta el modelo cuantizado Qwen2.5-3B y genera alrededor de 3 tokens por segundo.
Responder una pregunta de unos 120 tokens requiere aproximadamente 45 segundos.
En comparación con la experiencia que ofrecen hoy los modelos grandes, esta velocidad sí que es algo lenta.
Pero lo que me llamó la atención de este caso fue otro aspecto del diseño.
Mediante Acurast Tunnel, un modelo que antes estaba oculto en el teléfono y no tenía una IP pública puede ofrecer una interfaz HTTPS al exterior.
Al conectarlo además a la API compatible con OpenAI de NodeGhost, los desarrolladores pueden enviar solicitudes para que se ejecuten en el teléfono sin apenas cambiar la forma en que ya las realizan.
Así, el teléfono deja de ser únicamente un Processor que espera pasivamente a que se le asignen tareas en la red y también puede ofrecer servicios estandarizados de inferencia de IA.
Por supuesto, este caso todavía es una implementación de referencia en la red Canary, y presenta limitaciones claras tanto de velocidad como de capacidad para el razonamiento complejo.
Pero creo que ya responde a una pregunta muy práctica:
Si un desarrollador quiere desplegar su propio modelo en teléfonos distribuidos, ¿pueden las aplicaciones existentes utilizarlo fácilmente?
Al menos, ya hay un ejemplo funcional de esta vía técnica.
En cuanto a la comercialización, todavía hay que seguir evaluando la latencia, la concurrencia, los costes y la estabilidad a largo plazo.
El token $ACU de Acurast se encarga de conectar el uso de la red con los incentivos de computación, pero para saber si conseguirá atraer demanda de pago, habrá que ver si estas aplicaciones son realmente competitivas.